오픈코드를 위한 최고의 LLM - 로컬 테스트를 통한 Gemma 4부터 Qwen 3.6까지
OpenCode LLM 테스트 — 코딩 및 정확도 통계
로컬 호스팅된 Ollama 및 llama.cpp 기반 LLM들과 OpenCode가 어떻게 작동하는지 테스트해 보았습니다. 비교를 위해 OpenCode Zen의 일부 무료 모델도 추가했습니다.
OpenCode LLM 테스트 — 코딩 및 정확도 통계
로컬 호스팅된 Ollama 및 llama.cpp 기반 LLM들과 OpenCode가 어떻게 작동하는지 테스트해 보았습니다. 비교를 위해 OpenCode Zen의 일부 무료 모델도 추가했습니다.
시시포스와 그 전문 에이전트 팀을 소개합니다.
OpenCode 의 가장 큰 능력 향상은 전담 에이전트 (specialised agents) 에서 비롯됩니다: 오케스트레이션, 계획, 실행, 연구의 의도적인 분리입니다.
OpenHands CLI, 몇 분 만에 빠르게 시작하세요
OpenHands 는 AI 기반 소프트웨어 개발 에이전트를 위한 오픈소스, 모델 불특정 플랫폼입니다. 이 플랫폼은 에이전트가 단순한 자동 완성 도구가 아닌, 실제 코딩 파트너처럼 행동할 수 있도록 합니다.
분산형 로컬 AI 를 통해 OpenAI 호환 API 를 LocalAI 로 몇 분 안에 자체 호스팅하세요.
LocalAI 는 자신의 하드웨어 (노트북, 워크스테이션, 온프레미스 서버) 에서 AI 워크로드를 실행하기 위해 설계된 자체 호스팅, 로컬 우선 추론 서버로, OpenAI API 와의 호환성을 제공하여 기존 도구를 그대로 사용할 수 있도록 합니다.
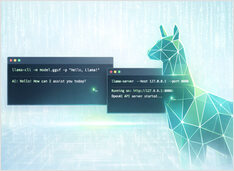
CLI 및 서버에서 GGUF 모델 실행하기
llama.cpp는 GGUF 모델용 C/C++ 추론 엔진입니다: 대화형 챗에는 llama-cli, 스크립트된 프롬프트에는 llama-completion, OpenAI 호환 HTTP API에는 llama-server를 제공합니다.
인공지능(AI)이 소프트웨어가 작성되고, 검토되고, 배포되며, 유지보수되는 방식을 재편하고 있습니다. AI 코딩 어시스턴트부터 GitOps 자동화 및 DevOps 워크플로우에 이르기까지, 개발자들은 이제 소프트웨어 전체 수명 주기에 걸쳐 AI 기반 도구에 의존하고 있습니다.
OpenCode 설치, 설정 및 사용법
OpenCode는 터미널(TUI + CLI)에서 실행할 수 있는 오픈소스 AI 코딩 에이전트로, 데스크톱 및 IDE 환경도 선택적으로 지원합니다. 이 글은 OpenCode 퀵스타트: 설치, 검증, 모델/프로바이더 연결, 실제 워크플로우(CLI + API) 실행에 대한 안내입니다.
프로미스스(Prometheus) 와 그라파나(Grafana) 를 활용한 LLM 모니터링
LLM 추론은 “단순한 또 하나의 API"처럼 보이지만, 지연 시간이 급증하고 대기열이 쌓이며 GPU 메모리가 95% 사용되는데도 명확한 원인을 파악할 수 없게 되면 상황이 달라집니다.
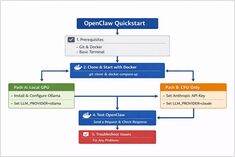
로컬에 Ollama를 사용하여 OpenClaw 설치
OpenClaw는 Ollama와 같은 로컬 LLM 런타임이나 Claude Sonnet과 같은 클라우드 기반 모델과 함께 실행하도록 설계된 셀프 호스팅(Self-hosted) AI 어시스턴트입니다.
OpenClaw AI 어시스턴트 가이드
대부분의 로컬 AI 환경은 동일한 방식으로 시작합니다. 모델, 런타임, 그리고 채팅 인터페이스가 그것입니다.
Temporal SDK를 사용하여 Go로 워크플로우 구축하기
LLM 추론 및 LLM 애플리케이션을 위한 종단간 가시성 전략
LLM 시스템은 전통적인 API 모니터링으로는 파악할 수 없는 방식으로 실패합니다. 큐가 조용히 가득 차고, GPU 메모리는 CPU가 바쁘게 보이기 훨씬 전에 포화 상태에 도달하며, 지연 시간은 애플리케이션 계층이 아닌 배치 처리 계층에서 급격히 증가합니다.
기본 RAG부터 프로덕션 환경까지: 청킹, 벡터 검색, 리랭킹 및 평가를 한 번에 정리한다.
프로덕션 시스템의 메트릭스, 대시보드, 로그 및 알림 — Prometheus, Grafana, Kubernetes 및 AI 워크로드
가시성(Observability)은 안정적인 프로덕션 시스템의 기초입니다.
메트릭스, 대시보드, 알림이 없으면 쿠버네티스 클러스터는 상태가 불안정해지고, AI 워크로드는 조용히 실패하며, 사용자가 불평하기 전까지는 지연 시간 regresion이 unnoticed 상태로 남게 됩니다.