GFM vs CommonMark vs Pandoc Markdown: confronto della sintassi

GFM vs CommonMark vs Pandoc Markdown: confronto della sintassi

Sapere quali funzionalità di Markdown vengono elaborate in modo sicuro

Sembra che Markdown sia una sola lingua, finché lo stesso file non viene renderizzato in modo diverso su GitHub, Hugo, Obsidian o Pandoc. E il problema non è che Markdown sia inaffidabile.
Data Gravity: il vero costo della AI API-First

Data Gravity: il vero costo della AI API-First

Perché il vostro stack AI diventa sempre più appiccicoso ogni mese.

Ogni chiamata API sembra una semplice transazione - finché non si accumulano abbastanza da far sì che i dati di fine-tuning, gli harness di valutazione e gli schemi degli strumenti siano tutti modellati attorno a un singolo vendor, e cambiare diventi altro che una modifica al routing.

Da Ollama a vLLM: quando migrare il proprio server LLM locale

Da Ollama a vLLM: quando migrare il proprio server LLM locale

Quando passare da Ollama a vLLM

Ollama è uno dei modi più semplici per eseguire un modello linguistico locale, ma la praticità può nascondere il momento in cui un esperimento locale diventa un servizio di inferenza condiviso che richiede una migliore pianificazione e osservabilità.

Mantenere allineati specifiche, test e codice nello sviluppo di AI

Mantenere allineati specifiche, test e codice nello sviluppo di AI

Impedisci agli agenti AI di allontanarsi dalle specifiche, dai test e dal codice.

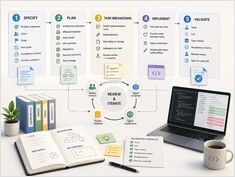
Gli agenti di coding AI rilasciano funzionalità rapidamente, ma specifiche, test e codice tendono a divergere silenziosamente. Questa guida illustra un modello di tracciabilità, il mapping da specifiche a test e da specifiche a codice, e i controlli CI che individuano queste divergenze prima del merge.

Dead Letter Queues: gestire i messaggi avvelenati nei sistemi distribuiti

Dead Letter Queues: gestire i messaggi avvelenati nei sistemi distribuiti

Blocca i messaggi tossici che impediscono l’elaborazione delle code

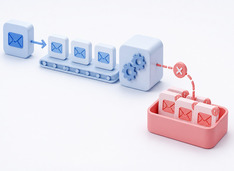
Una coda di messaggi non elaborati (Dead-Letter Queue) è la rete di sicurezza che intercetta i messaggi che i consumer non riescono a elaborare, così che un singolo payload corrotto non blocchi o scarti silenziosamente tutti i messaggi successivi nella coda.

Podman Quadlet vs Docker Compose per i servizi Linux

Podman Quadlet vs Docker Compose per i servizi Linux

Scegli il workflow dei container più adatto.

Docker Compose e Podman Quadlet risolvono problemi sovrapposti ma provengono da centri di progettazione diversi, e la scelta tra i due dipende dal fatto che si pensi in termini di stack di applicazioni o di servizi Linux.

GPU per l'IA nel 2026: NVIDIA, AMD e Intel confrontate

GPU per l'IA nel 2026: NVIDIA, AMD e Intel confrontate

Confronto delle GPU AI tra tre fornitori

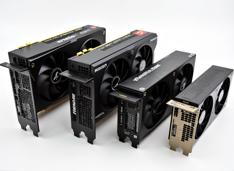
Il panorama dell’hardware per l’IA è cambiato significativamente nel 2026, con NVIDIA, AMD e Intel che competono per gli sviluppatori che necessitano di GPU in grado di eseguire localmente modelli linguistici di grandi dimensioni (LLM) e carichi di lavoro di inferenza IA.

GitHub Spec Kit vs Kiro vs Claude Code SDD Workflows

GitHub Spec Kit vs Kiro vs Claude Code SDD Workflows

Profondità di processo vs portabilità, non lo strumento migliore.

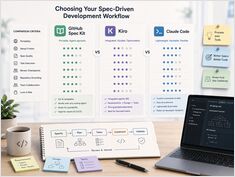
Gli sviluppatori che confrontano i setup di Spec-Driven Development nel 2026 di solito non si chiedono quale modello sia il più intelligente. Si chiedono quale flusso di lavoro terrà allineato un agente AI senza seppellirli sotto una montagna di rituali.

Sicurezza degli agenti A2A e MCP: identità, delega e audit trail

Sicurezza degli agenti A2A e MCP: identità, delega e audit trail

La sicurezza del protocollo riguarda chi può agire, non il modello.

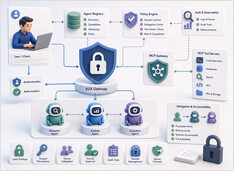
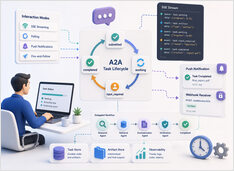
L’iniezione di prompt riceve la maggior parte dell’attenzione in termini di sicurezza nei sistemi LLM e merita attenzione, ma non è l’unico problema una volta che gli agenti iniziano a chiamare strumenti e a delegare il lavoro ad altri agenti.

Iscriviti

Ricevi nuovi articoli su sistemi, infrastruttura e ingegneria AI.