
Руководство по настройке размера контекста Docker Model Runner
Настройка размеров контекста в Docker Model Runner с обходными путями
Настройка размеров контекста в Docker Model Runner сложнее, чем должно быть.
Настройка размеров контекста в Docker Model Runner с обходными путями
Настройка размеров контекста в Docker Model Runner сложнее, чем должно быть.
Модель ИИ для дополнения изображений текстовыми инструкциями
Black Forest Labs выпустила FLUX.1-Kontext-dev, продвинутую модель искусственного интеллекта для преобразования изображений, которая дополняет существующие изображения с помощью текстовых инструкций.
Включите ускорение с помощью GPU для Docker Model Runner с поддержкой NVIDIA CUDA
Docker Model Runner — это официальный инструмент Docker для запуска моделей ИИ локально, но включение ускорения NVIDIA GPU в Docker Model Runner требует специальной настройки.
Сократите расходы на LLM на 80% с помощью умной оптимизации токенов
Оптимизация токенов — это ключевой навык, который отделяет экономически эффективные LLM-приложения от экспериментов, разоряющих бюджет.
Бенчмарки GPT-OSS 120b на трёх платформах ИИ
Я выкопал некоторые интересные тесты производительности GPT-OSS 120b, работающего на Ollama на трех разных платформах: NVIDIA DGX Spark, Mac Studio и RTX 4080. Модель GPT-OSS 120b из библиотеки Ollama весит 65ГБ, что означает, что она не помещается в 16ГБ видеопамяти RTX 4080 (или более новой RTX 5080).
Создавайте серверы MCP для ИИ-ассистентов с примерами на Python
Протокол Контекста Модели (MCP) революционизирует способ взаимодействия ИИ-ассистентов с внешними источниками данных и инструментами. В этом руководстве мы исследуем, как строить MCP-серверы на Python, с примерами, сосредоточенными на возможностях веб-поиска и парсинга.
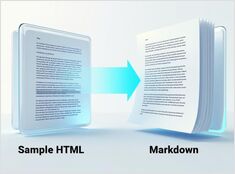
Python для преобразования HTML в чистый, готовый к использованию с LLM Markdown
Конвертация HTML в Markdown является фундаментальной задачей в современных рабочих процессах разработки, особенно при подготовке веб-контента для крупных языковых моделей (LLM), систем документации или статических генераторов сайтов, таких как Hugo. Это руководство является частью нашего Инструментов документации в 2026 году: Markdown, LaTeX, PDF и рабочие процессы печати хаба.
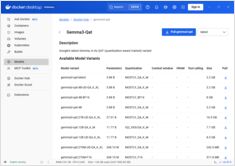
Быстрая справка по командам Docker Model Runner
Docker Model Runner (DMR) — это официальное решение Docker для запуска моделей ИИ локально, представленное в апреле 2025 года. Этот справочник предоставляет быстрый доступ ко всем основным командам, настройкам и лучшим практикам.
Сравните Docker Model Runner и Ollama для локальных LLM
Запуск больших языковых моделей (LLM) локально стал все более популярным из-за приватности, контроля затрат и возможностей офлайн-работы. Ландшафт значительно изменился в апреле 2025 года, когда Docker представил Docker Model Runner (DMR), свое официальное решение для развертывания моделей ИИ.
Специализированные интегральные схемы (ASIC) и кастомные чипы повышают скорость и эффективность работы LLM при инференсе.
Будущее ИИ заключается не только в более умных моделях. Оно также связано с кремнием, который соответствует тому, как эти модели фактически обслуживаются. Специализированное оборудование для инференса LLM движется по пути, напоминающему эволюцию майнинга биткоинов от GPU к цельным ASIC-устройствам, хотя ограничения здесь жёстче, поскольку модели и схемы точности продолжают развиваться.
Доступность, фактические розничные цены в шести странах и сравнение с Mac Studio.
NVIDIA DGX Spark действительно существует, поступил в продажу 15 октября 2025 года и ориентирован на разработчиков CUDA, которым необходима локальная работа с LLM в сочетании с интегрированным ИИ-стеком NVIDIA. Розничная цена в США составляет $3 999; цены для конечных потребителей в Великобритании, Германии и Японии выше из-за НДС и ценообразования канала продаж. Публичные розничные цены в AUD (Австралия) и KRW (Южная Корея) пока широко не представлены.
Сравнение скорости, параметров и производительности этих двух моделей
Вот сравнение Qwen3:30b и GPT-OSS:20b с акцентом на следовании инструкциям и параметрах производительности, спецификациях и скорости.
+ Конкретные примеры использования мыслящих ЛЛМ
В этой статье мы рассмотрим два способа подключения вашего Python-приложения к Ollama: 1. Через HTTP REST API; 2. Через официальную библиотеку Ollama для Python.
Не очень приятно.
Модели GPT-OSS от Ollama (https://www.glukhov.org/ru/llm-performance/ollama/ollama-gpt-oss-structured-output-issues/ “Ollama GPT-OSS”) постоянно сталкиваются с проблемами при работе со структурированным выводом, особенно при использовании с фреймворками вроде LangChain, OpenAI SDK, vllm и другими.
Незначительно отличающиеся API требуют особого подхода.
Вот сравнение поддержки структурированного вывода (получение надежного JSON) от популярных провайдеров LLM вместе с минимальными примерами на Python
Способы получения структурированного вывода от Ollama
Большие языковые модели (LLM) могут быть мощными инструментами, но в производственных системах мы редко хотим получать свободные текстовые параграфы. Вместо этого нам нужен предсказуемый формат данных: атрибуты, факты или структурированные объекты, которые можно передать в приложение. Об этом как раз и идет речь в статье Структурированный вывод LLM.