
Ограничение LLM структурированным выводом: Ollama, Qwen3 и Python или Go
Способы получения структурированного вывода от Ollama
Большие языковые модели (LLM) могут быть мощными инструментами, но в производственных системах мы редко хотим получать свободные текстовые параграфы. Вместо этого нам нужен предсказуемый формат данных: атрибуты, факты или структурированные объекты, которые можно передать в приложение. Об этом как раз и идет речь в статье Структурированный вывод LLM.
Принудительное соблюдение схемы (schema enforcement) снижает вероятность того, что некорректные вероятности (logits) приведут к недействительному JSON, но параметры температуры и штрафы (penalties) по-прежнему важны во избежание «шторма» повторных запросов; см. Параметры агентного инференса для Qwen и Gemma при совместном использовании ограничений format с агентами.
Слой сервисов по-прежнему нуждается в логике «разобрать — нормализовать — валидировать» — см. Валидация структурированного вывода LLM на Python, которая работает — потому что Ollama и клиентские приложения могут расходиться во мнениях относительно точных строк даже при установленном параметре format.
Некоторое время назад Ollama представила поддержку структурированного вывода (анонс), что позволяет ограничивать ответы модели в соответствии со схемой JSON. Это открывает возможности для создания последовательных конвейеров извлечения данных для задач, таких как каталогизация возможностей LLM, бенчмаркинг моделей или автоматизация системной интеграции.
В этом посте мы рассмотрим:
- Что такое структурированный вывод и почему это важно
- Простой способ получения структурированного вывода от LLM
- Как работает новая функция Ollama
- Примеры извлечения возможностей LLM:
Что такое структурированный вывод?
Обычно LLM генерируют свободный текст:
«Модель X поддерживает рассуждения с цепочкой мыслей, имеет контекстное окно в 200K токенов и работает с английским, китайским и испанским языками.»
Это читаемо, но трудно для парсинга.
Вместо этого, при использовании структурированного вывода, мы запрашиваем строгую схему:
{
  "name": "Model X",
  "supports_thinking": true,
  "max_context_tokens": 200000,
  "languages": ["English", "Chinese", "Spanish"]
}
Этот JSON легко валидировать, сохранять в базе данных или передавать в пользовательский интерфейс (UI).
Простой способ получения структурированного вывода от LLM
Иногда LLM понимают, что такое схема, и мы можем попросить LLM вернуть вывод в формате JSON, используя конкретную схему. Модель Qwen3 от Alibaba оптимизирована для рассуждений и структурированных ответов. Её можно явно инструктировать отвечать в формате JSON.
Пример 1: Использование Qwen3 с ollama на Python, запрос JSON со схемой
import json
import ollama

prompt = """
You are a structured data extractor.
Return JSON only.
Text: "Elon Musk is 53 and lives in Austin."
Schema: { "name": string, "age": int, "city": string }
"""

response = ollama.chat(model="qwen3", messages=[{"role": "user", "content": prompt}])
output = response['message']['content']

# Parse JSON
try:
    data = json.loads(output)
    print(data)
except Exception as e:
    print("Error parsing JSON:", e)
Вывод:
{"name": "Elon Musk", "age": 53, "city": "Austin"}
Принудительная валидация схемы с помощью Pydantic
Чтобы избежать некорректных выводов, можно валидировать данные по схеме Pydantic на Python.
from pydantic import BaseModel

class Person(BaseModel):
    name: str
    age: int
    city: str

# Suppose 'output' is the JSON string from Qwen3
data = Person.model_validate_json(output)
print(data.name, data.age, data.city)
Это обеспечивает соответствие вывода ожидаемой структуре.
Структурированный вывод в Ollama
Теперь в Ollama можно передавать схему в параметре format. Модель ограничивается ответом только в формате JSON, соответствующем схеме (документация).
В Python обычно определяют схему с помощью Pydantic и позволяют Ollama использовать её в качестве JSON-схемы.
Пример 2: Извлечение метаданных возможностей LLM
Допустим, у вас есть текстовый фрагмент, описывающий возможности LLM:
«Qwen3 имеет мощную поддержку многоязычности (английский, китайский, французский, испанский, арабский). Она позволяет делать шаги рассуждений (chain-of-thought). Контекстное окно составляет 128K токенов.»
Вы хотите получить структурированные данные:
from pydantic import BaseModel
from typing import List
from ollama import chat

class LLMFeatures(BaseModel):
    name: str
    supports_thinking: bool
    max_context_tokens: int
    languages: List[str]

prompt = """
Analyze the following description and return the model’s features in JSON only.
Model description:
'Qwen3 has strong multilingual support (English, Chinese, French, Spanish, Arabic).
It allows reasoning steps (chain-of-thought).
The context window is 128K tokens.'
"""

resp = chat(
    model="qwen3",
    messages=[{"role": "user", "content": prompt}],
    format=LLMFeatures.model_json_schema(),
    options={"temperature": 0},
)

print(resp.message.content)
Возможный вывод:
{
  "name": "Qwen3",
  "supports_thinking": true,
  "max_context_tokens": 128000,
  "languages": ["English", "Chinese", "French", "Spanish", "Arabic"]
}
Пример 3: Сравнение нескольких моделей
Введите описания нескольких моделей и извлечите их в структурированную форму:
from typing import List

class ModelComparison(BaseModel):
    models: List[LLMFeatures]

prompt = """
Extract features of each model into JSON.

1. Llama 3.1 supports reasoning. Context window is 128K. Languages: English only.
2. GPT-4 Turbo supports reasoning. Context window is 128K. Languages: English, Japanese.
3. Qwen3 supports reasoning. Context window is 128K. Languages: English, Chinese, French, Spanish, Arabic.
"""

resp = chat(
    model="qwen3",
    messages=[{"role": "user", "content": prompt}],
    format=ModelComparison.model_json_schema(),
    options={"temperature": 0},
)

print(resp.message.content)
Вывод:
{
  "models": [
    {
      "name": "Llama 3.1",
      "supports_thinking": true,
      "max_context_tokens": 128000,
      "languages": ["English"]
    },
    {
      "name": "GPT-4 Turbo",
      "supports_thinking": true,
      "max_context_tokens": 128000,
      "languages": ["English", "Japanese"]
    },
    {
      "name": "Qwen3",
      "supports_thinking": true,
      "max_context_tokens": 128000,
      "languages": ["English", "Chinese", "French", "Spanish", "Arabic"]
    }
  ]
}
Это делает бенчмаркинг, визуализацию или фильтрацию моделей по их возможностям тривиально простыми.
Пример 4: Автоматическое обнаружение пропусков
Можно даже разрешить значения null, если поле отсутствует:
from typing import Optional

class FlexibleLLMFeatures(BaseModel):
    name: str
    supports_thinking: Optional[bool]
    max_context_tokens: Optional[int]
    languages: Optional[List[str]]
Это гарантирует, что схема останется валидной, даже если некоторые сведения неизвестны.
Преимущества, предостережения и лучшие практики
Использование структурированного вывода через Ollama (или любую другую систему, которая это поддерживает) предлагает множество преимуществ — но имеет и некоторые предостережения.
Преимущества
- Более сильные гарантии: Модель просится соответствовать JSON-схеме, а не свободному тексту.
- Более легкий парсинг: Можно напрямую использовать
json.loadsили валидацию с Pydantic / Zod, а не регекс или эвристики. - Эволюция на основе схем: Можно версионировать схему, добавлять поля (со значениями по умолчанию) и поддерживать обратную совместимость.
- Интероперабельность: Нижестоящие системы ожидают структурированных данных.
- Детерминированность (лучше при низкой температуре): Когда температура низкая (например, 0), модель с большей вероятностью строго следует схеме. В документации Ollama это рекомендуется.
Предостережения и типичные ошибки
- Несоответствие схемы: Модель все еще может отклоняться — например, пропустить обязательное свойство, изменить порядок ключей или включить дополнительные поля. Необходима валидация.
- Сложные схемы: Слишком глубокие или рекурсивные JSON-схемы могут запутать модель или привести к сбоям.
- Двусмысленность в промпте: Если ваш промпт неточен, модель может неправильно угадать поля или единицы измерения.
- Несоответствие между моделями: Некоторые модели могут лучше или хуже соблюдать структурированные ограничения.
- Ограничения по токенам: Сама схема увеличивает расход токенов в промпте или API-вызове.
Лучшие практики и советы (на основе блога Ollama и опыта)
- Используйте Pydantic (Python) или Zod (JavaScript) для определения схем и автоматической генерации JSON-схем. Это исключает ручные ошибки.
- Всегда включайте инструкции вроде «отвечай только в JSON» или «не включай комментарии или дополнительный текст» в свой промпт.
- Используйте temperature = 0 (или очень низкое значение) для минимизации случайности и максимизации соблюдения схемы. Ollama рекомендует детерминированность.
- Валидируйте и, при необходимости, используйте запасной вариант (например, повторный запрос или очистку данных), если парсинг JSON или валидация схемы завершаются ошибкой.
- Начните с более простой схемы, а затем постепенно расширяйте её. Не усложняйте изначально.
- Включайте полезные, но ограниченные инструкции об ошибках: например, если модель не может заполнить обязательное поле, пусть отвечает
null, а не опускает поле (если это позволяет ваша схема).
Пример на Go 1: Извлечение возможностей LLM
Вот простая программа на Go, которая запрашивает у Qwen3 структурированный вывод о возможностях LLM.
package main

import (
	"context"
	"encoding/json"
	"fmt"
	"log"

	"github.com/ollama/ollama/api"
)

type LLMFeatures struct {
	Name             string   `json:"name"`
	SupportsThinking bool     `json:"supports_thinking"`
	MaxContextTokens int      `json:"max_context_tokens"`
	Languages        []string `json:"languages"`
}

func main() {
	client, err := api.ClientFromEnvironment()
	if err != nil {
		log.Fatal(err)
	}

	prompt := `
  Analyze the following description and return the model’s features in JSON only.
  Description:
  "Qwen3 has strong multilingual support (English, Chinese, French, Spanish, Arabic).
  It allows reasoning steps (chain-of-thought).
  The context window is 128K tokens."
  `

	// Define the JSON schema for structured output
	formatSchema := map[string]any{
		"type": "object",
		"properties": map[string]any{
			"name": map[string]string{
				"type": "string",
			},
			"supports_thinking": map[string]string{
				"type": "boolean",
			},
			"max_context_tokens": map[string]string{
				"type": "integer",
			},
			"languages": map[string]any{
				"type": "array",
				"items": map[string]string{
					"type": "string",
				},
			},
		},
		"required": []string{"name", "supports_thinking", "max_context_tokens", "languages"},
	}

	// Convert schema to JSON
	formatJSON, err := json.Marshal(formatSchema)
	if err != nil {
		log.Fatal("Failed to marshal format schema:", err)
	}

	req := &api.GenerateRequest{
		Model:   "qwen3:8b",
		Prompt:  prompt,
		Format:  formatJSON,
		Options: map[string]any{"temperature": 0},
	}

	var features LLMFeatures
	var rawResponse string
	err = client.Generate(context.Background(), req, func(response api.GenerateResponse) error {
		// Accumulate content as it streams
		rawResponse += response.Response

		// Only parse when the response is complete
		if response.Done {
			if err := json.Unmarshal([]byte(rawResponse), &features); err != nil {
				return fmt.Errorf("JSON parse error: %v", err)
			}
		}
		return nil
	})
	if err != nil {
		log.Fatal(err)
	}

	fmt.Printf("Parsed struct: %+v\n", features)
}
Для компиляции и запуска этой программы на Go — допустим, у нас есть файл main.go в папке ollama-struct,
Нам нужно выполнить внутри этой папки:
# initialise module
go mod init ollama-struct
# pull all the dependencise
go mod tidy
# build & execute
go build -o ollama-struct main.go
./ollama-struct
Пример вывода
Parsed struct: {Name:Qwen3 SupportsThinking:true MaxContextTokens:128000 Languages:[English Chinese French Spanish Arabic]}
Пример на Go 2: Сравнение нескольких моделей
Вы можете расширить это для извлечения списка моделей для сравнения.
  type ModelComparison struct {
		Models []LLMFeatures `json:"models"`
	}

	prompt = `
	Extract features from the following model descriptions and return as JSON:

	1. PaLM 2: This model has limited reasoning capabilities and focuses on basic language understanding. It supports a context window of 8,000 tokens. It primarily supports English language only.
	2. LLaMA 2: This model has moderate reasoning abilities and can handle some logical tasks. It can process up to 4,000 tokens in its context. It supports English, Spanish, and Italian languages.
	3. Codex: This model has strong reasoning capabilities specifically for programming and code analysis. It has a context window of 16,000 tokens. It supports English, Python, JavaScript, and Java languages.

	Return a JSON object with a "models" array containing all models.
	`

	// Define the JSON schema for model comparison
	comparisonSchema := map[string]any{
		"type": "object",
		"properties": map[string]any{
			"models": map[string]any{
				"type": "array",
				"items": map[string]any{
					"type": "object",
					"properties": map[string]any{
						"name": map[string]string{
							"type": "string",
						},
						"supports_thinking": map[string]string{
							"type": "boolean",
						},
						"max_context_tokens": map[string]string{
							"type": "integer",
						},
						"languages": map[string]any{
							"type": "array",
							"items": map[string]string{
								"type": "string",
							},
						},
					},
					"required": []string{"name", "supports_thinking", "max_context_tokens", "languages"},
				},
			},
		},
		"required": []string{"models"},
	}

	// Convert schema to JSON
	comparisonFormatJSON, err := json.Marshal(comparisonSchema)
	if err != nil {
		log.Fatal("Failed to marshal comparison schema:", err)
	}

	req = &api.GenerateRequest{
		Model:   "qwen3:8b",
		Prompt:  prompt,
		Format:  comparisonFormatJSON,
		Options: map[string]any{"temperature": 0},
	}

	var comp ModelComparison
	var comparisonResponse string
	err = client.Generate(context.Background(), req, func(response api.GenerateResponse) error {
		// Accumulate content as it streams
		comparisonResponse += response.Response

		// Only parse when the response is complete
		if response.Done {
			if err := json.Unmarshal([]byte(comparisonResponse), &comp); err != nil {
				return fmt.Errorf("JSON parse error: %v", err)
			}
		}
		return nil
	})
	if err != nil {
		log.Fatal(err)
	}

	for _, m := range comp.Models {
		fmt.Printf("%s: Context=%d, Languages=%v\n", m.Name, m.MaxContextTokens, m.Languages)
	}
Пример вывода
PaLM 2: Context=8000, Languages=[English]
LLaMA 2: Context=4000, Languages=[English Spanish Italian]
Codex: Context=16000, Languages=[English Python JavaScript Java]
Кстати, qwen3:4b хорошо работает на этих примерах, так же как и qwen3:8b.
Лучшие практики для разработчиков на Go
- Установите temperature в 0 для максимального соответствия схеме.
- Валидируйте с помощью
json.Unmarshalи используйте запасной вариант, если парсинг завершится ошибкой. - Держите схемы простыми — глубоко вложенные или рекурсивные JSON-структуры могут вызывать проблемы.
- Позвольте опциональные поля (используйте
omitemptyв тегах структур Go), если ожидается отсутствие данных. - Добавьте повторные попытки (retries), если модель иногда выдает недействительный JSON.
Полный пример — Построение графика со спецификациями LLM (Пошагово: от структурированного JSON к таблицам сравнения)
- Определите схему для желаемых данных
Используйте Pydantic, чтобы вы могли (a) генерировать JSON-схему для Ollama и (b) валидировать ответ модели.
from pydantic import BaseModel
from typing import List, Optional

class LLMFeatures(BaseModel):
    name: str
    supports_thinking: bool
    max_context_tokens: int
    languages: List[str]
- Попросите Ollama вернуть только JSON в этой форме
Передайте схему в format= и снизьте температуру ради детерминированности.
from ollama import chat

prompt = """
Extract features for each model. Return JSON only matching the schema.
1) Qwen3 supports chain-of-thought; 128K context; English, Chinese, French, Spanish, Arabic.
2) Llama 3.1 supports chain-of-thought; 128K context; English.
3) GPT-4 Turbo supports chain-of-thought; 128K context; English, Japanese.
"""

resp = chat(
    model="qwen3",
    messages=[{"role": "user", "content": prompt}],
    format={"type": "array", "items": LLMFeatures.model_json_schema()},
    options={"temperature": 0}
)

raw_json = resp.message.content  # JSON list of LLMFeatures
- Валидация и нормализация
Всегда валидируйте перед использованием в продакшене.
from pydantic import TypeAdapter

adapter = TypeAdapter(list[LLMFeatures])
models = adapter.validate_json(raw_json)  # -> list[LLMFeatures]
- Постройте таблицу сравнения (pandas)
Преобразуйте валидированные объекты в DataFrame, который можно сортировать/фильтровать и экспортировать.
import pandas as pd

df = pd.DataFrame([m.model_dump() for m in models])
df["languages_count"] = df["languages"].apply(len)
df["languages"] = df["languages"].apply(lambda xs: ", ".join(xs))

# Reorder columns for readability
df = df[["name", "supports_thinking", "max_context_tokens", "languages_count", "languages"]]

# Save as CSV for further use
df.to_csv("llm_feature_comparison.csv", index=False)
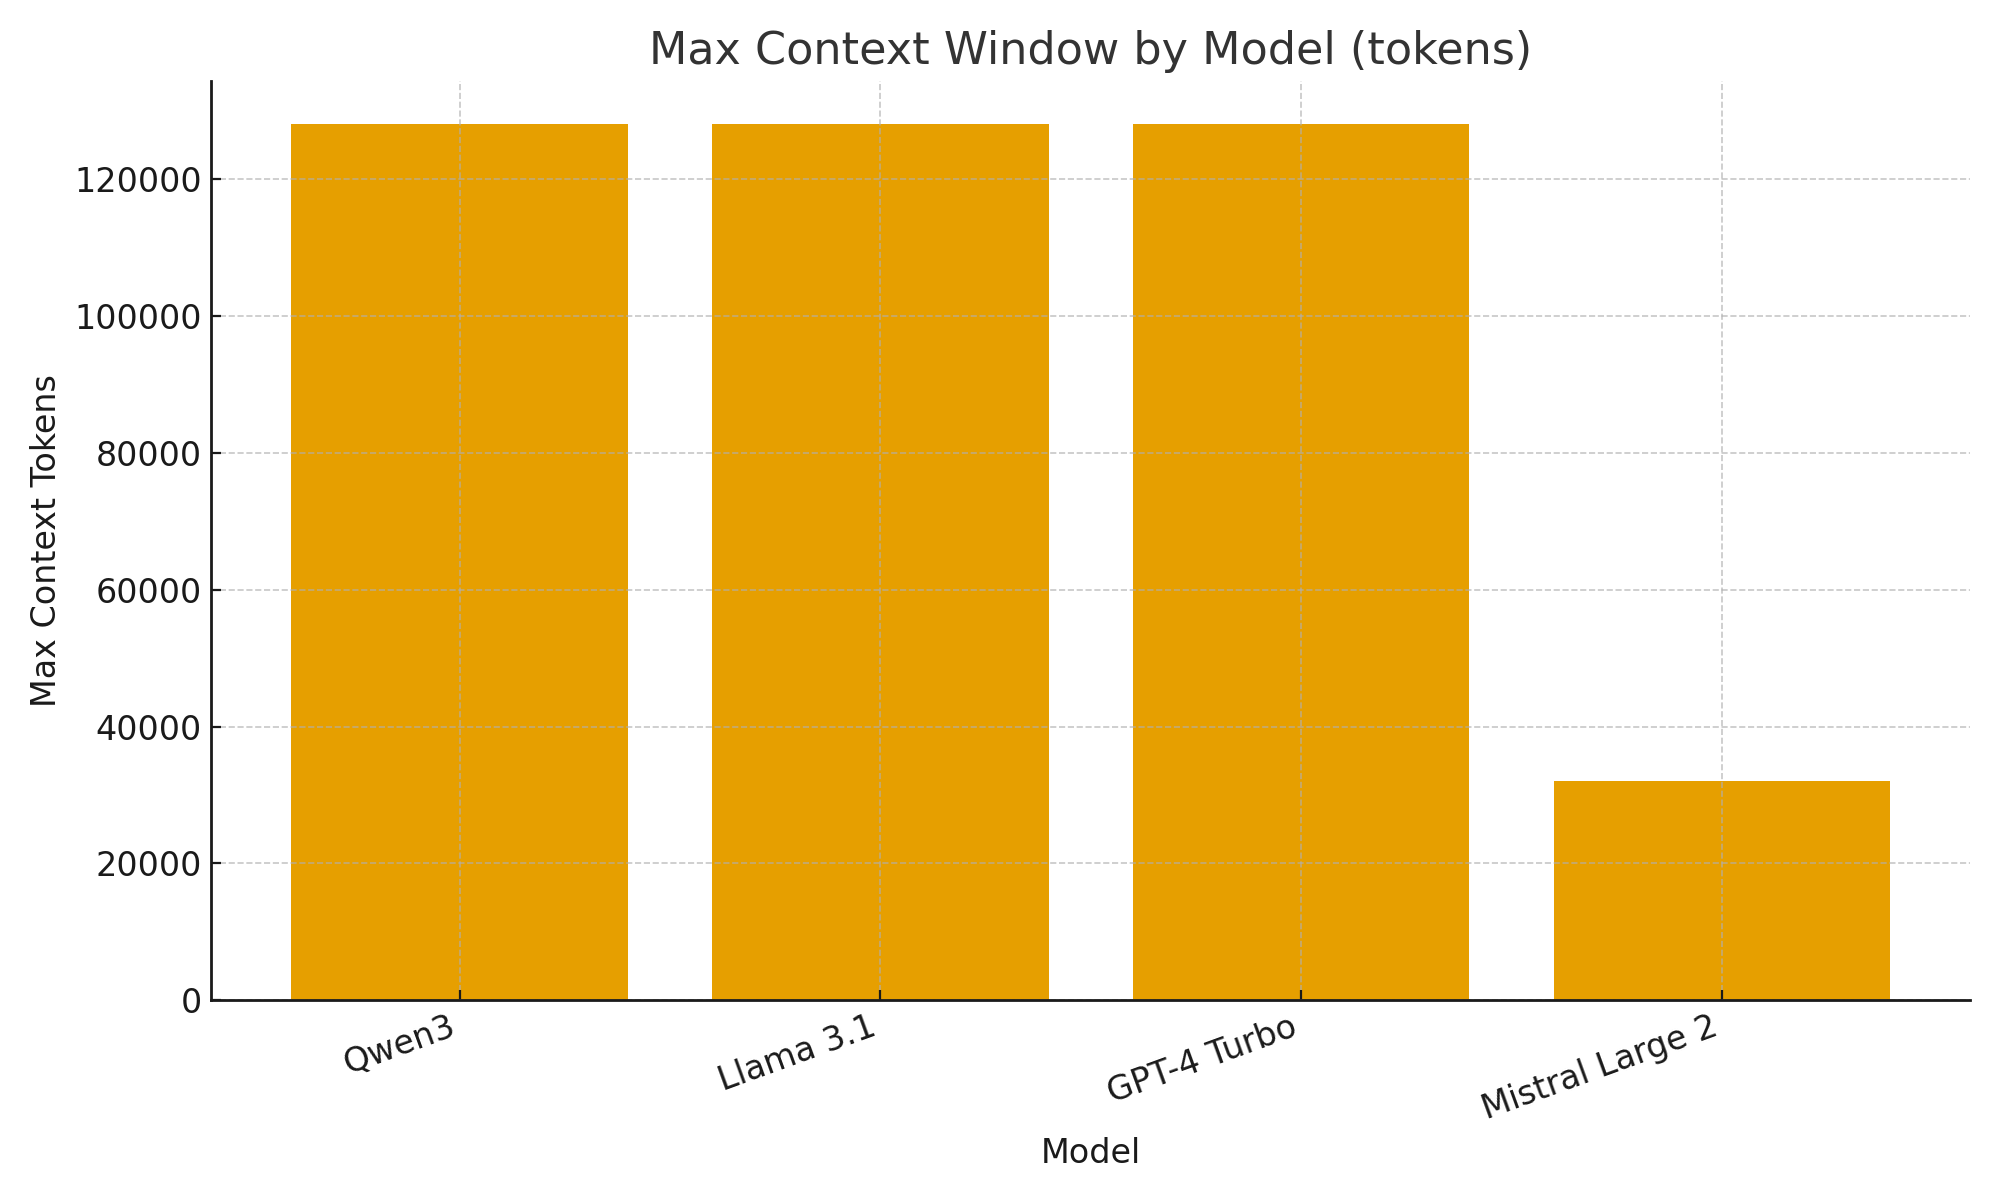
- (Опционально) Быстрая визуализация
Простые графики помогают быстро визуально оценить различия между моделями.
import matplotlib.pyplot as plt

plt.figure()
plt.bar(df["name"], df["max_context_tokens"])
plt.title("Max Context Window by Model (tokens)")
plt.xlabel("Model")
plt.ylabel("Max Context Tokens")
plt.xticks(rotation=20, ha="right")
plt.tight_layout()
plt.savefig("max_context_window.png")
Краткий итог (TL;DR)
Благодаря новой поддержке структурированного вывода в Ollama, вы можете использовать LLM не только как чат-боты, но и как двигатели извлечения данных.
Приведенные выше примеры показали, как автоматически извлекать структурированные метаданные о возможностях LLM, таких как поддержка рассуждений, размер контекстного окна и поддерживаемые языки — задачи, которые в противном случае потребовали бы хрупкого парсинга.
Независимо от того, строите ли вы каталог LLM-моделей, дашборд оценки или ИИ-ассистента для исследований, структурированный вывод делает интеграцию плавной, надежной и готовой к использованию в продакшене.
