AI

Быстрый старт vLLM: высокопроизводительный serving LLM — в 2026 году

Быстрый старт vLLM: высокопроизводительный serving LLM — в 2026 году

Установка, обслуживание и настройка vLLM в 2026 году

vLLM — это высокопроизводительный, энергоэффективный движок вывода и обслуживания для больших языковых моделей (LLM), разработанный лабораторией вычислений Sky Computing Лейденского университета Беркли (UC Berkeley).
Ценообразование на DGX Spark AU: от 6249 до 7999 долларов в крупных розничных магазинах

Ценообразование на DGX Spark AU: от 6249 до 7999 долларов в крупных розничных магазинах

Актуальные цены в австралийских долларах от местных розничных продавцов уже доступны.

Компьютер NVIDIA DGX Spark (GB10 Grace Blackwell) поступил в продажу в Австралии у крупных розничных продавцов компьютеров с наличием на местных складах. Если вы следите за мировым ценообразованием и доступностью DGX Spark, то вам будет интересно узнать, что в Австралии цены варьируются от 6 249 до 7 999 австралийских долларов в зависимости от конфигурации накопителей и конкретного продавца.

AI Slop: Признаки и Методы Обраружения

AI Slop: Признаки и Методы Обраружения

Техническое руководство по обнаружению контента, созданного с помощью ИИ

Распространение контента, созданного с помощью ИИ, создало новую проблему: различение подлинного человеческого текста и “AI slop” - низкокачественного, массово произведенного синтетического текста.

BAML против Instructor: структурированные выходные данные LLM

BAML против Instructor: структурированные выходные данные LLM

Type-safe LLM outputs with BAML and Instructor

При работе с большими языковыми моделями (LLM) в производственной среде получение структурированных и типобезопасных выходных данных имеет критическое значение. Два популярных фреймворка — BAML и Instructor — предлагают разные подходы к решению этой задачи.

Выбор правильного LLM для Cognee: локальная установка Ollama

Выбор правильного LLM для Cognee: локальная установка Ollama

Размышления об использовании больших языковых моделей для саморазмещаемого Cognee

Выбор лучшей LLM для Cognee требует баланса между качеством построения графов, уровнями галлюцинаций и ограничениями оборудования. Cognee лучше всего работает с крупными моделями с низким уровнем галлюцинаций (32B+) через Ollama, но средние варианты подходят для более легких настроек.

Шпаргалка по Jupyter Notebook

Шпаргалка по Jupyter Notebook

Основные сочетания клавиш и магические команды

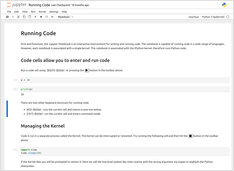
Поднять производительность работы в Jupyter Notebook - основные сочетания клавиш, магические команды и советы по работе, которые преобразуют ваш опыт в области отбработки данных и разработки.

Использование Ollama Web Search API в Python

Использование Ollama Web Search API в Python

Создайте ИИ-агенты для поиска с помощью Python и Ollama

Библиотека Ollama на Python теперь поддерживает нативные возможности веб-поиска Ollama. Всего несколько строк кода позволяют дополнить ваши локальные LLM актуальной информацией из интернета, что снижает количество галлюцинаций и повышает точность ответов.

Сравнение векторных хранилищ для RAG

Сравнение векторных хранилищ для RAG

Выберите правильную векторную базу данных для вашего стека RAG

Выбор правильного векторного хранилища может стать решающим фактором для производительности, стоимости и масштабируемости вашего приложения RAG. Это комплексное сравнение охватывает самые популярные варианты на 2024–2025 годы.

Использование Ollama Web Search API в Go

Использование Ollama Web Search API в Go

Создание ИИ-агентов для поиска с Go и Ollama

Веб-поисковый API Ollama позволяет дополнять локальные LLM актуальной информацией из интернета. В этом руководстве показано, как реализовать возможности веб-поиска на Go, от простых вызовов API до полнофункциональных поисковых агентов.

Резкий рост цен на оперативную память: до 619 % в 2025 году

Резкий рост цен на оперативную память: до 619 % в 2025 году

Цены на оперативную память выросли на 163–619% из-за дефицита, вызванного спросом на ИИ.

Рынок памяти переживает беспрецедентную волатильность цен в конце 2025 года, когда цены на оперативную память резко выросли по всем сегментам.

Ollama против vLLM и LM Studio: лучший способ запуска LLM локально в 2026 году?

Ollama против vLLM и LM Studio: лучший способ запуска LLM локально в 2026 году?

Сравнение лучших инструментов для локального развёртывания LLM в 2026 году. Зрелость API, поддержка аппаратного обеспечения, вызов инструментов и реальные сценарии использования.

Локальное запуск LLM-моделей сейчас становится практичным решением для разработчиков, стартапов и даже корпоративных команд. Но выбор правильного инструмента — Ollama, vLLM, LM Studio, LocalAI или других — зависит от ваших целей:

Микросервисы на Go для оркестрации AI/ML

Микросервисы на Go для оркестрации AI/ML

Создавайте надежные AI/ML-пайплайны с помощью микросервисов на Go

По мере усложнения рабочих нагрузок искусственного интеллекта (ИИ) и машинного обучения (МО) возрастает потребность в надежных системах оркестрации. Простота, производительность и возможности параллельного выполнения в Go делают его идеальным выбором для создания слоя оркестрации конвейеров машинного обучения, даже если сами модели написаны на Python.

Кросс-модальные вложения: объединение модулей ИИ

Кросс-модальные вложения: объединение модулей ИИ

Объедините текст, изображения и аудио в общих пространствах встраивания

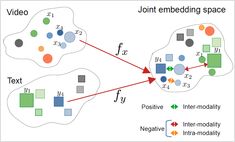
Кросc-модальные вложения представляют собой прорыв в искусственном интеллекте, позволяя понимать и анализировать различные типы данных в едином пространстве представления.

Инфраструктура искусственного интеллекта на потребительском оборудовании

Инфраструктура искусственного интеллекта на потребительском оборудовании

Развертывание корпоративного ИИ на бюджетном оборудовании с использованием открытых моделей.

Демократизация искусственного интеллекта уже здесь. С появлением открытых LLM, таких как Llama, Mistral и Qwen, которые теперь не уступают проприетарным моделям, команды могут создавать мощную инфраструктуру ИИ на потребительском оборудовании — значительно сокращая расходы при сохранении полного контроля над конфиденциальностью данных и развертыванием.