
Ретроспективная память для агента Hermes: локальная память с использованием локальных LLM
Персистентная память Hermes на вашем собственном оборудовании.
Самостоятельный ИИ-агент нуждается не только в большом окне контекста. Ему необходим механизм сохранения полезных фактов, извлечения принятых ранее решений и пересмотра своих знаний по мере эволюции проектов.
Hermes Agent поставляется со встроенными файлами памяти, но внешний провайдер может обеспечить гораздо более глубокое извлечение данных между сессиями. Hindsight — один из наиболее интересных вариантов в этой области. В этом руководстве описано его установка для Hermes без облачного инференса: сначала в виде контейнера Docker с полным набором функций (all-in-one), а затем в связке с существующим сервером PostgreSQL и отдельными локальными конечными точками моделей.
Руководство охватывает развертывание, выбор и подключение локальных моделей для эмбеддингов, переразметки (reranking) и генерации, управление тем, что функция auto-retain записывает в банк данных, подключение Hermes, а также операционный слой: резервное копирование, миграция и повседневное обслуживание банка данных. В примерах используется сознательная схема портов — 8080 для основного сервера llama.cpp, 8081 для эмбеддингов, 8082 для переразметки, 11434 для Ollama — поэтому замените их на порты, которые вы уже используете, и следите за тем, чтобы малые серверы не работали на порту основной модели.
Что делает Hindsight
Hindsight — это движок постоянной памяти агента с тремя основными операциями: retain (сохранение), recall (воспроизведение) и reflect (размышление). Retain извлекает и сохраняет информацию; recall комбинирует семантический, ключевой, графовый и временной поиск; reflect синтезирует ответ на основе накопленных воспоминаний. Фоновая консолидация может превращать перекрывающиеся наблюдения в более полезный слой знаний.
Это не просто база данных эмбеддингов. Векторное хранилище может находить похожие отрывки, но система памяти также должна сохранять хронологию, границы проектов, противоречивые доказательства и изменения в принятых решениях. Эти режимы отказа рассмотрены в статье Самозакрепляющиеся петли памяти.
Для обзора всего рынка см. Сравнение провайдеров памяти для агентов. Встроенные MEMORY.md, USER.md и режимы памяти Hermes описаны в руководстве Система памяти агента Hermes. В данной статье предполагается, что вы уже знаете, как работает встроенный слой.
Почему стоит перейти за пределы Mnemosyne
Mnemosyne для Hermes предлагает привлекательные идеи с локальным приоритетом, включая хранение в SQLite и гибридный поиск. На практике ограничения установки, совместимость версий, поведение при согласовании записи и частые изменения вокруг предварительных релизов 4.0 могут сделать его трудно предсказуемым в эксплуатации. Это операционные вопросы, а не доказательство того, что модель памяти Mnemosyne фундаментально дефектна.
Hindsight также не свободен от зависимостей: его образ Docker и локальные модели могут занимать значительное дисковое пространство. Запуск его API в качестве независимого сервиса, при этом инференс выполняется где-то еще, позволяет изолировать обновления и устранение неполадок от самого агента.
Выбор варианта развертывания
| Компонент | A: Все-в-одном контейнер | B: Существующий сервер PostgreSQL |
|---|---|---|
| API и UI Hindsight | Контейнер Docker | Контейнер Docker |
| PostgreSQL | Встроенный pg0 в контейнере |
Существующий сервер PostgreSQL |
| Генеративная LLM | Внешний llama.cpp | Внешний llama.cpp |
| Эмбеддинги | Локальные по умолчанию или внешние | Внешний Ollama или llama.cpp |
| Переразметка (Reranking) | Локальная по умолчанию или внешняя | Внешний сервер переразметки |
| Подходит для | Быстрой оценки | Долговременной, изолированной установки |
Здесь «все-в-одном» означает, что API, UI и база данных Hindsight находятся в одном контейнере; при этом генеративная LLM размещается отдельно. Это сделано осознанно: официальный образ Hindsight в Docker не содержит готового к использованию локального генеративного сервера llama.cpp.
Используйте адреса, доступные по локальной сети (LAN), а не localhost, для сервисов, работающих на другом хосте. Ограничьте эти порты доверенными клиентами; примеры ключей dummy являются совместимыми заглушками, а не аутентификацией.
Вариант A: All-in-One контейнер Hindsight
Это самый простой способ оценить Hindsight, не заполняя ВМ Hermes зависимостями Python, Torch и локальных моделей. Контейнер запускает Hindsight и встроенный PostgreSQL, тогда как ваша основная LLM llama.cpp обрабатывает извлечение памяти и рефлексия.
Здесь важны два тега образов. ghcr.io/vectorize-io/hindsight:latest — это большой образ — около 9 ГБ на AMD64 — потому что он включает эмбеддер BGE, реранкер MiniLM и встроенный PostgreSQL. latest-slim занимает около 500 МБ и предполагает, что эти две модели находятся где-то еще, что как раз то, что вам нужно, когда вы направляете Hindsight на настройку эмбеддингов и переразметки в разделе «Запуск и подключение локальных моделей». После того как проверка состояния пройдена, закрепите конкретный тег: движущийся тег плохо подходит для базы данных, которую вы намерены сохранять.
Создайте каталог и файл Compose на хосте Hindsight:
mkdir -p ~/services/hindsight
cd ~/services/hindsight
cat > compose.yaml <<'YAML'
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest
    container_name: hindsight
    restart: unless-stopped
    shm_size: 1gb
    extra_hosts:
      - "host.docker.internal:host-gateway"
    ports:
      - "8888:8888"  # Memory API
      - "9999:9999"  # Control-plane UI
    environment:
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://WORKSTATION_IP:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
    volumes:
      - hindsight-pg0:/home/hindsight/.pg0
volumes:
  hindsight-pg0:
YAML
Замените WORKSTATION_IP на хост, на котором работает llama.cpp. На Linux host.docker.internal разрешается только если контейнер объявляет отображение host-gateway, показанное выше; без него базовый URL http://host.docker.internal:8080/v1 никуда не указывает. Резервирование 1 ГБ общей памяти особенно полезно для индексации встроенного PostgreSQL; небольшой размер /dev/shm по умолчанию в Docker может вызывать сбои. Именованный том (named volume) сохраняет базу данных при пересоздании контейнера, а альтернатива в виде привязанного монтирования (bind mount) должна принадлежать uid 1000, пользователю внутри образа.
HINDSIGHT_API_WORKER_ID должен оставаться стабильным при пересоздании — по умолчанию в Docker используется имя хоста контейнера, и задача, которая была в процессе выполнения, когда контейнер умер, остается застрявшей под старым id воркера.
docker compose up -d
docker compose logs -f --tail=100
curl -f http://localhost:8888/health
Если ваша установленная версия Hindsight предоставляет health-check по другому пути, проверьте http://localhost:8888/docs и журналы контейнера. Панель управления обычно доступна по адресу http://HINDSIGHT_HOST:9999. После того как базовое развертывание заработает, вы также можете направить его провайдеры эмбеддингов и переразметки на конфигурацию из раздела «Запуск и подключение локальных моделей», а не загружать модели по умолчанию внутри контейнера.
Не выставляйте порты 8888 или 9999 напрямую в интернет. Используйте частную сеть или аутентифицируемый reverse-proxy. Встроенный PostgreSQL удобен для тестирования, но управляемая извне база данных легче резервируется и обслуживается.
Вариант B: Hindsight с существующим сервером PostgreSQL
Для долгосрочной установки я предпочитаю держать API Hindsight, базу данных и конечные точки инференса раздельными. ВМ Hindsight может оставаться небольшой, так как она запускает оркестрацию и HTTP-сервисы, а не тяжелые модели.
Подготовка PostgreSQL и pgvector
Для Hindsight необходим PostgreSQL 14 или новее и векторное расширение в базе данных hindsight. Расширение устанавливается для каждой базы данных: установка пакета на сервере не делает ничего, пока CREATE EXTENSION не выполнится в ней. На сервере PostgreSQL с Debian или Ubuntu установите пакет pgvector, соответствующий фактической основной версии PostgreSQL; например, для PostgreSQL 16:
sudo apt update
sudo apt install postgresql-16-pgvector
Имя пакета и его наличие зависят от ваших настроенных apt-репозиториев. Если он недоступен, следуйте инструкциям по установке pgvector или установите совместимый пакет из репозитория PostgreSQL PGDG. Не меняйте основную версию PostgreSQL на общесистемном сервере наугад.
Создайте отдельную роль и базу данных от имени администратора PostgreSQL:
CREATE ROLE hindsight LOGIN PASSWORD 'REPLACE_WITH_LONG_PASSWORD';
CREATE DATABASE hindsight OWNER hindsight;
Подключитесь к новой базе данных и активируйте расширение:
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS vector;'
sudo -u postgres psql -d hindsight -c \
  "SELECT extname, extversion FROM pg_extension WHERE extname = 'vector';"
Обычно для установки расширения требуются повышенные привилегии; приложению не нужна роль суперпользователя. Hindsight использует pgvector по умолчанию и требует версию 0.8.0 или новее для итеративных ANN-сканирований; старые серверы отклонят эту настройку. HINDSIGHT_API_VECTOR_EXTENSION может alternatively выбрать pgvectorscale (вариант DiskANN, который Hindsight документирует для очень больших банков) или vchord, оба из которых требуют дополнительного упаковки для этой конкретной сборки PostgreSQL. Переключение алгоритмов после того, как воспоминания уже существуют, останавливает запуск и запрашивает миграцию, поэтому выбирайте до первого сохранения. Для личного банка Hermes pgvector — это то, что нужно установить, а потом забыть.
Разрешите доступ только с хоста Hindsight через pg_hba.conf, например:
host hindsight hindsight 192.168.1.50/32 scram-sha-256
Настройте listen_addresses PostgreSQL соответственно и используйте TLS или доверенную частную сеть для межхостовых подключений. Резервируйте эту базу данных независимо от контейнера Docker Hindsight. Если сервер общий для других приложений, держите Hindsight в отдельной базе данных или установите HINDSIGHT_API_DATABASE_SCHEMA в схему, которой вы владеете; схема по умолчанию — public.
Запуск Hindsight с PostgreSQL
Создайте compose.yaml на ВМ Hindsight. Эта версия сознательно не запускает PostgreSQL локально:
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest-slim
    restart: unless-stopped
    ports:
      - "8888:8888"
      - "9999:9999"
    env_file: .env
    environment:
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://WORKSTATION_IP:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
      HINDSIGHT_API_DB_POOL_MIN_SIZE: "2"
      HINDSIGHT_API_DB_POOL_MAX_SIZE: "10"
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
Сохраните URL внешней базы данных в файле .env:
HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:YOUR_PASSWORD@POSTGRES_IP:5432/hindsight
chmod 600 .env
docker compose up -d
docker compose logs -f --tail=100
Если ваш пароль содержит @, :, / или другие зарезервированные символы URL, закодируйте его перед тем, как поместить в строку подключения. Проверьте, что ВМ Hindsight может достичь порта 5432 PostgreSQL, и что pg_hba.conf разрешает хост Hindsight — сервер, привязанный только к 127.0.0.1, отклонит соединение, даже если URL выглядит правильно. Дайте первому запуску время для выполнения миграций базы данных; миграции выполняются при запуске, если вы не установили HINDSIGHT_API_RUN_MIGRATIONS_ON_STARTUP=false. Когда API и база данных запущены, продолжайте с Выбор моделей для Hindsight и Запуск и подключение локальных моделей перед подключением Hermes.
Выбор моделей для Hindsight
Развертывание выводит API и базу данных в сеть. Следующее решение — какие модели заполняют три роли инференса: эмбеддинги для кандидатов в recall, реранкер для их пересортировки и генеративная LLM для retain, reflect и консолидации. Практичный вариант по умолчанию для CPU-хоста Hindsight, у которого GPU уже занят разговором, — это Qwen/Qwen3-Embedding-0.6B в процессе, BAAI/bge-reranker-v2-m3 в процессе и общая чат-модель llama.cpp для генеративных задач.
Модели эмбеддингов
Hindsight читает размерность эмбеддингов при запуске и настраивает банк под нее, поэтому модель, выбранная при первом сохранении, останется той, которую банк будет использовать, пока вы не перестроите его. Размерность и поведение инструкций важнее, чем место в рейтингах: более сильный 8B-эмбеддер не стоит миграции, если банк уже является 384- или 1024-размерным. Строки ниже отсортированы от самых легких к самым тяжелым; значения ОЗУ являются приблизительным занятым объемом на CPU (FP16 / типичная локальная загрузка), а не размером файла GGUF.
| Модель | Параметры | Размерность | Контекст | Загружено | Работает на | Примечания |
|---|---|---|---|---|---|---|
BAAI/bge-small-en-v1.5 |
33M | 384 | 512 | ~100–130 MB | CPU | По умолчанию в Hindsight; включен в hindsight:latest. Самый быстрый локальный путь. Распределение оценок все еще калибрует многие значения recall_min_scores по умолчанию после того, как вы от него отойдете. |
BAAI/bge-base-en-v1.5 |
109M | 768 | 512 | ~400 MB | CPU | Средний английский BGE; фиксирует банк 768 измерений. |
sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 |
~118M | 384 | 512 | ~200 MB | CPU | Документированный Hindsight мультиязычный MiniLM; 50+ языков при той же ширине банка 384 измерений, что и у BGE-small. |
intfloat/multilingual-e5-small |
~118M | 384 | 512 | ~200 MB | CPU | По умолчанию для провайдера onnx; легкий мультиязычный путь на CPU, если у вас есть экспорт ONNX. |
nomic-ai/nomic-embed-text-v1.5 |
~137M | 768 | 8k | ~500 MB | CPU | Частый эмбеддер в Ollama; длиннее контекст, чем у классических BGE, все же английский в приоритете. |
google/embeddinggemma-2 |
270M | 768 | 8k | ~540 MB | CPU | EmbeddingGemma 2 только текст (отключить башни зрения/аудио). 100+ языков + код; MRL усекает до 512/256/128; префиксы инструкций для поиска и документов. Полная мультимодальная загрузка — 740M. |
BAAI/bge-m3 |
568M | 1024 | 8k | ~1.1 GB | CPU или GPU | Сильный мультиязычный двухсторонний энкодер; та же ширина, что и у Qwen3-0.6B, поэтому замена при той же размерности все равно требует полного переэмбеддинга. |
Qwen/Qwen3-Embedding-0.6B |
0.6B | 1024 | 32k | ~1.2 GB | CPU | По умолчанию в этом руководстве. Учитывает инструкции (инструкция поиска на стороне запроса); комфортно работает на CPU. Локальный провайдер автоматически применяет инструкцию; серверам, совместимым с OpenAI, нужен HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX. |
Qwen/Qwen3-Embedding-4B |
4B | 2560 | 32k | ~8 GB FP16 / ~2.5 GB quant | GPU | Уровень качества Qwen3; фиксирует банк 2560 измерений. Неосуществим, если разговорное GPU уже загружено до предела. |
То, как запускается модель, — это вторая половина выбора. Провайдеры эмбеддингов Hindsight, от простейшего к варианту с наибольшим количеством движущихся частей:
| Провайдер | Как работает | Лучше всего когда | Примечания |
|---|---|---|---|
local |
SentenceTransformers в процессе; без сторонних сервисов | Один хост Hindsight, CPU-эмбеддер | Путь по умолчанию. Установите HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL. Без llama.cpp, Ollama или TEI. |
onnx |
ONNX Runtime в процессе | Легче на CPU, чем Torch; у вас уже есть экспорт ONNX | Требует hindsight-api-slim[local-onnx] и HINDSIGHT_API_EMBEDDINGS_ONNX_*. |
openai / tei |
Внешняя точка OpenAI-совместимая или HF TEI | Эмбеддинги вне процесса API; общий хост GPU/CPU | То, что настраивается в разделе «Запуск и подключение локальных моделей» для Ollama / llama.cpp / TEI. Стоит стороннего сервиса только если вы хотите изоляцию или другую машину. |
Qwen3-Embedding-0.6B не требует внешнего сервиса эмбеддингов. На CPU-хосте Hindsight он загружается в процесс API с провайдером local — Hugging Face скачивает веса при первом запуске, и провайдер сам применяет инструкцию поиска модели:
# Переменные окружения Compose (или эквивалентные ключи в .env)
HINDSIGHT_API_EMBEDDINGS_PROVIDER: local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL: Qwen/Qwen3-Embedding-0.6B
Используйте внешнюю точку, совместимую с OpenAI, только если вы хотите, чтобы эмбеддер находился на другой машине или вне процесса API. Ollama — один из таких хостов:
# Эмбеддинги: Qwen3-Embedding-0.6B на Ollama
HINDSIGHT_API_EMBEDDINGS_PROVIDER: openai
HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL: http://192.168.1.123:11434/v1
HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL: qwen3-embedding:0.6b-q8_0
HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY: dummy
Замените хост, порт и тег на то, что показывает ollama list на вашей машине инференса.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX зависит от провайдера:
| Путь | HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX |
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX |
|---|---|---|
local (Qwen/Qwen3-Embedding-0.6B) |
Оставьте пустым — провайдер в процессе сам применяет инструкцию поиска Qwen | Оставьте пустым |
| Внешний Ollama / llama.cpp / совместимый с OpenAI | Официальная инструкция поиска Qwen3 (реальная новая строка перед Query:) |
Оставьте пустым — сохраняемые воспоминания остаются чистым текстом |
| Сервер уже обертывает входные данные в шаблон Qwen | Оставьте оба пустыми — иначе инструкция применится дважды | Оставьте пустым |
Для внешнего пути установите:
# Реальная новая строка перед Query:. В Bash $'...' — надежный способ передачи.
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=
В YAML для Compose той же строке нужна явная \n (или литеральное многострочное значение). Установите префиксы перед первым сохранением: изменение их позже означает, что старые векторы и новые запросы больше не находятся в одном пространстве.
Два свойства решают больше, чем позиция в рейтинге. Чувствительность к инструкциям: эмбеддинги Qwen3 применяют инструкцию поиска на стороне запроса; без соответствующего префикса на сервере, совместимом с OpenAI, сторона хранения и сторона запроса перестают находиться в одном пространстве. Блокировка размерности: поскольку ширина читается один раз при запуске, переход от 0.6B к 4B позже — это миграция банка, а не изменение конфигурации — и даже замена при той же размерности (BGE-M3 ↔ Qwen3-0.6B, или EmbeddingGemma 2 ↔ nomic при 768) меняет векторное пространство, поэтому векторы банка не пересчитываются автоматически. Планируйте новый банк или ручное переэмбеддинг/пересоздание индекса; см. Экспорт, импорт и миграция банка памяти. После отхода от BGE-small проверьте recall_min_scores против нового распределения оценок — пороги, откалиброванные на BGE-small, могут быть слишком строгими для Qwen3-0.6B и лишать реранкер кандидатов. Для бенчмарков и информации о GGUF/Ollama для семейства Qwen3 см. Модели эмбеддингов и реранкеров Qwen3 в Ollama.
Модели переразметки (Reranking)
Эмбеддинги вспоминают набор кандидатов; реранкер оценивает каждую пару запроса/отрывка и пересортировывает его перед тем, как Hindsight вставит его. С провайдером local Hindsight загружает cross-encoder SentenceTransformers (или генеративный реранкер, где поддерживается). С внешней точкой, совместимой с Cohere, он отправляет полное тело в стиле Cohere на HINDSIGHT_API_RERANKER_COHERE_BASE_URL. Реранкер опционален, но как только эмбеддер зафиксирован, он обычно является самым большим рычагом качества recall — и, на CPU, часто большей частью времени wall-clock recall. Строки отсортированы от самых легких к самым тяжелым.
| Модель | Параметры | Тип | Контекст | Работает на | Примечания |
|---|---|---|---|---|---|
cross-encoder/ms-marco-MiniLM-L-6-v2 |
23M | Cross-encoder | 128 | CPU | По умолчанию в Hindsight; включен в hindsight:latest. Доля секунды для ~20 кандидатов. Оставьте как именованный запасной вариант, если более тяжелая модель BGE слишком медленная. |
cross-encoder/ms-marco-MiniLM-L-12-v2 |
~33M | Cross-encoder | 512 | CPU | То же семейство, более высокая точность; все же смещено в английский MS MARCO. |
cross-encoder/mmarco-mMiniLMv2-L12-H384-v1 |
~33M | Cross-encoder | 512 | CPU | Документированный Hindsight мультиязычный реранкер MiniLM. |
BAAI/bge-reranker-base |
278M | Cross-encoder | 512 | CPU | Умеренное обновление по сравнению с MiniLM; en/zh. Часто обсуждается; пропускается, когда v2-m3 уже укладывается в бюджет задержек. |
BAAI/bge-reranker-v2-m3 |
568M | Cross-encoder | 8k | CPU или GPU | Практичный мультиязычный вариант по умолчанию на CPU. На банке из ~500 воспоминаний, ~2.6–2.8 с на recall при пороге 20 кандидатов (~140 мс/кандидат; ~93–99% времени recall). Лимиты кандидатов 20/40/80; снижение порога с 20 → 10 примерно вдвое снижает стоимость реранкинга. |
Qwen/Qwen3-Reranker-0.6B |
0.6B | Генеративный (токен «да») | 32k | Рекомендуется GPU | Учитывает инструкции, длинный контекст. Не является drop-in cross-encoder: требует поддержки генеративных реранкеров в недавних версиях SentenceTransformers, и оценка /rerank в llama.cpp имеет известные баги с неверными оценками (hindsight-benchmarks#11). Провалидируйте перед внедрением. |
BAAI/bge-reranker-v2-gemma |
2.5B | Cross-encoder | 8k | Рекомендуется GPU | Сильное мультиязычное качество; избыточно для личного банка в несколько сотен воспоминаний, если GPU уже заполнено. |
Qwen/Qwen3-Reranker-4B |
4B | Генеративный | 32k | GPU | Более качественный кандидат Qwen; неосуществим без выделенной VRAM. |
Qwen/Qwen3-Reranker-8B |
8B | Генеративный | 32k | GPU | Верхний уровень семейства; те же оговорки генеративного оценивания, но еще больше. |
Облачные API-реранкеры (Cohere, ZeroEntropy, Alibaba qwen3-rerank, TypeSafe и подобные) работают в Hindsight, но отправляют тексты памяти за пределы устройства. Для локального междоменного расположения они выходят за рамки рассмотрения.
Два операционных ограничения доминируют в выборе. VRAM: если разговорная модель уже насыщает GPU (например, Qwen3.8-27B Q5 на карте на 16 ГБ без запаса), все строки «Рекомендуется GPU» отпадают, и живой выбор сводится к MiniLM или BGE-v2-m3 на CPU. Количество кандидатов: HINDSIGHT_API_RERANKER_MAX_CANDIDATES (30 в примере внешней точки ниже) ограничивает количество отрывков, которые модель переоценивает; каждый кандидат — это полный проход вперед, поэтому снижайте порог, прежде чем переходить на более высокий уровень модели. Для Qwen3 через llama.cpp GGUF должен сохранять голову ранжирования — старый convert_hf_to_gguf.py, который ее отбрасывает, оценивает все отрывки около нуля — и даже правильная конверсия все равно требует теста с известной хорошей/известной плохой парой, пока путь генеративного оценивания не будет подтвержден.
Уровни генеративных LLM
Модели эмбеддингов и переразметки не являются заменой генеративной LLM, используемой для извлечения и рассуждения о воспоминаниях. Hindsight поддерживает LLM по умолчанию и переопределения для конкретных операций, которые могут нацеливаться на тот же сервер llama.cpp или независимые точки.
| Операция Hindsight | Назначение | Практичный уровень модели | Примеры Qwen |
|---|---|---|---|
| Retain | Извлечение фактов, сущностей, решений и хронологии | Минимум 4B для тестов; предпочтительно 9B | Qwen3.5-4B / Qwen3.5-9B |
| Recall | Семантический, ключевой, графовый и временной поиск | Генеративная LLM не требуется | Qwen3-Embedding-0.6B + реранкер |
| Reflect | Ответ на вопросы путем синтеза извлеченных воспоминаний | От 9B до 27B+ | Qwen3.5-9B / Qwen3.8-27B |
| Консолидация | Согласование и сжатие связанных фактов | Предпочтительно 9B | Qwen3.5-9B / Qwen3.8-27B |
| Обновление ментальной модели | Обновление более долговременного синтезированного понимания | От 9B до 35B | Qwen3.5-9B / Qwen3.6-35B-A3B |
Это операционные рекомендации, а не официальные минимальные количества параметров Hindsight. Маленькая модель может правильно извлечь номер порта, но пропустить тот факт, что более раннее архитектурное решение было заменено. Надежность структурированного вывода и верная обработка отрицаний важнее, чем номинальное количество параметров само по себе. Собственные значения температуры по умолчанию в Hindsight стоит не менять — 0.1 для retain, 0.0 для консолидации, 0.9 для reflect — и для retain и консолидации стоит использовать не-размышляющий алиас, если ваша сборка llama.cpp его имеет, потому что маленькие чекпоинты Qwen3.5 тратят много токенов в режиме размышления.
Для развертывания с существующей точкой Qwen3.8-27B llama.cpp начните с ее общего использования для генеративных задач Hindsight с низкой конкурентностью:
HINDSIGHT_API_LLM_PROVIDER=openai
HINDSIGHT_API_LLM_BASE_URL=http://WORKSTATION_IP:8080/v1
HINDSIGHT_API_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_LLM_API_KEY=dummy
HINDSIGHT_API_LLM_MAX_CONCURRENT=2
HINDSIGHT_API_RETAIN_LLM_MAX_CONCURRENT=1
HINDSIGHT_API_CONSOLIDATION_LLM_MAX_CONCURRENT=1
Позже направьте рутинное извлечение на независимую модель 9B и зарезервируйте 27B для сложной рефлексии:
HINDSIGHT_API_RETAIN_LLM_PROVIDER=openai
HINDSIGHT_API_RETAIN_LLM_BASE_URL=http://MEMORY_LLM_HOST:8083/v1
HINDSIGHT_API_RETAIN_LLM_MODEL=MemoryLLM
HINDSIGHT_API_RETAIN_LLM_API_KEY=dummy

HINDSIGHT_API_REFLECT_LLM_PROVIDER=openai
HINDSIGHT_API_REFLECT_LLM_BASE_URL=http://WORKSTATION_IP:8080/v1
HINDSIGHT_API_REFLECT_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_REFLECT_LLM_API_KEY=dummy
Более маленькая модель 4B экономична, но требует тестирования; 9B — разумный компромисс между качеством и производительностью. Если retain и консолидация разделяют маленькую модель, снизьте HINDSIGHT_API_CONSOLIDATION_LLM_BATCH_SIZE до 2 — батч по умолчанию из 8 — это длинный промпт для маленького окна контекста. Qwen3.6-35B-A3B привлекателен для отдельного хорошо оборудованного сервера инференса (это модель смеси экспертов с примерно 3 миллиардами активных параметров, поэтому учитывайте его как маленькую активную модель), тогда как плотная модель 27B обычно не нужна для каждого рутинного события retain. Ограничение фоновой конкурентности защищает разговорную модель Hermes от всплесков обслуживания памяти.
Запуск и подключение локальных моделей
Если встроенные настройки эмбеддингов и реранкера local в разделе «Выбор моделей» достаточны, вы можете пропустить подразделы о внешнем Ollama и llama.cpp и перейти к подключению — или оставить Compose на значениях по умолчанию local, показанных там. Внешние точки важны, когда эмбеддер или реранкер должны находиться на другом хосте.
Внешние эмбеддинги: Ollama или llama.cpp
Внешние эмбеддинги нужны, когда вы хотите Qwen3-Embedding-0.6B (или другую модель) на отдельном хосте. Два практических варианта — это Ollama, который управляет получением и раздачей моделей с малой конфигурацией, и llama.cpp, который дает точный контроль над квантованием GGUF, потоками CPU, размещением на устройстве и батчингом. Фон и бенчмарки для обеих моделей Qwen3 в Моделях эмбеддингов и реранкеров Qwen3 в Ollama.
Qwen3-Embedding-0.6B возвращает 1024-размерные векторы, и Hindsight читает эту ширину при запуске и настраивает базу данных под нее. Банк, созданный с встроенной 384-размерной моделью BGE, не сможет принять эту модель — начните с пустой базы данных или тома, и решите модель эмбеддингов перед первым сохранением. Смена провайдера эмбеддингов позже требует переэмбеддинга сохраненных записей, даже если обе модели используют одинаковую размерность.
Вариант 1: Ollama для Qwen3-Embedding-0.6B
Установите Ollama на хосте инференса, используя его официальную документацию по установке на Linux, затем запустите модель эмбеддингов:
ollama pull qwen3-embedding:0.6b
ollama serve
Для удаленного доступа настройте OLLAMA_HOST=0.0.0.0:11434 в окружении службы Ollama, перезапустите службу и настройте файрвол на ВМ Hindsight — процедура описана в Удаленный доступ к Ollama. Демон, привязанный только к 127.0.0.1, невидим для контейнера Hindsight. Сначала проверьте имя модели с помощью ollama list, и протестируйте стандартную точку эмбеддингов:
curl http://EMBED_HOST:11434/api/embed \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding:0.6b","input":"A test memory"}'
Провайдер эмбеддингов OpenAI в Hindsight вместо этого вызывает OpenAI-совместимую точку /v1/embeddings Ollama. Убедитесь, что эта точка работает с вашей версией Ollama, прежде чем настраивать Hindsight. Ollama прост в использовании для эмбеддингов; не предполагайте, что его API предлагает совместимую точку переразметки. Для переразметки предпочитайте встроенный путь local BGE ниже или отдельную точку llama.cpp / TEI после того, как вы проверили оценки.
Вариант 2: llama.cpp для Qwen3-Embedding-0.6B
Скачайте проверенную GGUF-конверсию Qwen3-Embedding-0.6B. Используйте имя файла GGUF, которое вы фактически скачали:
#!/bin/sh
# start-embedding.sh - Только CPU сервер эмбеддингов
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8081 \
  --model "$HOME/ggufs/Qwen3-Embedding-0.6B-Q8_0.gguf" \
  --alias qwen3-embedding-0.6b \
  --embedding --pooling last \
  --ctx-size 4096 --parallel 1 \
  --threads 4 --threads-batch 4 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 0
Эмбеддинги Qwen3 используют пулинг последнего токена, в отличие от CLS-пулинга, используемого некоторыми моделями BGE. Сборка llama.cpp только для CPU предпочтительнее, если вы хотите абсолютно никакой инициализации CUDA на рабочей станции, где GPU занято большой разговорной моделью. Не включайте --reranking на этом сервере эмбеддингов: эта комбинация — известный способ получить вектор нулей.
curl -s http://EMBED_HOST:8081/v1/embeddings \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding-0.6b","input":"A test memory"}' \
  | jq '.data[0].embedding | length'
Полноразмерный вывод Qwen3-Embedding-0.6B должен содержать 1024 float’ов. Проверьте, что конверсия GGUF и обработка инструкций запроса/документа в вашем Hindsight совместимы; модели эмбеддингов, чувствительные к инструкциям, могут потерять точность при неверном промпте.
Реранкер: локальный BGE или Qwen3 через llama.cpp
Переразметка отличается от эмбеддингов: модель оценивает каждую пару запрос/документ и возвращает оценку релевантности. На хосте Hindsight только с CPU — или всегда, когда у разговорного GPU нет запасной VRAM — практичный путь — это провайдер local Hindsight с BAAI/bge-reranker-v2-m3 (или более легкий MiniLM по умолчанию). Сторонний сервис не требуется:
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20
Qwen3-Reranker-0.6B — это генеративный оценщик токена «да», а не классический cross-encoder. Его можно раздавать через llama.cpp с GGUF-конверсией, предназначенной для ранжирования, но относитесь к этому пути как к экспериментальному, пока вы не подтвердите оценки на известной хорошей/известной плохой паре: старый convert_hf_to_gguf.py, который отбрасывает голову ранжирования, оценивает все отрывки около нуля, и нативный путь /rerank в llama.cpp имеет известные сообщения о неверных оценках для этого семейства.
#!/bin/sh
# start-reranker.sh - GPU или CPU, как выбрано --n-gpu-layers
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8082 \
  --model "$HOME/ggufs/Qwen3-Reranker-0.6B-Q8_0.gguf" \
  --alias qwen3-reranker-0.6b \
  --embedding --reranking --pooling rank \
  --ctx-size 4096 --parallel 1 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 99
Установите --n-gpu-layers 0, чтобы запустить его на CPU. Версии для GPU требуют дополнительной VRAM для буферов вычислений и контекста, а не только для весов модели; избегайте предположения, что размер файла является общим выделением GPU.
curl -s http://RERANK_HOST:8082/v1/rerank \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-reranker-0.6b", "query":"PostgreSQL storage", "documents":["Hindsight stores memories in PostgreSQL.","A recipe for bread."], "top_n":2}' \
  | jq
Документ о PostgreSQL должен ранжироваться выше нерелевантного документа; оценки релевантности, равные нулю, означают, что GGUF — неправильная конверсия, и recall будет выглядеть случайным, даже если факты сохранены. Проверьте точную структуру results[].index и results[].relevance_score: Hindsight ожидает ответ переразметки, совместимый с Cohere, и совместимость llama.cpp может варьироваться от сборки к сборке.
Подключение точек к Hindsight
Добавьте следующие переменные окружения в сервис Hindsight в Compose, или сохраните их в его файле .env. Выберите один путь для эмбеддингов — встроенный local, Ollama или llama.cpp — никогда два одновременно.
# Вариант A: Встроенный Qwen3 на хосте Hindsight (CPU; без стороннего сервиса)
HINDSIGHT_API_EMBEDDINGS_PROVIDER=local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL=Qwen/Qwen3-Embedding-0.6B

# Вариант B: Сервис эмбеддингов llama.cpp
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://EMBED_HOST:8081/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding-0.6b
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BATCH_SIZE=8
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Вариант C: Ollama на другом хосте
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://192.168.1.40:11434/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding:0.6b-q8_0
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Вариант: Локальный реранкер BGE (без стороннего сервиса; предпочтителен на CPU)
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20

# Вариант: Точка переразметки llama.cpp, совместимая с Cohere (сначала проверьте оценки Qwen3)
# HINDSIGHT_API_RERANKER_PROVIDER=cohere
# HINDSIGHT_API_RERANKER_COHERE_BASE_URL=http://RERANK_HOST:8082/v1/rerank
# HINDSIGHT_API_RERANKER_COHERE_MODEL=qwen3-reranker-0.6b
# HINDSIGHT_API_RERANKER_COHERE_API_KEY=dummy
# HINDSIGHT_API_RERANKER_MAX_CANDIDATES=30
Имена переменных специфичны для провайдеров, и близкая неточность молча проигнорируется: HINDSIGHT_API_EMBEDDINGS_BASE_URL — неправильный ключ, и Hindsight тихонько нацелится на собственный endpoint эмбеддингов OpenAI, а не на ваш локальный сервер. Используйте HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL. С путем реранкера, совместимого с Cohere, Hindsight отправляет полное тело в стиле Cohere на HINDSIGHT_API_RERANKER_COHERE_BASE_URL; если журнал контейнера показывает 404 для /v1/rerank/rerank, ваша сборка добавляет /rerank сама, и значение должно заканчиваться на /v1.
Для вариантов B и C используйте значение HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX из раздела Модели эмбеддингов (вариант A оставляет его пустым). Тестируйте извлечение запроса-отрывка на ваших реальных воспоминаниях после первого сохранения.
Управление тем, что запоминается
Когда стек работает, следующим обычно является сбой пути записи: по умолчанию в Hermes auto_retain: true, поэтому каждый ход разговора может быть извлечен в банк. Неправильные догадки, отброшенные планы и экспериментальные утверждения становятся ищемыми фактами, и последующий recall относится к ним как к доказательствам — петля, описанная в Самозакрепляющиеся петли памяти. Политика захвата Hindsight среди других провайдеров обобщена в Сравнении провайдеров памяти для агентов.
Режимы захвата, существующие сегодня
| Режим | Настройки Hermes / Hindsight | Что вы получаете |
|---|---|---|
| Непрерывный | auto_retain: true, retain_every_n_turns: 1 |
Каждый ход сохраняется и извлекается |
| Пакетный авто | auto_retain: true, увеличьте retain_every_n_turns |
Меньше, но более крупные пакеты retain — все еще автоматически, а не очередь проверки |
| Только явный | auto_retain: false + инструмент hindsight_retain |
Хранение только когда агент вызывает инструмент (например, после вашей фразы “запомни это”) |
| Синтез сессии | hindsight_retain резюме в конце сессии, или банк reflect / консолидация |
Избранный ввод, если вы или агент дисциплинированно делаете вызов — не встроенный сброс для согласования |
Установка auto_retain в false отключает автоматическое хранение. Это не добавляет диалог согласия человека перед каждой записью. Агент все еще может вызвать hindsight_retain, когда его инструменты это разрешают; относитесь к явном retain как к осознанному захвату, а не к ожидающей очереди.
Отсутствие очереди согласования
Распространенное желание — это ожидающая очередь кандидатных воспоминаний, которые вы проверяете и одобряете перед их попаданием в банк. Hindsight под Hermes сегодня не предоставляет такой контракт. Mnemosyne для Hermes реализует этапные записи, специфичные для провайдера, в некоторых версиях; этот путь не является общим стандартом Hermes и не применяется к плагину Hindsight. Пока не появится вышестоящий поток согласования, рабочий шаблон — это auto_retain: false, сознательный hindsight_retain, и проверка или удаление в UI панели управления Hindsight, прежде чем следующая сессия будет полагаться на плохой факт. Не существует пропущенного ключа write_approval для Hindsight, который нужно искать в config.json.
Управление банком (миссии, метки, директивы, ментальные модели)
Люди часто называют следующий уровень «дообучением». В Hindsight это в основном конфигурация банка, а не только config.json Hermes: миссии и настройки извлечения направляют то, что retain сохраняет; метки структурируют сущности; директивы и ментальные модели формируют последующий синтез.
| Контроль | Где находится | Как помогает |
|---|---|---|
Миссия retain (retain_mission / Hermes bank_retain_mission) |
Конфигурация банка | Простая на языке человека инструкция «обращай внимание на X, игнорируй Y», внедряемая в извлечение |
Режим извлечения (concise, verbose, custom, …) |
Конфигурация банка | concise (по умолчанию) сохраняет факты, достойные долгосрочного хранения; custom заменяет встроенные правила через retain_custom_instructions |
| Метки сущностей | Конфигурация банка | Контролируемый словарь key:value во время retain → ссылки в графе и опциональные теги; улучшает структуру поиска, но сам по себе не отклоняет неправильные утверждения |
| Директивы («жесткие правила») | API директив банка | Явные инструкции, принудительно применяемые во время reflect (с охватом по тегам); ограничивают синтез, а не служат шлюзом согласования записи |
| Ментальные модели | API ментальных моделей банка | Постоянные ответы на повторяющиеся вопросы, обновляемые через reflect из соответствующих воспоминаний; производные, поэтому плохие исходные факты все еще отравляют их |
| Миссия reflect / наблюдений | Конфигурация банка | Направляет синтез и консолидацию, а не сырой поток retain |
Миссии, краткое извлечение и метки снижают шум и улучшают поиск. Они не заменяют отключение auto-retain, когда точность важнее полноты. Предпочитайте короткую миссию retain, которая называет устойчивые проектные решения и игнорирует логистику чата; добавляйте метки сущностей только когда у вас есть реальная таксономия; добавляйте ментальные модели для двух или трех повторяющихся вопросов после того, как банк уже содержит чистые факты.
Рекомендуемый профиль гигиены
Конкретная отправная точка для личного банка Hermes:
{
  "mode": "local_external",
  "api_url": "http://HINDSIGHT_VM_IP:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": false,
  "retain_async": true,
  "recall_prefetch_method": "recall"
}
В банке установите миссию retain и оставьте извлечение в режиме concise (через панель управления или API банков). После явного retain откройте UI, подтвердите наблюдение и удалите ошибки, прежде чем запустится консолидация или обновление ментальной модели. Оставьте recall_prefetch_method на recall — reflect тратит вызов чат-модели перед каждым ходом и вставляет синтез, а не базовые факты.
Подключение агента Hermes к Hindsight
На ВМ Hermes установите плагин из каталога, затем запустите мастер настройки. Выберите Hindsight и режим local_external; плагину не нужно запускать встроенный PostgreSQL или запускать стек моделей Hindsight локально, и local_embedded запустила бы второй демон Hindsight рядом с контейнером, который вы только что запустили.
hermes plugins install hindsight
hermes memory setup hindsight
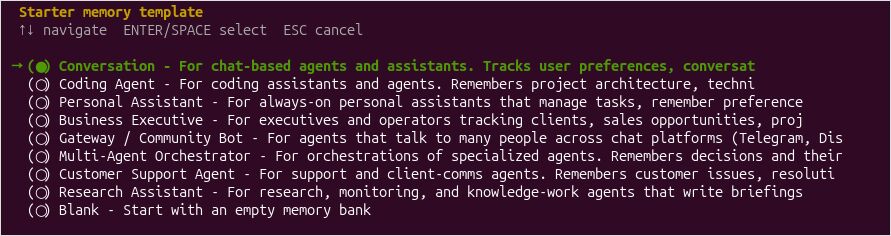
Будет интересный набор опций роли агента, использующего hindsight
hermes memory status
Внешнее соединение Hindsight находится в ~/.hermes/hindsight/config.json. Иллюстративная конфигурация, сохраняющая непрерывный захват (значения по умолчанию Hermes):
{
  "mode": "local_external",
  "api_url": "http://HINDSIGHT_VM_IP:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": true,
  "retain_async": true,
  "retain_every_n_turns": 1
}
Для явного только retain и управления банком используйте профиль гигиены из раздела Управление тем, что запоминается, вместо того чтобы оставлять auto_retain включенным. recall_sync: false приоритизирует интерактивную отзывчивость, но может вставить воспроизведенный контекст на следующем ходу. Используйте синхронный recall, когда текущий запрос должен включать самые последние воспоминания, прежде чем модель начнет отвечать. retain_async: true избегает блокирования обычных ответов, пока память обрабатывается.
По умолчанию воспроизведение плагина ограничено наблюдениями; сырые факты мира и опыта остаются в банке и вне промпта, пока консолидация не напишет наблюдение, или пока вы не расширите recall_types до observation,world,experience. Расширение на первую неделю и наблюдение за панелью управления, а затем сужение — разумный порядок.
Встроенная память Hermes остается активной рядом с провайдером; сохранение MEMORY.md и USER.md включенными, пока вы изучаете, что добавляет Hindsight, — это нормально, и статья о системе памяти — место, где решить, должны ли плоские файлы оставаться.
Перезапустите шлюз, если он уже запущен:
hermes gateway restart
hermes memory status
Статус должен идентифицировать Hindsight как активный провайдер. Для более широкой справки по командам, включая TUI Hermes и команды плагинов, см. Шпаргалку CLI агента Hermes.
Валидация памяти, а не только установки
Попросите Hermes запомнить одноразовый факт о тестовом проекте, начните другую сессию и попросите этот факт снова. Сохранение асинхронно по умолчанию, и извлечение ждет чат-модель, поэтому дайте основному серверу llama.cpp немного времени, прежде чем делать выводы. Затем протестируйте более сложный случай: сообщите Hermes, что более раннее решение изменилось, и спросите, какое решение актуально и почему. Проверьте UI Hindsight и сохраненные наблюдения, а не предполагать, что memory status доказывает правильность инжеста и воспроизведения.
Если ответ пустой, проверьте панель управления перед изменением моделей. Retain может увенчаться успехом, но оставаться невидимым для recall, пока recall_types ограничено наблюдениями и консолидация не запущена — расширение recall_types — первая проверка. Ошибка соединения в журнале сервера эмбеддингов означает, что контейнер не может достичь порта эмбеддингов, а оценки реранкера, равные нулю, означают, что GGUF — неправильная конверсия.
Выборы пути записи (auto_retain, миссии, отсутствие согласования) описаны в разделе Управление тем, что запоминается.
Устранение неполадок и операционные заметки
| Симптом | Вероятная причина | Первая проверка |
|---|---|---|
| Hermes говорит, что провайдер недоступен | Неправильный URL local_external или сетевое правило |
curl http://HINDSIGHT_VM_IP:8888/health |
| Docker запускается, ошибки PostgreSQL | Отсутствующее расширение, неверные учетные данные или недостаточная общая память | Журналы контейнера и pg_extension |
| Эмбеддинги возвращают 401 или 404 | Неправильный URL OpenAI-совместимый, неправильное имя ключа env или несоответствие алиаса модели | Прямой тест /v1/embeddings и имена переменных |
| Переразметка не работает | Несоответствие точки или формата ответа, включая удвоенный путь /rerank |
Прямой тест /v1/rerank и журнал контейнера |
| Recall не возвращает ничего полезного | recall_types ограничен наблюдениями, или оценки реранкера равны нулю |
Панель управления, затем recall_types, затем конверсия реранкера |
| Существующий банк сообщает о несоответствии размерности | Изменилась модель эмбеддингов | Пересоздание векторов/реимпорт с согласованной моделью |
| Ответы Hermes замедляются | Синхронный recall или конкурентность общей LLM | Отключите синхронный recall; ограничьте конкурентность retain |
| Нерелевантные воспоминания повторяются | Слабое извлечение, шумный поиск или недостаточная консолидация | Проверьте наблюдения и оценки релевантности |
Практичное небольшое развертывание — это 2-4 vCPU и 4-6 ГБ ОЗУ для ВМ API Hindsight при условии, что PostgreSQL и весь инференс внешние. Выделение диска все еще зависит от выбранного образа Docker и удерживаемых слоев образов; выделите примерно 30-40 ГБ изначально с запасом на расширение. Подбирайте размер хоста PostgreSQL на основе фактического объема памяти, производительности хранения и других баз данных, которые он обслуживает.
Резервное копирование и восстановление банка Hindsight
Банк памяти — единственное состояние, которое имеет значение, и он находится в PostgreSQL. В варианте B это база данных, которую вы администрируете; в варианте A это встроенный именованный том pg0 внутри контейнера. Резервируйте его независимо от контейнера Hindsight — пересоздание контейнера без предварительного захвата тома или базы данных приводит к утрате банка, и hermes backup не достигает банка, работающего в отдельном сервисе.
Вариант B — внешний PostgreSQL. Сделайте дамп базы данных hindsight в кастомном формате, затем восстановите его в временную базу данных, чтобы проверить архив, прежде чем ему доверять:
pg_dump -h POSTGRES_IP -U hindsight -Fc hindsight > hindsight-bank.dump

# восстановление во временную базу данных, чтобы доказать, что дамп пригоден
createdb -h POSTGRES_IP -U postgres hindsight-verify
pg_restore -h POSTGRES_IP -U postgres -d hindsight-verify hindsight-bank.dump
Убедитесь, что расширение pgvector и образец recall существуют в восстановленной копии, прежде чем удалять оригинал цели дампа. Храните дамп на другом хосте, чем ВМ Hindsight, и выполняйте это от имени администратора PostgreSQL (роли, которая может создавать базы данных), а не роли приложения.
Вариант A — все-в-одном контейнер. Встроенная база данных — это именованный том, поэтому остановите контейнер и запакуйте том через одноразовый образ:
docker stop hindsight
docker run --rm -v hindsight-pg0:/data -v "$PWD":/backup alpine \
  tar czf /backup/hindsight-bank.tgz -C /data .
docker start hindsight
Точка монтирования внутри tar-контейнера (/data) произвольна; она просто алиасит именованный том, чтобы tar мог читать его. Для восстановления остановите контейнер, очистите том и распакуйте архив обратно в него, или направьте контейнер на внешнее восстановление PostgreSQL из варианта B.
Снимайте снимок в три момента, а не по календарному расписанию: перед изменением модели эмбеддингов, перед основным обновлением Hindsight или PostgreSQL, и перед проходом reflect или консолидации, который перезаписывает банк. Резервная копия, которую вы восстановили во временный банк, стоит больше, чем та, которую вы только записали.
Экспорт, импорт и миграция банка памяти
Резервное копирование и восстановление защищают банк на месте. Экспорт/импорт перемещает его между экземплярами Hindsight, и именно это изменение модели на самом деле заставляет вас делать.
Изменение модели эмбеддингов — это не правка конфигурации. Векторы в банке были вычислены старой моделью, и другая модель — например, встроенный 384-размерный эмбеддер BGE против 1024-размерного Qwen3-Embedding-0.6B — записывает в другое пространство и обычно другую ширину. Вы не можете перенаправить существующий экземпляр на новый эмбеддер и сохранить старые векторы; размеры должны быть пересчитаны путем переэмбеддинга каждого воспоминания новой моделью эмбеддингов.
Поскольку эмбеддер и его конфигурация задаются для каждого экземпляра Hindsight, чистый путь — это развернуть новый экземпляр с новой конфигурацией эмбеддингов и мигрировать в него банк, а не перестраивать векторы внутри того, который уже обслуживает recall. API Hindsight может перемещать банк тоже, но для разового изменения экспорт/импорт — более простой и проверяемый путь:
# экспорт банка из старого экземпляра
docker exec hindsight \
  hindsight-admin export-bank \
    --bank hermes2 \
    --output /tmp/hermes2.zip

docker cp hindsight:/tmp/hermes2.zip ./hermes2.zip

ls -lh hermes2.zip
unzip -t hermes2.zip

# импорт банка в новый экземпляр
docker cp ./hermes2.zip hindsight-q06:/tmp/hermes2.zip

docker exec hindsight-q06 \
  hindsight-admin import-bank \
    --archive /tmp/hermes2.zip
unzip -t проверяет архив перед тем, как вы отправляете его в новый экземпляр. После импорта перенаправьте Hermes на api_url нового экземпляра в ~/.hermes/hindsight/config.json, перезапустите шлюз и выполните валидацию памяти, описанную ранее: сохраненный факт должен воспроизводиться через новый эмбеддер. Оставьте старый банк и его векторы в старом экземпляре, пока новый не заработает, чтобы у вас все еще был работающий запасной вариант.
Мониторинг, чистка и сохранение стабильности банка
Когда банк работает, ежедневная работа — это наблюдение за тем, что модель извлечения решила сохранить, и поддержание производного состояния под контролем. Используйте UI панели управления (hindsight-embed -p hermes ui start), чтобы проверить наблюдения, оценки релевантности и вывод консолидации, а не предполагать, что memory status доказывает правильность инжеста и воспроизведения. Дублированные или устаревшие воспоминания обычно являются результатом слабого извлечения или недоделанной консолидации, поэтому исправьте уровень извлечения или частоту консолидации, прежде чем расширять поиск.
Две ловушки обслуживания стоит протестировать, прежде чем полагаться на банк. Во-первых, удаление наблюдения не гарантирует исчезновение всех производных представлений — факт reflect или ребро графа, построенное из него, может пережить удаление, поэтому проверяйте удаление от начала до конца, та же проблема происхождения, описанная в Самозакрепляющиеся петли памяти. Во-вторых, держите HINDSIGHT_API_WORKER_ID стабильным при пересоздании и закрепляйте конкретный тег образа: задача, которая была в процессе выполнения, когда контейнер умер, остается застрявшей под старым id воркера, а движущийся тег плохо подходит для базы данных, которую вы намерены сохранять.
