
知識システムにおける「検索」と「表現」
検索は知識構造ではない
最新の知識システムのほとんどは検索(Retrieval)を最適化しています。それは理解できることです。検索は目に見えやすく、デモンストレーションも容易で、機能すると魔法のように感じられます。質問を入力すれば、答えが返ってきます。
検索は知識構造ではない
最新の知識システムのほとんどは検索(Retrieval)を最適化しています。それは理解できることです。検索は目に見えやすく、デモンストレーションも容易で、機能すると魔法のように感じられます。質問を入力すれば、答えが返ってきます。
AIシステム向けの構造化された知識
前提はシンプルです。コンパイルされた知識は、取得された断片的な情報よりも再利用性が高いというものです。 RAG(検索強化生成)は、LLM(大規模言語モデル)に外部知識へのアクセスをどのように与えるかという直接的な問いに対するデフォルトの答えとなりました。
現代の知識システムの地図
PKM、RAG、ウィキ、AIメモリシステム、そして今実用化が進むAI支援ワークフローは、しばしば同じ問題を解決するかのように論じられます。 しかし、実際にはそうではありません。 これらはすべて知識を扱いますが、動作するレイヤーは異なります。
ノートは記憶です。セカンドブレインは計算です。
情報過多(インフォメーション・オーバーロード)の問題は、単なる情報の量というよりも、処理されていない入力に起因するものです。現代の知的労働では、開きっぱなしのブラウザタブ、チャットのやり取り、ドキュメント、ハイライト、スニペット、トランスクリプト、スクリーンショット、そして書きかけのメモといった痕跡を残します。
「雰囲気」に頼る解析をやめ、契約を検証せよ。
ほとんどのLLM「構造化出力」チュートリアルは、本気度にかけるものです。 それらは、JSONを丁寧な口調でリクエストし、モデルが適切に動作することを祈る方法を教えます。 それでは検証ではありません。 それは単に括弧で囲まれた楽観主義にすぎません。
エージェント型LLMのチューニングに関する参照資料
このページは、エージェント型LLM推論チューニングの実用的なリファレンス(temperature、top_p、top_k、ペナルティ、およびマルチステップやツール多用なワークフローにおけるそれらの相互作用)です。
より広範なLLMパフォーマンスエンジニアリングハブと併せて参照し、明確なLLMホスティングとサービングの概要と組み合わせることで、モデルがリソース不足に陥った際にはスループットとスケジューリングが依然として支配的ですが、不安定なサンプリングはGPUが処理を終える前にリトライと出力トークンを消費してしまうことがわかります。
このページでは以下をまとめます:
現在、以下に焦点を当てています:
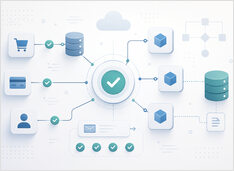
重複する副作用を回避する
分散システムにおける冪等性(Idempotency)とは、ネットワークが嘘をつき、キューが再送を試み、クライアントがパニックし、オペレーターがリプレイボタンを押した際に、あなたを救済する性質です。本番環境では、重複したメッセージの配信は正常な挙動です。問題となるのは、重複した副作用の発生です。
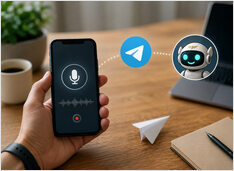
スマートフォンからHermesと会話する
スマートフォンからテキストでヘルメスエージェントとチャットすることはすでに可能でしょう。 今、あなたはエージェントと直接会話し、音声で返信を受け取りたいと考えています。 これは通常、正しい選択です。特にHermesを永続的な自己ホスト型アシスタントとして使用している場合には顕著です。 小さな画面で長いプロンプトをタイプするのは、時間がかかり、誤りも生じやすいものです。
セルフホスト型LLMにおけるHermesカーンボードの負荷を制御する
Hermes AgentにはKanbanスタイルのボードとHermes Gatewayが標準で搭載されていますが、一度に多数のタスクがディスパッチされると、セルフホスト型のLLMが過負荷状態に陥る可能性があります。
著者:Hermes。高速に読み込まれ、安定して動作するスキル。
Hermes Agentは、繰り返し可能なワークフローを教えるデフォルトの方法としてスキルを採用しています。公式ドキュメントでは、スキルはオープンなagentskills.io仕様に準拠したオンデマンド型ナレッジ文書と説明されており、**プログレッシブ・ディスクロージャー(段階的開示)**によってモデルがまず小さなインデックスを見て、タスクが実際に必要としたときにのみ完全な指示を取得する仕組みになっています。
セルフホスト型 Hermes エージェント用のシェルコマンドと TUI コマンド。
Nous Research が提供する Hermes Agent は、ローカル環境またはVPS上で実行可能な、モデル非依存のツール利用型アシスタントです。
MinIO CEは2026年に実質的に終了(EOL)を迎えます。
MinIO Community Edition(CE)は、新規の本番環境システムにおける安全なデフォルトオプションではもはやありません。
NemoClawでOpenClawを安全に実行
大多数のAIエージェントスタックは、セキュリティをデモ後の修正事項として扱っています。 NemoClawは対極の前提から始まり、隔離、ポリシー、ルーティングを初期設定(Day-Zero defaults)として採用しています。
キャプチャポリシーは、リコールと同等の重要さを帯びつつある。
2026年9月更新: Mnemosyne と Memori を追加、Honcho と Hindsight の設定を拡張し、元のインフラストラクチャテーブルの yanıでキャプチャポリシー比較表を追加しました。
現代のAIアシスタントは、タブを閉じても何も覚えていない状態が続きますが、これはコンテキストウィンドウを超えて何かが永続化されないためです。エージェントメモリプロバイダーとは、セッション間で事実や要約を保持するサービスまたはライブラリです。多くの場合、プラグインとして組み込まれることで、フレームワークをスリムに保ちながらメモリをスケーリングできます。
メモリこそが、ツールとパートナーとの違いを創り出す。
AI エージェントとのチャットを開始し、プロジェクトの概要を説明し、好みを共有し、いくつかの作業を行い、タブを閉じる。その翌週にもう一度戻ってくると、まるで見知らぬ人と話しているかのようですね。すべてのコンテキストが失われ、すべての好みは忘れられ、プロジェクトはゼロから再説明しなければなりません。
OpenClawは急速に台頭し、その後、さらに急速に姿を消した。
OpenClawは製品として失敗したわけではありません。単に「燃料」を失っただけです。
システム、インフラ、AIエンジニアリングの新記事をお届けします。