
Llama-Server ルーターモード - リスタートなしでの動的モデル切り替え
再起動せずにLLMを配信・切り替え可能。
長らく、llama.cpp には致命的な制限がありました。
それは、1プロセスにつき1つのモデルしか提供できず、モデルを切り替えるには再起動が必要だった点です。
再起動せずにLLMを配信・切り替え可能。
長らく、llama.cpp には致命的な制限がありました。
それは、1プロセスにつき1つのモデルしか提供できず、モデルを切り替えるには再起動が必要だった点です。
SGLang を使ってオープンモデルを高速に提供。
SGLang は、大規模言語モデルおよびマルチモーダルモデル向けの高パフォーマンスなサービングフレームワークであり、単一の GPU から分散クラスターに至るまで、低レイテンシかつ高スループットの推論を提供するために設計されています。
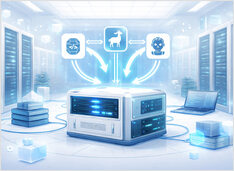
クライアントを変更せずにローカルLLMをホットスワップできます。
すぐにvLLM、llama.cpp、そしてその他の多数のスタックを回す必要が出てきます。それぞれのスタックは独自のポートを使います。しかし、下流のすべてのアプリケーションは、/v1 ベースの単一のURLを期待しています。そうでなければ、ポート、プロファイル、使い捨てのスクリプトの入れ替えを繰り返すことになります。llama-swap は、これらのスタックの前段にある /v1 プロキシです。
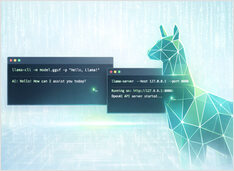
CLIおよびサーバーでGGUFモデルを実行する
llama.cpp は GGUF モデル向け C/C++ 推論エンジンです。対話型チャット用の llama-cli、スクリプトによるプロンプト処理用の llama-completion、OpenAI 互換 HTTP API 用の llama-server が含まれます。