
OpenCode CLI実践ガイド:ワークフロー、自動化、落とし穴
コマンドラインからOpenCodeを開く、実践編
OpenCodeのコマンドラインインターフェースは、スクリプティング、CIパイプライン、無人エージェント実行のために構築されています。この記事では、日々の業務での使用方法に関する実践的なガイドを提供します。
コマンドラインからOpenCodeを開く、実践編
OpenCodeのコマンドラインインターフェースは、スクリプティング、CIパイプライン、無人エージェント実行のために構築されています。この記事では、日々の業務での使用方法に関する実践的なガイドを提供します。
llama-serverを停止せずにVRAMを解放する方法
llama.cpp ラーターモード は、llama-server における数年間で最も有用な変更の一つです。これにより、ローカルLLM運用者は、Ollamaで期待されるようなモデル管理体験に近いものをようやく手に入れることができました。同時に、llama-server を使い続ける価値がある生のパフォーマンスと低レベルの制御も維持されています。
エージェント型LLMのチューニングに関する参照資料
このページは、エージェント型LLM推論チューニングの実用的なリファレンス(temperature、top_p、top_k、ペナルティ、およびマルチステップやツール多用なワークフローにおけるそれらの相互作用)です。
より広範なLLMパフォーマンスエンジニアリングハブと併せて参照し、明確なLLMホスティングとサービングの概要と組み合わせることで、モデルがリソース不足に陥った際にはスループットとスケジューリングが依然として支配的ですが、不安定なサンプリングはGPUが処理を終える前にリトライと出力トークンを消費してしまうことがわかります。
このページでは以下をまとめます:
現在、以下に焦点を当てています:
セルフホストされたHermes Agent用シェルおよびTUIコマンド。
Nous Research が提供する Hermes Agent は、モデル非依存型でツール利用可能なアシスタントであり、ローカルまたは VPS で実行し、シェル、全画面表示の TUI、メッセージングゲートウェイのいずれからでも利用できます。
NemoClawでOpenClawを安全に実行
大多数のAIエージェントスタックは、セキュリティをデモ後の修正事項として扱っています。 NemoClawは対極の前提から始まり、隔離、ポリシー、ルーティングを初期設定(Day-Zero defaults)として採用しています。
再起動せずにLLMを配信・切り替え可能。
長らく、llama.cpp には致命的な制限がありました。
それは、1プロセスにつき1つのモデルしか提供できず、モデルを切り替えるには再起動が必要だった点です。
Bash、CMD、PowerShell、macOS に対応する任意キーでの一時停止機能。
バッチファイルやシェルスクリプトでは、ダブルクリックしたウィンドウやインストーラーのログが見えるように、短時間の待機が必要な場合があります。Windows CMD には専用の**pauseコマンドがあります。Unix シェルではread**を使用します。
SGLang を使ってオープンモデルを高速に提供。
SGLang は、大規模言語モデルおよびマルチモーダルモデル向けの高パフォーマンスなサービングフレームワークであり、単一の GPU から分散クラスターに至るまで、低レイテンシかつ高スループットの推論を提供するために設計されています。
クライアントを変更せずにローカルLLMをホットスワップできます。
すぐにvLLM、llama.cpp、そしてその他の多数のスタックを回す必要が出てきます。それぞれのスタックは独自のポートを使います。しかし、下流のすべてのアプリケーションは、/v1 ベースの単一のURLを期待しています。そうでなければ、ポート、プロファイル、使い捨てのスクリプトの入れ替えを繰り返すことになります。llama-swap は、これらのスタックの前段にある /v1 プロキシです。
OpenHands CLI を数分でクイックスタート
OpenHands は、AI 駆動のソフトウェア開発エージェントのためのオープンソースでモデル非依存のプラットフォームです。 単なる自動補完ツールではなく、エージェントがコーディングパートナーのように振る舞うことを可能にします。
数分で LocalAI を使用して、OpenAI 互換 API をセルフホストできます。
LocalAI は、ご自身のハードウェア(ノート PC、ワークステーション、オンプレミスサーバー)上で AI ワークロードを実行できるように設計された、自己完結型でローカルファーストの推論サーバーです。これは、OpenAI API と互換性のある「差し替え可能な」APIとして動作します。
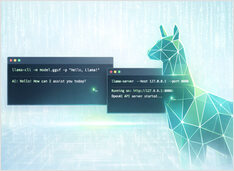
CLIおよびサーバーでGGUFモデルを実行する
llama.cpp は GGUF モデル向け C/C++ 推論エンジンです。対話型チャット用の llama-cli、スクリプトによるプロンプト処理用の llama-completion、OpenAI 互換 HTTP API 用の llama-server が含まれます。
OpenCodeのインストール、設定、および使用方法
OpenCodeは、ターミナル(TUI + CLI)で実行できるオープンソースのAIコーディングエージェントです。オプションとしてデスクトップおよびIDE向けのインターフェースも提供されています。これはOpenCode クイックスタートです:インストール、確認、モデル/プロバイダーの接続、そして実際のワークフロー(CLI + API)の実行方法を紹介します。
セレニウム、chromedp、Playwright、ZenRows - Goでの実装。
正しいブラウザーオートメーションスタックとGoでのウェブスクレイピングの選択は、速度、メンテナンス、コードが実行される場所に影響を与えます。
Ubuntu 24 における .desktop ランチャー - アイコン、Exec、場所
Ubuntu 24のデスクトップランチャー(およびほとんどのLinuxデスクトップ)は、.desktopファイルによって定義されます。これは、アプリケーションやリンクを記述する小さなテキストベースの設定ファイルです。
PythonによるブラウザオートメーションとE2Eテストの比較。
Pythonにおけるブラウザーオートメーションスタックの選択は、速度、安定性、メンテナンスに影響を与えます。
この概要では、
Playwright vs Selenium vs Puppeteer vs LambdaTest vs ZenRows vs Gauge
を比較します。Pythonに焦点を当てながら、Node.jsや他の言語がどの場面で役立つかについても記載しています。