AMDローカルLLMホスティングにおけるROCm vs Vulkan:2026年版ガイド
エンジンごとに最適なAMDバックエンドを選択する
ROCm と Vulkan はどちらも AMD GPU をローカル LLM ホスティングで高速化しますが、互換性はありません。適切な選択は、エンジン、GPU、およびワークロードに依存します。
エンジンごとに最適なAMDバックエンドを選択する
ROCm と Vulkan はどちらも AMD GPU をローカル LLM ホスティングで高速化しますが、互換性はありません。適切な選択は、エンジン、GPU、およびワークロードに依存します。
16GBでは128Kコンテキストが死ににくい理由
モデルが128Kのコンテキストウィンドウを宣伝していても、16 GBのGPUでは40Kトークンで失敗する可能性があります。アーキテクチャ上の上限は、重み、KVキャッシュ、計算バッファ、そしてデスクトップコンポジターが同時にあなたのGPUに収まることを約束したことはありませんでした。
OllamaからvLLMへの移行タイミング
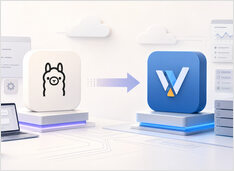
Ollamaはローカルでの言語モデル実行において最も手軽な方法の一つですが、その手軽さゆえに、ローカルの実験がスケジューリングや可観測性が必要な共有推論サービスへと移行すべきタイミングを隠してしまいます。
Prometheus と Grafana を用いた LLM の監視
LLM の推論は「ただの API」のように見えますが、レイテンシが急増し、キューが backlog して、GPU のメモリ使用率が 95% に達しても明確な説明ができない状況に直面した際に、その真の姿が明らかになります。
2026年のvLLMのインストール、サービング、およびチューニング
vLLMは、UC BerkeleyのSky Computing Labが開発した、大規模言語モデル(LLM)向けの高スループットでメモリ効率の良い推論・サービングエンジンです。
2026年のベストなローカルLLMホスティングツールを比較します。APIの成熟度、ハードウェア対応、ツール呼び出し、そして実務でのユースケースです。
ローカルLLMの運用は、現在では開発者、スタートアップ、さらにはエンタープライズチームでも現実的な選択肢となっています。 しかし、最適なツールを選ぶこと——Ollama、vLLM、LM Studio、LocalAI など——は、目的に依存します: