
Qwen 4の登場が目前に: 確実な情報とローカルAIへの意味
Qwen 4:確認された事実、27Bの段階的モデル展開、ローカル環境での適応性。
AlibabaはApsara会議にて、Qwen 4の学習が行われていることを確認しました。具体的な日付は示されていませんが、コミュニティのタイミングを示すシグナルは、数か月ではなく数週間以内のリリースを指しています。
Qwen 4:確認された事実、27Bの段階的モデル展開、ローカル環境での適応性。
AlibabaはApsara会議にて、Qwen 4の学習が行われていることを確認しました。具体的な日付は示されていませんが、コミュニティのタイミングを示すシグナルは、数か月ではなく数週間以内のリリースを指しています。
16GBでは128Kコンテキストが死ににくい理由
モデルが128Kのコンテキストウィンドウを宣伝していても、16 GBのGPUでは40Kトークンで失敗する可能性があります。アーキテクチャ上の上限は、重み、KVキャッシュ、計算バッファ、そしてデスクトップコンポジターが同時にあなたのGPUに収まることを約束したことはありませんでした。
なぜAIスタックは毎月より強力な依存関係を生み出すのか
すべてのAPI呼び出しは、簡単な取引のように感じられます。しかし、それらが積み重なり、ファインチューニング用のデータ、評価ハーネス、ツールスキーマがすべて1つのベンダーに合わせて形作られると、ベンダーの切り替えは「ルーティングの変更」では済まなくなります。
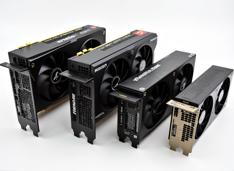
3社によるAI GPUの比較
2026年、AIハードウェアの状況は大きく変化しました。NVIDIA、AMD、Intelの各社が、ローカル環境で大型言語モデル(LLM)やAI推論ワークロードを実行できるGPUを必要とする開発者を獲得するため、激しい競争を繰り広げています。
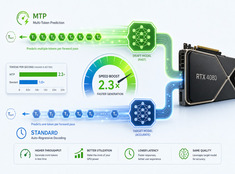
RTX 4080におけるMTPと標準デコーディングの実ベンチマーク比較
Qwen 3.6 27B と 35B において、RTX 4080(16 GB VRAM)上で投機的デコーディング(マルチトークン予測、MTP)のパフォーマンスをテストしました。
llama.cppの16 GB VRAMにおけるトークン速度(テーブル)。
ここでは、16GBのVRAMを備えたGPUで動作する複数のLLM(大規模言語モデル)の速度を比較し、セルフホスティングに最適なモデルを選びます。
これらのLLMは、llama.cpp上で19K、32K、64Kトークンのコンテキストウィンドウで実行しました。
スタイライズされたGPUとVRAMブロック、およびベンチマーク風のチャート
この記事では、速度という観点から、可能な限り高いパフォーマンスを引き出そうとした試みを記録しています。
| モデル | サイズ | 19K VRAM | 19K GPU/CPU | 19K T/s | 32K VRAM | 32K 負荷 | 32K T/s | 64K VRAM | 64K 負荷 | 64K: T/s |
|---|---|---|---|---|---|---|---|---|---|---|
| Qwen3.6-35B-A3B-UD-IQ3_XXS | 13.2 | 13.8GB | 96%/100% | 147.5 | 14.0GB | 96%/101% | 149.1 | 14.7GB | 96%/101% | 145.8 |
| Qwen3.6-35B-A3B-UD-IQ4_XS | 17.7 | 14.3GB | 62%/266% | 95.0 | 14.9GB | 58%/279% | 92.3 | 14.9GB | 57%/293% | 86.4 |
| Qwen3.5-35B-A3B-UD-IQ3_S | 13.6 | 14.3GB | 93%/100% | 136.4 | 14.6GB | 93%/100% | 138.5 | 14.9GB | 88%/115% | 136.8 |
| Qwen3.5-27B-IQ3_XXS-bartowsky | 11.3 | 12.8 | 98/100 | 44.9 | 13.5 | 98/100 | 44.9 | 14.5 | 45/415 | 23.6 |
| Qwen3.5-27B-UD-IQ3_XXS | 11.5 | 12.9 | 98/100 | 45.3 | 13.7 | 98/100 | 45.1 | 14.7 | 45/410 | 22.7 |
| Qwen3.5-27B-IQ4_XS.gguf | 15.0 | 14.6 | 49/406 | 20.5 | 14.7 | 37/465 | 17.4 | 14.7 | 23/533 | 13.3 |
| Qwen3.5-122B-A10B-UD-IQ3_XXS | 44.7 | 14.7 | 30/470 | 22.3 | 14.7 | 30/480 | 21.8 | 14.7 | 28/490 | 21.5 |
| Qwen3.5-122B-A10B-UD-IQ3_S | 46.5 | 14.7 | 25/516 | 19.4 | 14.7 | 24/516 | 19.5 | 14.7 | 24/516 | 19.6 |
| Mistral-Small-4-119B UD-IQ3_XXS | 42.8 | 14.8 | 28/585 | 30.4 | 14.7 | 27/574 | 28.5 | 14.9 | 20/590 | 31.5 |
| Qwen3-Coder-Next-UD-IQ4_XS | 38.4 | 14.6 | 32/460 | 41.1 | 14.7 | 29/440 | 41.3 | 14.8 | 32/460 | 38.3 |
| Nemotron Super 120b IQ3_XXS | 56.2 | 15.0 | 26/517 | 17.5 | 14.6 | 26/531 | 17.4 | 14.6 | 26/535 | 17.6 |
| gemma-4-26B-A4B-it-UD-IQ4_XS | 13.4 | 14.7 | 95/100 | 121.7 | 14.9 | 95/115 | 114.9 | 14.9 | 75/190 | 96.1 |
| gemma-4-31B-it-UD-IQ3_XXS | 11.8 | 14.8 | 68/287 | 29.2 | 14.8 | 41/480 | 18.4 | 14.8 | 18/634 | 8.1 |
| GLM-4.7-Flash-IQ4_XS | 16.3 | 15.0 | 66/240 | 91.8 | 14.9 | 62/262 | 86.1 | 14.9 | 53/313 | 72.5 |
| GLM-4.7-Flash-REAP-23B IQ4_XS | 12.6 | 13.7 | 92/100 | 122.0 | 14.4 | 95/102 | 123.2 | 14.9 | 71/196 | 97.1 |
19K、32K、64Kはコンテキストサイズを指します。
オーストラリアではRTX 5090は供給不足であり、価格が高騰しています。
オーストラリアにはRTX 5090の在庫があります。 ただし、ごくわずかです。 もし見つけたとしても、現実感の欠けた、莫大なプレミアム価格を支払わなければなりません。
セルフホスト型LLMでデータとモデルを制御
LLM(大規模言語モデル)のセルフホスティングは、データ、モデル、推論をあなたの管理下に保つものであり、チーム、企業、国家にとって AI主権 を実現するための実用的な手段です。
RTX 4080(VRAM 16GB)におけるLLM速度テスト
大規模言語モデル(LLM)をローカルで実行することで、プライバシーの保護、オフラインでの利用、そしてAPIコストのゼロ化を実現できます。 このベンチマークでは、RTX 4080上でOllamaを使用する14のポピュラーなLLMの性能について、何を期待できるかを具体的に明らかにします。
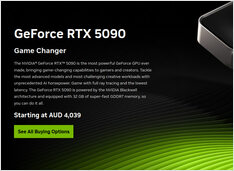
2025年1月GPUおよびRAM価格チェック
今日、トップレベルの消費者向けGPUとRAMモジュールについて見てみましょう。
特に注目しているのは、RTX-5080およびRTX-5090の価格と、32GB(2x16GB)DDR5 6000です。
Linuxワークフローに適したターミナルを選択する
Linuxユーザーにとって最も欠かせないツールの一つがターミナルエミュレーターです。
オーストラリアの小売業者から、リアルなオーストラリアドルでの価格を今すぐ。
NVIDIA DGX Spark (GB10 Grace Blackwell) は、主要な PC 小売店に国内在庫があり、オーストラリアで入手可能 となっています。 世界的な DGX Spark の価格と入手性 を追いかけていただいている方なら、オーストラリアでの価格帯はストレージ構成や小売店によって 6,249 オーストラリアドルから 7,999 オーストラリアドル であることが、ご関心をお持ちいただけるでしょう。
ローカルLLMを使用してCogneeをテストする - 実際の結果
CogneeはPythonフレームワークで、LLMを使用してドキュメントから知識グラフを構築します。 しかし、これはセルフホストされたモデルと互換性がありますか?
Ubuntuでネットワークの問題を解決した方法
新しいカーネルを自動インストールした後、Ubuntu 24.04でイーサネットネットワークが失われたという問題が発生しました。この面倒な問題は私にとって2度目だったので、同じ問題に直面している他の人々の助けになるよう、ここに解決策を記録しています。
短い投稿ですが、価格についてのみ記載します。
この狂気じみた RAM 価格のボラティリティ について、全体像を把握し、より明確なイメージを持つために、まずは私たちが オーストラリアの RAM 価格を追跡 してみましょう。