
Hermesエージェントのための「Hindsight」:ローカルLLMによるセルフホスト型メモリ
自社ハードウェアでの永続的なHermesメモリ。
セルフホストするAIエージェントには、長いコンテキストウィンドウだけでは不十分です。有用な事実を保持し、過去の決定を呼び出し、プロジェクトの進化に伴って自分が知っていることを再考する仕組みが必要です。
自社ハードウェアでの永続的なHermesメモリ。
セルフホストするAIエージェントには、長いコンテキストウィンドウだけでは不十分です。有用な事実を保持し、過去の決定を呼び出し、プロジェクトの進化に伴って自分が知っていることを再考する仕組みが必要です。
「記憶された結論が新たな証拠となる時。」
永続メモリにより、エージェントは毎回説明を繰り返す必要のあるツールから、コンテキストを引き継ぐものへと進化します。しかし、状態のないチャットでは回避される障害モードが新たに開かれます。解釈が記憶として保存され、事実として検索され、それ自身のより強固なバージョンを正当化し始めることがあるのです。
書き込みを制御されたローカル Hermes メモリ。
Mnemosyne は Hermes Agent 向けのローカルファーストなメモリプロバイダーであり、ワーキングメモリ、構造化された事実、時間的データ、エピソード記憶をローカルの SQLite に保存します。ホスティングサービスは不要で、ネットワーク呼び出しも必須ではなく、非常に細粒度な書き込み制御が特徴です。
1行のインポートを超えた安全なカットオーバー
AIアシスタントの移行は、アプリケーション設定のコピーとは異なり、アイデンティティ、メモリ、ツール動作、スケジュールされたタスク、メッセージングへのアクセスを維持することが核心です。また、2つのゲートウェイが同じボットとして動作している状態を回避することも重要です。
スキル、MCPサーバー、それとも両方?
エージェントスキルとMCPサーバーは、AIエージェントを拡張する競合する2つの方法として提示されることがあります。この捉え方は誤りです:スキルはエージェントに作業方法を教え、MCPサーバーはライブ機能への管理されたアクセスを提供します。
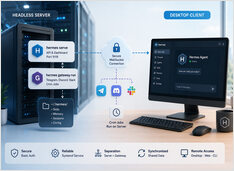
リモートデスクトップアクセスに対応したヘッドレスHermesサーバー
ヘッドレスサーバーで Hermes エージェントを実行し、別のマシンのデスクトップクライアントから接続するには、2つのサーバープロセスと1つのクライアント接続が必要です。
AIエージェントのための信頼性の高いポーリングパターン
ポーリングエージェントは、AIアシスタントのアーキテクチャの中で最も華やかではない部分の一つですが、同時に最も有用な部分の一つでもあります。
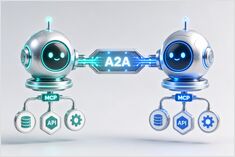
MCPはエージェントにツールを提供します。A2Aはエージェントに同僚を提供します。
AIエージェントのアーキテクチャは、2つのレイヤーに分裂し始めています。
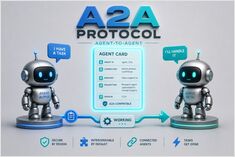
「A2Aはエージェントをネットワークピアに変換します。」
Agent2Agentプロトコルの略称であるA2Aプロトコルは、独立したAIエージェントシステム間の通信のためのオープン標準です。
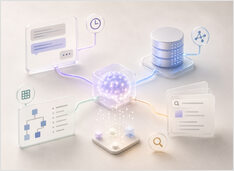
アシスタントのためのワーキングメモリ、構造化メモリ、検索メモリ
メモリはアシスタントを反応型のシステムから持続的なシステムへと変えますが、同時に多くのシステムが静かに腐敗していく場所でもあります。最近の調査では、現代的なエージェントのメモリに対して、短期記憶と長期記憶の二元論はもはや十分ではないと指摘されています。OpenAIやLangGraphのSDKは、よりシンプルなスタックを提唱しています。すなわち、ワーキングメモリ、永続状態、そして検索(リトリーバル)です。
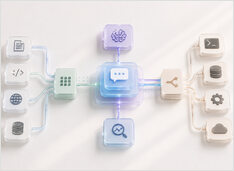
本格的なアシスタントは実際にどのように構築されているのか
本番環境向けのAIアシスタントは「プロンプト付きのLLM」ではありません。それは意図を受け取り、状態を保持し、いつ取得したり実行したりするかを決定し、障害のデバッグに必要なランタイムの詳細を公開するシステムです。
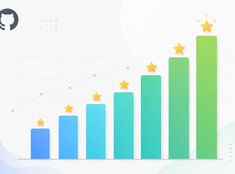
スター数、トークン数、ダウンロード数――どれが本当に優位か?
オープンソースの AI エージェントフレームワークが、GitHub 上で人気が爆発しています。 セルフホスト型 AI システム エコシステムの核心に位置する 2 プロジェクト——OpenClaw と Hermes Agent——は、他のどのプロジェクトよりも大きく差を広げており、残りの競合プロジェクトは遠く離れた 3 位争いを行っています。
エージェント型LLMのチューニングに関する参照資料
このページは、エージェント型LLM推論チューニングの実用的なリファレンス(temperature、top_p、top_k、ペナルティ、およびマルチステップやツール多用なワークフローにおけるそれらの相互作用)です。
より広範なLLMパフォーマンスエンジニアリングハブと併せて参照し、明確なLLMホスティングとサービングの概要と組み合わせることで、モデルがリソース不足に陥った際にはスループットとスケジューリングが依然として支配的ですが、不安定なサンプリングはGPUが処理を終える前にリトライと出力トークンを消費してしまうことがわかります。
このページでは以下をまとめます:
現在、以下に焦点を当てています:
スマートフォンからHermesと会話する
スマートフォンからテキストでヘルメスエージェントとチャットすることはすでに可能でしょう。 今、あなたはエージェントと直接会話し、音声で返信を受け取りたいと考えています。 これは通常、正しい選択です。特にHermesを永続的な自己ホスト型アシスタントとして使用している場合には顕著です。 小さな画面で長いプロンプトをタイプするのは、時間がかかり、誤りも生じやすいものです。
セルフホスト型LLMのHermesカンバンの負荷を制御する。
Hermes Agentには、Kanbanスタイルのボードと、一度に多くのタスクがディスパッチされるとセルフホスト型LLMを飽和状態にしてしまう可能性のあるHermes Gatewayが同梱されています。
著者:Hermes。高速に読み込まれ、安定して動作するスキル。
Hermes Agentは、繰り返し可能なワークフローを教えるデフォルトの方法としてスキルを採用しています。公式ドキュメントでは、スキルはオープンなagentskills.io仕様に準拠したオンデマンド型ナレッジ文書と説明されており、**プログレッシブ・ディスクロージャー(段階的開示)**によってモデルがまず小さなインデックスを見て、タスクが実際に必要としたときにのみ完全な指示を取得する仕組みになっています。