

2026年の llama.cpp と Ollama: どちらのランタイムを使うべきか?
「llama-serverがOllamaに勝つとき」
Ollamaとllama.cppは、競合する推論エンジンであるかのように比較されがちです。しかし、実際の選択は、管理されたモデルサービスと、直接操作するツールキットのどちらを選ぶかです。
「llama-serverがOllamaに勝つとき」
Ollamaとllama.cppは、競合する推論エンジンであるかのように比較されがちです。しかし、実際の選択は、管理されたモデルサービスと、直接操作するツールキットのどちらを選ぶかです。
エンジンごとに最適なAMDバックエンドを選択する
ROCm と Vulkan はどちらも AMD GPU をローカル LLM ホスティングで高速化しますが、互換性はありません。適切な選択は、エンジン、GPU、およびワークロードに依存します。
なぜAIスタックは毎月より強力な依存関係を生み出すのか
すべてのAPI呼び出しは、簡単な取引のように感じられます。しかし、それらが積み重なり、ファインチューニング用のデータ、評価ハーネス、ツールスキーマがすべて1つのベンダーに合わせて形作られると、ベンダーの切り替えは「ルーティングの変更」では済まなくなります。
OllamaからvLLMへの移行タイミング
Ollamaはローカルでの言語モデル実行において最も手軽な方法の一つですが、その手軽さゆえに、ローカルの実験がスケジューリングや可観測性が必要な共有推論サービスへと移行すべきタイミングを隠してしまいます。
llama-serverを停止せずにVRAMを解放する方法
llama.cpp ラーターモード は、llama-server における数年間で最も有用な変更の一つです。これにより、ローカルLLM運用者は、Ollamaで期待されるようなモデル管理体験に近いものをようやく手に入れることができました。同時に、llama-server を使い続ける価値がある生のパフォーマンスと低レベルの制御も維持されています。
再起動せずにLLMを配信・切り替え可能。
長らく、llama.cpp には致命的な制限がありました。
それは、1プロセスにつき1つのモデルしか提供できず、モデルを切り替えるには再起動が必要だった点です。

ローカルLLMによるセルフホステッドAI検索
Vaneは、「引用付きAI検索」分野でより実用志向の選択肢の一つです。ライブなWeb検索とローカルまたはクラウドのLLMを組み合わせつつ、スタック全体を自分自身の管理下におくセルフホスト型の回答エンジンです。
TGI をインストールし、迅速にデプロイ、さらに高速にデバッグ。
Text Generation Inference (TGI) は、非常に特有の雰囲気を持っています。 推論の分野で最も新しい子供ではありませんが、すでに本番環境でのトラブルを学び、その教訓をデフォルト設定に焼き付けているのが TGI です。
公開ポートを使用しないリモート Ollama アクセス
Ollama は、ローカルデーモンとして扱われるときに最も快適に動作します。CLI とアプリケーションがループバック HTTP API と通信し、残りのネットワークにはその存在が知られない状態です。
GPUと永続化対応のコンポーズファーストOllamaサーバー。
Ollama はベアメタル上で非常に良好に動作します。サービスとして扱うようになると、さらに興味深いものになります。安定したエンドポイント、ピン留めされたバージョン、永続化ストレージ、そして利用可能かどうかの明確な GPU。
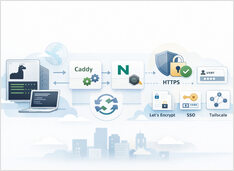
ストリーミング応答を破綻させずに HTTPS で Ollama を利用する。
リバースプロキシの背後で Ollama を実行することは、HTTPS、オプションのアクセス制御、予測可能なストリーミング動作を実現する最も簡単な方法です。
SGLang を使ってオープンモデルを高速に提供。
SGLang は、大規模言語モデルおよびマルチモーダルモデル向けの高パフォーマンスなサービングフレームワークであり、単一の GPU から分散クラスターに至るまで、低レイテンシかつ高スループットの推論を提供するために設計されています。
クライアントを変更せずにローカルLLMをホットスワップできます。
すぐにvLLM、llama.cpp、そしてその他の多数のスタックを回す必要が出てきます。それぞれのスタックは独自のポートを使います。しかし、下流のすべてのアプリケーションは、/v1 ベースの単一のURLを期待しています。そうでなければ、ポート、プロファイル、使い捨てのスクリプトの入れ替えを繰り返すことになります。llama-swap は、これらのスタックの前段にある /v1 プロキシです。
数分で LocalAI を使用して、OpenAI 互換 API をセルフホストできます。
LocalAI は、ご自身のハードウェア(ノート PC、ワークステーション、オンプレミスサーバー)上で AI ワークロードを実行できるように設計された、自己完結型でローカルファーストの推論サーバーです。これは、OpenAI API と互換性のある「差し替え可能な」APIとして動作します。
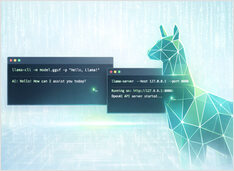
CLIおよびサーバーでGGUFモデルを実行する
llama.cpp は GGUF モデル向け C/C++ 推論エンジンです。対話型チャット用の llama-cli、スクリプトによるプロンプト処理用の llama-completion、OpenAI 互換 HTTP API 用の llama-server が含まれます。
セルフホスト型LLMでデータとモデルを制御
LLM(大規模言語モデル)のセルフホスティングは、データ、モデル、推論をあなたの管理下に保つものであり、チーム、企業、国家にとって AI主権 を実現するための実用的な手段です。