StrataでローカルにQwen3.8-Flash-Nextを動作させる:64 GBクイックスタート
125B MoEを1枚のコンシューマーGPUで——そして3ビットが破綻する地点
Qwen3.8-Flash-Next (QFN) は総パラメータ数125B、トークンあたりアクティブ6B、ネイティブで256Kコンテキストウィンドウを備えています。デフォルトで思考(Thinking)機能が有効になっており、ローカルモデルのクラスの中で最も高いエージェントコーディングベンチマークを記録しています。
この記事では、Strata を使用して RTX 5090 搭載の 64 GB RAM デスクトップで QFN の 3-bit 量子化バージョンを実行する方法を説明し、エージェントワークロードにおいて Q4 未満の量子化が信頼性の低いツール呼び出し(tool calls)を生成する理由を記録します。
以下に、インストールコマンド、各量子化が固定する RAM の量、および 64 GB デスクトップにおけるツール呼び出しの失敗を示します。速度と失敗の数値は、そのマシン(RTX 5090、64 GB RAM、Ubuntu 26.04)での実行と、Strata トラッカーおよび 0.2.11 リリースノートでの報告を混在させたものです。
コマンドとエンジンのデフォルト設定は、リポジトリが 40,836 スターを表示し、エンジンパッケージが 0.1.57 であった 2026年06月11日 に Strata 0.2.11 に対して確認しました。このランタイムが Ollama、llama.cpp、vLLM の中にどの位置にあるかは、LLM ホスティングガイド の役割です。
Strata とは何か
このクイックスタートで紹介しているエンジンは、Niko1221/Strata で、MIT ライセンスです。別のプロジェクト、SGLang ための階層型 KV キャシニングに関する OSDI 2026 論文も同じ名前を使っています。Strata は llama.cpp と ggml をベースとして構築されており、リポジトリには docs/paper/Strata-Paper.pdf に論文の記述が含まれています。これは Qwen3.8-Flash-Next を、1つのコンシューマー向け GPU、システム RAM、SSD にわたって実行します。同じエンジンにより、Qwen3.6-35B や DeepSeek V4.1-Flash も提供されます。
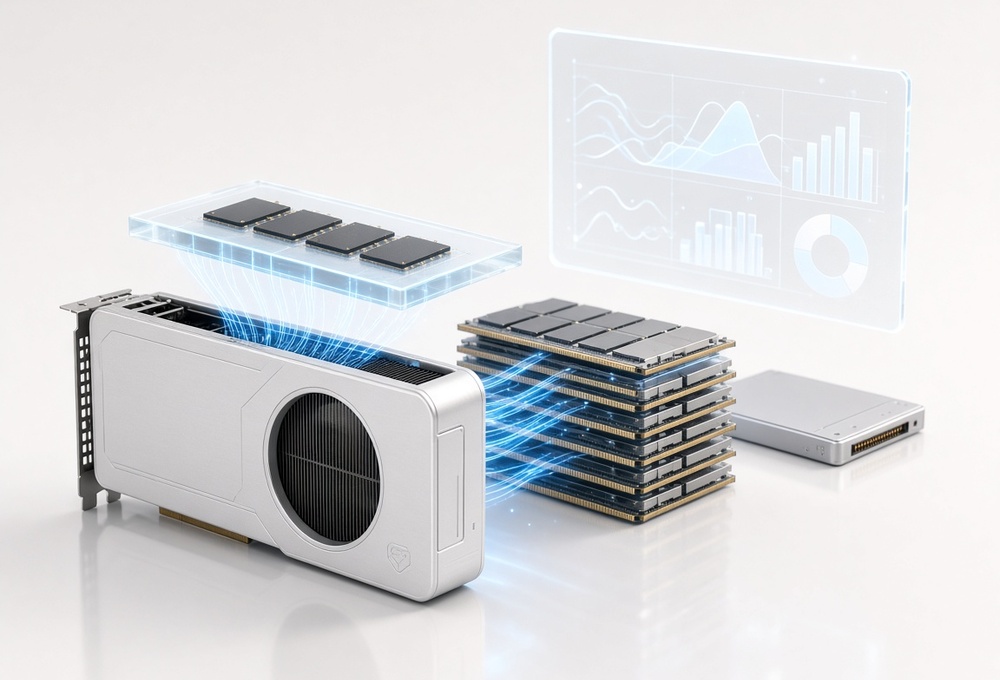
Qwen 3.8 Flash Next は 48 レイヤーにわたって 24,576 のルーティングエキスパートを持ち、各トークンが 10 のエキスパートをアクティブ化します(合計アクティブパラメータ 6B)。 Strata はモデルを1つのメモリに収めることを要求するのではなく、3つのメモリ階層に分割します。
| 階層 | 保持内容 | 動作 |
|---|---|---|
| GPU (VRAM) | Attention、DeltaNet ミキサー、gated-residual 重み、ラウター、共有エキスパート、出力ヘッド、MTP ドラフトレイヤー、KV キャッシュ(64K 以降: 最も頻繁に読まれる部分; 残りは RAM からストリームされます)に加え、エキスパートキャッシュ | トークンごとに実行されるすべての処理; エクスパートキャッシュは残りの VRAM に最も使用頻度の高いエキスパートを詰め、実行中に会話に適応する |
| RAM | 24,576 のエキスパートすべて、ピン留め(固定) 済み | GPU にないエキスパートを CPU が、GPU がキャッシュされたエキスパートで作業しているのと同じタイミングで、その場で計算する(AVX-512/AVX2 カーネル、i-quants には ggml) |
| SSD | 28.8 GB の n-gram 埋め込みテーブル | OS のページキャッシュを通じて、トークンあたり数行を読む |
51B の n-gram パラメータブロックは、バイグラムやトリグラムでインデックス付けられた 2,000 万エントリの参照テーブルとして機能します。これは行列積ではなく参照(lookup)であるため、ランタイムコストを最小限に抑えながら SSD に配置できます。
VRAM の容量がスケーリングの軸を決定します。VRAM の追加 1 ギガバイトあたり、約 700 のエキスパートを保持でき、GPU にキャッシュされる各エキスパートは CPU 計算を削減します。クロック速度が遅いが VRAM の多いカードは、速度は速いが VRAM の少ないカードよりも高性能を発揮します。
RAM の容量は、CPU と GPU の同時計算のためにすべてのエキスパートをピン留めする必要があるため、硬性制約です。Strata はディスクへの遅延メモリマッピング(lazy memory mapping)をサポートしていません。QFN の場合、ダウンロードサイズと RAM 使用量はほぼ同一です。
デコード速度の仕組み
3つのメカニズムがデコード速度を支えています。
-
マルチトークン予測。 チェックポイントは、マルチステップのドラフト用に訓練された 1 つの MTP レイヤーを含んでいます。Strata は最大 3 トークンをドラフトし、48 レイヤー全体の 1 回のパスでそれらを検証します — 推測的デコードガイド におけるドラフト-検証サイクルです。プロジェクトは、パスあたり平均 2.4〜3.2 トークンの受入率を測定し、同じ出力で 1.6〜1.8 倍のデコード速度として報告しています。
-
プロンプト検索。 モデルがコンテキストを繰り返している場合(コードの編集や引用など)、サーバーはコンテキストの以前の複製から最大 5 ドラフトトークン取得します。プロジェクトは、コード編集が 6〜11% 高速化し、他のテキストは変化しないと報告しています。
-
チャンク化プリフィル。 プロンプトは最大 8,192 トークンのブロックとして到着し、現在のレイヤーの attention が実行されている間、次のレイヤーのエキスパートが PCIe 経由で移動します。プロジェクトは、文書やコードベースの取り込みが 1,000 トークン/秒を超えると述べており、会話状態がレジデント(常駐)であるため、フォローアップが数秒以内に開始されます。
サーバーには、デスクトップアプリまたはターミナルでのローカルチャット UI、および localhost 上の OpenAI 互換および Anthropic 互換のエンドポイントが同梱されています。Claude Code、Codex CLI、OpenCode、Hermes Agent、OpenClaw は strata connect を通じて接続します。プロジェクトがリストするハードウェア: NVIDIA RTX 20/30/40/50 シリーズ(CUDA 13 エンジンパッケージはドライバー 580 以上が必要)、AMD Radeon(HIP 経由)、Intel Arc(Linux)、Apple Silicon、AMD Strix Halo。リリース 0.2.11 のデスクトップアプリは Strata-0.2.11-linux-x86_64.AppImage です。以下のターミナル経由のパスは、このクイックスタートで使用するものです。
ローカル代替手段との QFN ベンチマーク
Alibaba の モデルカード は、Flash-Next を Qwen3.8-27B、DeepSeek-V4-Flash(0731 チェックポイント)、Claude Opus 4.6 (Max) と比較しています。
| QFN | Qwen3.8-27B | DeepSeek-V4-Flash | Claude Opus 4.6 (Max) | |
|---|---|---|---|---|
| 総 / アクティブ パラメータ | 125B / 6B | 27B / 27B | 284B / 13B | – |
| N-gram 埋め込みパラメータ | 51B | – | – | – |
| DeepSWE 1.1 (エージェントコーディング) | 58.7 | 42.2 | 54.4 | – |
| SWE-bench Pro | 62.5 | 61.7 | 56.0 | 53.4 |
| SWE-bench Multilingual | 81.0 | 73.8 | – | 77.5 |
| Toolathlon Verified (ツール使用) | 73.5 | 67.1 | 70.3 | – |
| JobBench (エージェントオフィス) | 55.7 | 33.4 | 41.3 | 36.6 |
| CoWorkBench | 73.9 | 70.7 | 45.1 | 68.2 |
| GPQA Diamond | 91.7 | 89.2 | 90.8 | 91.3 |
| LiveCodeBench v6 | 91.9 | 90.3 | 90.6 | 88.8 |
そのカードのエージェントコーディング行は、温度 1.0、top_p 0.95、256K ウィンドウを使用して測定されました。DeepSWE は Claude Code と mini-SWE-agent ハネスのいずれか高い方を報告し、カードは Flash-Next の高いスコアが mini-SWE-agent 上のものであると述べています。SWE-bench Pro は補正されたタスクセットでベースラインを再実行しました; Claude Opus 4.6 のセルはベンダーが公表したスコアであり、他のセルは Claude Code です。
同じカードには、逆の結果を示す 2 行があります。NL2Repo-Bench は Flash-Next が 48.1、DeepSeek-V4-Flash が 54.2 です。GPT-4o により判定される HLE は、Claude Opus 4.6 (Max) の 40.0 に対して 35.9 です。
エージェント作業のために、カードのデフォルトは preserve_thinking をオンに設定しており、推論のトレースがターン間で保持されます。また、reasoning_effort は xhigh です。他のレベルは medium と low です。Qwen 4 ファミリーページ は、Alibaba がこのシリーズについて確認した内容(これらの重みの Qwen Community License 1.0 を含む)を追跡しています。上記の表は、今日測定可能な部分です。
量子化ビルドとサイズ
ISTA-DASLab GSQ-RCO
ISTA-DASLab GSQ-RCO GGUFs は非ユニフォーム量子化を使用しています。GSQ はテンソルごとの低ビットスカラー量子化であり、RCO はサイズ予算内でテンソルごとに型を割り当てます。この方法は、検索可能な重みの 95% を占めるルーティングエキスパートにほぼすべての圧縮を費やします。各ビルドは 2 シャードです。2 番目は約 1 ウェイトあたり 4.5 ビットの n-gram テーブルで、ディスクからマップ可能です。
| ビルド | 平均 bpw | レジデントシャード | N-gram シャード | 合計 | 備考 |
|---|---|---|---|---|---|
| Q2_0 | 2.40 | 37.6 GB | 28.8 GB | 66.4 GB | 速度ビルド: 参照テーブル形式を回避; プロンプト 367 t/s、デコード 93.8 t/s、平均レイテンシ 6.7 秒(ほぼ同じサイズで IQ2_XS は 12.7 秒) |
| IQ2_XS | 2.50 | 39.2 GB | 28.8 GB | 68.0 GB | 同等の品質で最小 |
| IQ3_XXS | 3.00 | 47.0 GB | 28.8 GB | 75.8 GB | メモリ逼迫時の選択; AIME25 でベースモデルと同等、GPQA-Diamond で約 1.5 ポイント低下 |
| IQ3_S | 3.50 | 54.8 GB | 28.8 GB | 83.6 GB | ISTA の推奨: ハネスのすべてのタスクでベースモデルに匹敵または上回る(GPQA-Diamond 92.93 対 91.92) |
これらの GPQA 数値は ISTA のハネスによるものであり、Alibaba のカード上の 91.7 ではありません。Coder バリアントは、レイヤーごとの 512 のルーティングエキスパートのうち 256 を保持し、58.4 GB、実効 1 ウェイトあたり 1.89 ビットです。0.91 GB の BF16 ビジョンプロジェクターはマルチモーダル用の追加コンポーネントです。ISTA のラインは IQ3_S で終わり、Q4 ビルドはありません。
Strata 0.2.11 における Unsloth パック
2026年04月11日 に Unsloth は Qwen3.8-Flash-Next GGUFs を Dynamic v3.1 として再アップロードしました。0.2.11 リリースノート によれば、Strata はアプリから、strata launch --family unsloth から、または既存のフォルダから、その 7 つをダウンロード、準備、実行できます。各ファイルはサイズと SHA-256 によって Unsloth リビジョン d9620119 に対してチェックされます。各セットの最後のファイルは 28.8 GB のトークンごとのテーブルです。テーブルを共有するセットはファイルを共有します: UD-IQ1_M と UD-IQ2_XS、そして UD-IQ3_XXS と UD-IQ4_XS-v31。
| Strata における名称 | ダウンロード | ファイル数 |
|---|---|---|
| UD-IQ1_M | 68.0 GB | 3 |
| UD-Q2_0 | 70.6 GB | 3 |
| UD-IQ2_XS | 75.8 GB | 3 |
| UD-Q2_K_XL | 79.6 GB | 4 |
| UD-IQ3_XXS | 83.6 GB | 4 |
| UD-Q3_K_XL | 89.5 GB | 4 |
| UD-IQ4_XS-v31 | 93.7 GB | 4 |
UD-IQ4_XS-v31 は、Strata がすでに提供していた UD-IQ4_XS とは異なるファイルです: 異なるテンソル型、3 つではなく 4 つのファイルです。UD-Q4_K_XL、UD-Q5_K_XL、UD-Q6_K_XL、Q8_0 は 2026年09月30日 のファイルのままです。2026年04月11日 の UD-Q4_K_XL は 4 ファイル分割で同じ重みであり、Strata はそれが既にある場合にその分割を受け入れます。UD-IQ1_S は読み込めません — 1 レイヤーが 2 つのエキスパート形式を混在させているため — そのため UD-IQ1_M が 1-bit の選択になります。
UD-IQ4_XS-v31 は 33 レイヤーで Q5_0 エクスパート形式を使用します。同じノートによると、Strata の Q5_0 演算は正確な結果から 1.2〜1.3% しか乖離せず、それらのテンソルに対する llama.cpp の公式は 2.6〜3.0% です。Mac の場合、アプリは最初の開始前にエキスパートを 1 つの GPU ファイルに書き換えるため、ディスク予算はダウンロード、そのファイル、数ギガバイト(UD-IQ1_M の場合で約 115 GB)になります。
28.8 GB のテーブルがマップされたままの場合、UD-IQ4_XS-v31 の残りは KV キャッシュ前に約 64.9 GB であり、Strata のピン留めルール下ではすでに 64 GB マシンを超えています。UD-IQ1_M の残りは約 39.2 GB です。そのファイルは IQ3_S が収まらない場所に収まり、それはツール呼び出しの動作(下記で 3-bit で測定)からさらに離れた 1-bit パックです。
クイックスタート: インストール、起動、初回セットアップ
Linux デスクトップには、RTX 20/30/40/50 シリーズカードまたはプロジェクトがリストする他の GPU、選択したパックと KV キャッシュのヘッドルーム(余裕)のための十分な RAM、ダウンロード用の SSD 容量が必要です。CUDA 13 エンジンパッケージにはドライバー 580 以上が必要です。
ターミナルインストール:
curl -fsSL https://github.com/Niko1221/Strata/releases/latest/download/install.sh -o install.sh && sh install.sh
strata launch
strata launch は、モデル、量子化、コンテキスト、ストレージフォルダ、アクセス設定を尋ね、カード用のエンジンをダウンロードし、サーバーを起動し、速度、メモリ、リクエストデータを示すモニターを表示します。デフォルトのエンドポイントは http://127.0.0.1:8080 です。
76 GB のダウンロード前に何が収まるか確認するため、またはプロンプトなしで開始するために:
strata launch --family qwen --model q2_0 --plan      # ドライラン: 何が不足し、何かが収まるか
strata launch --family qwen --model q2_0 --yes --no-tui   # バックグラウンドで開始
strata launch --status
strata connect    # Claude Code / OpenCode / Hermes / OpenClaw / ... の設定を表示
strata launch --stop
これらの --family qwen --model q2_0 フラグは、Ubuntu 26.04 における ISTA Q2_0 ビルドでのドライランに使用されました。Unsloth パックは --family unsloth と上記の表の名称を使用します。strata connect はツールごとにプロバイダブロックを表示します。両方の API 形状は、OpenAI 互換ベース URL(http://127.0.0.1:8080/v1)と、launch が表示するモデル名を使用します。カスタム OpenAI 互換エンドポイントを受け入れるクライアント(Cursor など)は、そのペアを使用します。
初回実行時に確認すべき 2 つの設定
-
サンプリング。 0.2.11 では、
samplingブロックのないパック設定はモデルカードに従います。思考リクエストは温度 1.0、top_p 0.95、top_k 20 になります。非思考リクエストは 0.7、0.8、20、presence_penalty 1.5 になります。優先順位は、リクエスト、ウェブ UI のチャット設定、設定ブロック、カードの順です。温度 0 は、リクエストまたはブロックがそれを設定した場合のみ適用され、そのグリーディ実行はこのチェックポイントで反復ループに陥ったものです。古いパック設定にまだ"sampling": {"temperature": 0}が含まれている場合は、カードの思考プリセットに置き換えてください。 -
tool_call_recovery。 このキーはモデル実行設定(strata-*.json)にあります。0.2.8 以降はデフォルトでオン、0.2.7 以前はオフでした。Strata のエンジンノート は、1,462 のエージェントターンを引用し、スイッチをオンで 98.3%、オフで 92.9% の呼び出しが意図通りに読み取られると報告しています。リクエストに名前があった呼び出しの 4 つの形状を受け入れます:<parameter=NAME>タグ、<tool_call>内の JSON、<tool_call>ラッパーのない<function=NAME>ブロック、そして 1 つの<tool_call>内の 2 つ目の呼び出し。宣言されていない名前や壊れた JSON はテキストのままです。0.2.7 以前では、"tool_call_recovery": trueを設定してください。エージェント作業では、0.2.11 のデフォルトをオンにしてください。
サーバーを localhost に保つ
サーバーはデフォルトで localhost にバインドし、アクセス設定は strata launch の一部です。エンドポイントは、そのマシン上のモデルと会話を公開し、オープンネットワークのために構築されていません。他のマシンが必要な場合、ポートの前に認証されたリバースプロキシを配置してください。
ss -ltnp | grep :8080    # リスナーが 127.0.0.1 であり、0.0.0.0 でないことを確認
curl -s http://127.0.0.1:8080/v1/models   # サーバーが localhost で応答
VRAM が 13 GB 以下のカード
STRATA_ROUTE_PRIOR=1.5 は、ラウターにカードにすでにあるエキスパートを優先するよう指示します。RTX 3060 12 GB で IQ3_XXS を実行する Strata のノートによると、prior をオフにした状態に対して、ストーリーデコードが +15%、コードデコードが +37% 向上し、エージェントタスクのパス数が減少しました: 平均 4 回実行で 10 中 4.5、prior オフの 7 回実行では 5.6 です。バージョン 0.2.7 は、13 GiB 以下の離散 NVIDIA カードに 1.5 を自動的にオンにしました。バージョン 0.2.8 は、反復と弱い長いエージェントセッション(issue #4402)の後、2026年10月29日 にそれをオフに戻しました。変数が未設定の場合、0.2.11 は 0.2.6 と同じようにルーティングします。プロジェクトは、この prior を 12 GB カードでのチャットと短い回答に向かい、長いエージェント実行には向かないと指摘しています。
テストベッド: エージェントを実行する 64 GB デスクトップ
測定されたボックス:
| コンポーネント | 仕様 |
|---|---|
| CPU | Intel Core Ultra 7 265 (20 コア、DDR5-6400 デュアルチャネル ≈ 102 GB/s) |
| GPU | RTX 5090, 32 GB |
| RAM | 64 GB |
| OS | Ubuntu 26.04 |
| 同時に実行中 | Hermes VM 用の KVM ホスト、Cursor IDE、ブラウザ |
ISTA IQ3_XXS では、レジデントシャードは 47 GB です。エキスパートがピン留めされているため、その他すべてには約 9 GB が残ります。Hermes 本番セットアップ におけるエージェントスタックである Hermes VM、および Cursor を加えると、約 5 GB が残り、長いエージェントセッションのページキャッシュや KV キャッシュには不十分です。
ISTA IQ3_S は、日常デスクトップとしてこのマシンに収まりません。54.8 GB のレジデントシャードと 28.8 GB のマップされた n-gram テーブルで、64 GB を使用します。Cursor が実行されている場合、3 GB が空で、Hermes VM の行き場所がありません。
| 設定 | レジデント | 空き RAM (モデルのみ) | 空き RAM (モデル + VM + Cursor) | デコード (測定) | エージェント判定 |
|---|---|---|---|---|---|
| IQ3_XXS (3.00 bpw) | 47 GB | ~9 GB | ~5 GB | – | ツール呼び出しが定期的に失敗; 日常ドライバーにはならない |
| IQ3_S (3.50 bpw) | 54.8 GB + 28.8 GB mmap | ~3 GB (Cursor のみ) | – | 100–130 tok/s | ヘッドルーム皆無; 使用不可 |
IQ3_S は 100–130 トークン/秒でデコードし、これは Qwen 3.6 MTP 比較 における MTP 3 付き llama.cpp の 27B ビルドと同様の速度クラスです。RAM バジェットに収まるパック(IQ3_XXS)は、ツール呼び出しの形式を見逃すものです。ISTA が推奨するパック(IQ3_S)は、デスクトップの他の部分にスペースを残しません。
IQ3_XXS では、モデルは不正なツール呼び出し引数を出力し、スキーマにないツール名を捏造し、短い思考ブロックの後、同じコマンドを 3 から 5 回再発行しました。ハネスは各ミス再試行として扱うため、セッションは同じエラーで埋め尽くされます。このハードウェアにおいて、IQ3_XXS はエージェントモデルではありません。
コミュニティの報告
issue スレッドと 0.2.11 ノートからの、Strata における Qwen3.8-Flash-Next の速度報告:
| セットアップ | 結果 |
|---|---|
| 2× RTX 4090 | プロンプト 6,553 t/s、シングルストリームデコード 271 t/s |
| RTX 5080 + 4060 Ti、32 GB RAM | デコードピーク 200+ tok/s |
| 12 GB VRAM + 32 GB RAM、エキスパートを CPU にオフロード | ~65 tok/s; q8 KV での 199K コンテキストのコメント 1 件: プロンプト 1,740 t/s、デコード ~21.5 t/s |
| RTX 5070 12 GB + 64 GB RAM、IQ3_S | デコード 85–100 tok/s |
| Pro 6000 + 2× 3090、256 GB RAM、Unsloth 6-bit、160K コンテキスト | llama-server から Strata に切り替えた後、デコード 70–80 → 150 tok/s |
| RTX 2060 ラップトップ、32 GB RAM + 6 GB VRAM | Q2_0 が動作する |
| RTX 3060 12 GB、UD-IQ1_M、短いプロンプト (0.2.11 ノート) | デコード 31–37 tok/s、カード上のエキスパート 18% |
低ビット Qwen3.8-Flash-Next のエージェントワークロードにおいて、3 つの失敗モードが記述されています。
-
スキーマのサイズに沿って変化する、壊れたツール呼び出しの出力。 Issue #1431 によれば、39 関数のスキーマ(約 12K トークン)と 6K システムプロンプトで、Strata 0.1.40 上の IQ3_XXS は、20 回以上の制御された再現の約 30〜50% で使用可能なターンを生成しました。モデルは、パーサーがマッピングできないツール呼び出しの形状を出力した(テキストが
finish_reason: stopとともにcontentに着地)か、思考ブロックを閉じ、呼び出しも回答もない状態でシーケンス終了を出力しました。同じ重みで llama.cpp は、8 回以上の連続実行すべてでツール呼び出しを解析できました。llama.cpp は出力を PEG グラマーで制約し、壊れた内容をtool_callsに引き戻します。後でテキストを修復するラッパーは、トークンがすでに選択されている後に修復が実行されるため、有用ターンの割合を 30〜50% のバンドを上回ることはありませんでした。 -
設定エラーと非決定論的なエキスパートパス。 Issue #2685 によれば、RTX 5070、IQ3_S、60 GB RAM で、Strata を通じたツール呼び出しが失敗しました: 不正な引数、ハルシネーションされたツール、リトライループ。サンプリングブロックと
tool_call_recoveryがオンにされた後でも同様でした。同じ量子化はllama serveを通じて、同じハネスの 5 回中 5 回で成功しました。報告者は、同一のシードがプリフィル中に MMQ エクスパートパスで分岐し、そのパスを無効にすると実行がビット単位で同一になることを発見しました。Strata 0.1.44 は決定論性の修正を提供しました。その後の報告でも、Strata が同じ量子化で llama.cpp に匹敵することは示されていません。 -
思考ブロック内のままのツール呼び出し。 Issue #804 によれば、閉じられていない
thinkブロック内の完全なツール呼び出しは、reasoning_contentとして戻り、contentは空でtool_callsはなく、エージェントループが停止します。1 ユーザーは、IQ3_XXS、IQ2_XS、Coder ビルドで Hermes を使用し、約 1,300 の実エージェント応答で、約 100 回に 1 回と数えました。
なぜ Q4 未満はエージェントツール呼び出しを壊すのか
ツール呼び出しはワイヤーフォーマットに一致する必要があります。3-bit では、この 125B モデルは一部のターンでそのフォーマットを見逃し、見逃しはツールスキーマのコンテキストとともに増加します。より大きなスキーマは、呼び出しをフォーマットするワーキングメモリにより多くのことを求め、量子化ノイズはそのフォーマットに落ちます。チャットターンでは隠せます。ツール呼び出しが中心のエージェントターンでは、隠せません。
同じ圧縮は、アクティブのパラメータが少ないほど、より強く傷つけます。OpenCode ためのローカル LLM 比較 は、IQ3_XXS での密 27B に対し、構造化エージェントタスクで約 5% のエラー率を測定しました。同様のビット幅での低アクティブ MoE チェックポイントはより強く失敗しました: 35B-A3B は IQ3_S で 64.2%、IQ4_XS で 98.8% のエラー、122B-A10B は IQ3_S で 80%、IQ3_XXS で 90% のエラーです。Qwen3.8-Flash-Next はトークンあたり 6B パラメータをアクティブ化するため、3-bit パックは重い量子化における小さなモデルのように振る舞います。それらの OpenCode 実行は、35B-A3B と 122B-A10B において IQ3 と IQ4 が構造化タスクを見逃すことを示しますが、Flash-Next の Q5 実行を含みません。Strata の UD-IQ4_XS-v31 は 0.2.11 以降ダウンロード可能ですが、ここで確認したソースにはエージェントタスクの比較がなく、64 GB のボックスに収まりません。
同じ GSQ-RCO 重みは、llama.cpp や Ollama で読み込まれた場合も失敗します。llama.cpp はまだ、グラマーで出力を制約し、壊れたスパンを tool_calls に引き戻せるため、クライアントは壊れた文字列の代わりに呼び出しを見ます。Strata の JSON モードは、エンジンノートによると、スキーマプロンプティングと生成後のチェックであり、グラマー制約デコーディングではありません: 悪いオブジェクトは structured_output_failed とともに HTTP 502 を返します。tool_call_recovery とその後のリリースは、上記の 4 つの形状を修復します。それらはモデルがサンプリングする分布を変えません。それが issue #1431 のラッパーが出力率を超えて登れなかった理由です。
Strata は CPU と GPU を同期させ続けるために RAM を費やします。64 GB では、デスクトップとエージェント VM にスペースを残す最大の ISTA パックは IQ3_XXS ですが、そのパックはここで測定された出力閾値を下回っています。IQ3_S はすでに MTP 3 付きの 27B モデルと同様のバンドでデコードするため、そのパックの限界は RAM です。遅延マップを伴う llama.cpp の実行は、より少ない RAM をコミットし、Strata がこのモデルで 2 つのうち速いものになるデコード速度を諦めることになります。
結論
Qwen 2.8 Flash Next は、エージェントベンチマークで Qwen3.8-27B を上回ります: DeepSWE 58.7 対 42.2、JobBench 55.7 対 33.4、Toolathlon 73.5 対 67.1。マルチステップ作業は明らかにより有能です。トークンごとの計算は、125B モデルよりも小さなモデルに近いものです。
Q4 未満の量子化は、エージェント作業のための信頼性の高いツール呼び出し出力を提供せず、Strata と llama.cpp の両方でリトライループを生成する割合で失敗します。Q4 のパフォーマンスは、エージェントベンチマークでの制御された比較による証明はまだされていません。Q5 クラスの量子化は、信頼できるエージェント作業のために実証された最低限です; Unsloth UD-Q5_K_XL は存在しますが、公表されたベンチマークはありません。
M5 Max と 128 GB ユニファイドメモリを搭載した Mac Studio は、105 GB MLX ビルドまたはエージェントスタックに十分なヘッドルームを持つ Q4 パックを保持できます。QFN アーキテクチャはこのオフローディングモデルのために設計されました。
私は現在、私のセットアップで引き続き使用している NVFP4 27B モデル — RTX 5090 上で 17 GB — を MTP 3 付きで使用しています。信頼できるツール呼び出しと RAM 競争なしで 100+ トークン/秒を実現しています。QFN に戻るのは、エージェントタスクで Q4 クラスの量子化がベンチマークされた時、Strata の出力回復が成熟した時、またはハードウェアがアップグレードされた時です。
参考文献
- Niko1221/Strata — この記事の推論エンジン。SGLang ための階層型 KV キャッシュ論文 (OSDI 2026) は同じ名前を持つ別のプロジェクトです。
- Strata 0.2.11 リリースノート — Unsloth Dynamic v3.1 パック、Q5_0 演算、上記で引用された短いプロンプト速度。
- エンジンノート (
docs/DETAILS.md) — サンプリングの優先順位、tool_call_recovery、ルート優先度の測定。 - Qwen/Qwen3.8-Flash-Next — アーキテクチャ、サンプリングプリセット、ベンチマーク表。
- ISTA-DASLab Qwen3.8-Flash-Next GSQ-RCO GGUFs — テストベッドでの Q2 と IQ3 ビルド。
- Issue #1431、issue #2685、issue #804、および issue #4402 — コミュニティと小型カードセクションの失敗報告。
有用なリンク
- 16 GB VRAM GPU での Ollama 向け最良の LLM の選択 — カードが制限の場合の密モデルの代替。
- Ollama チートシート — 同じ GGUF がインポートできる別のローカルサーバー。
