
オープンモデルの効率的フロンティア:2026年の最適点を探る
2026年のオープンLLMにおける最適解:30B前後
2026年9月、オープンモデルにおける効率的フロンティアは25B〜34Bパラメータの間に位置しています。単一の24GB GPUで、70Bクラスのハードウェアを遥かに上回るコスト効率で、フロンティアに近いエージェント系タスクが実行可能です。
2026年のオープンLLMにおける最適解:30B前後
2026年9月、オープンモデルにおける効率的フロンティアは25B〜34Bパラメータの間に位置しています。単一の24GB GPUで、70Bクラスのハードウェアを遥かに上回るコスト効率で、フロンティアに近いエージェント系タスクが実行可能です。
16GBでは128Kコンテキストが死ににくい理由
モデルが128Kのコンテキストウィンドウを宣伝していても、16 GBのGPUでは40Kトークンで失敗する可能性があります。アーキテクチャ上の上限は、重み、KVキャッシュ、計算バッファ、そしてデスクトップコンポジターが同時にあなたのGPUに収まることを約束したことはありませんでした。
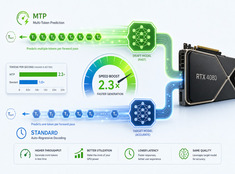
品質を落とさずにLLM推論を高速化する実践ガイド
70Bモデルは1回のフォワードパスで1トークンを生成し、各パスでVRAMから重みを読み込み、コンテキスト全体のAttentionを計算し、メモリを同期します。トークンの間では、GPUはシーケンシャルな依存関係が解決するのを待っている間にアイドル状態になります。
RTX 4080におけるMTPと標準デコーディングの実ベンチマーク比較
Qwen 3.6 27B と 35B において、RTX 4080(16 GB VRAM)上で投機的デコーディング(マルチトークン予測、MTP)のパフォーマンスをテストしました。
「雰囲気」に頼る解析をやめ、契約を検証せよ。
ほとんどのLLM「構造化出力」チュートリアルは、本気度にかけるものです。 それらは、JSONを丁寧な口調でリクエストし、モデルが適切に動作することを祈る方法を教えます。 それでは検証ではありません。 それは単に括弧で囲まれた楽観主義にすぎません。
エージェント型LLMのチューニングに関する参照資料
このページは、エージェント型LLM推論チューニングの実用的なリファレンス(temperature、top_p、top_k、ペナルティ、およびマルチステップやツール多用なワークフローにおけるそれらの相互作用)です。
より広範なLLMパフォーマンスエンジニアリングハブと併せて参照し、明確なLLMホスティングとサービングの概要と組み合わせることで、モデルがリソース不足に陥った際にはスループットとスケジューリングが依然として支配的ですが、不安定なサンプリングはGPUが処理を終える前にリトライと出力トークンを消費してしまうことがわかります。
このページでは以下をまとめます:
現在、以下に焦点を当てています:
llama.cppの16 GB VRAMにおけるトークン速度(テーブル)。
ここでは、16GBのVRAMを備えたGPUで動作する複数のLLM(大規模言語モデル)の速度を比較し、セルフホスティングに最適なモデルを選びます。
これらのLLMは、llama.cpp上で19K、32K、64Kトークンのコンテキストウィンドウで実行しました。
スタイライズされたGPUとVRAMブロック、およびベンチマーク風のチャート
この記事では、速度という観点から、可能な限り高いパフォーマンスを引き出そうとした試みを記録しています。
| モデル | サイズ | 19K VRAM | 19K GPU/CPU | 19K T/s | 32K VRAM | 32K 負荷 | 32K T/s | 64K VRAM | 64K 負荷 | 64K: T/s |
|---|---|---|---|---|---|---|---|---|---|---|
| Qwen3.6-35B-A3B-UD-IQ3_XXS | 13.2 | 13.8GB | 96%/100% | 147.5 | 14.0GB | 96%/101% | 149.1 | 14.7GB | 96%/101% | 145.8 |
| Qwen3.6-35B-A3B-UD-IQ4_XS | 17.7 | 14.3GB | 62%/266% | 95.0 | 14.9GB | 58%/279% | 92.3 | 14.9GB | 57%/293% | 86.4 |
| Qwen3.5-35B-A3B-UD-IQ3_S | 13.6 | 14.3GB | 93%/100% | 136.4 | 14.6GB | 93%/100% | 138.5 | 14.9GB | 88%/115% | 136.8 |
| Qwen3.5-27B-IQ3_XXS-bartowsky | 11.3 | 12.8 | 98/100 | 44.9 | 13.5 | 98/100 | 44.9 | 14.5 | 45/415 | 23.6 |
| Qwen3.5-27B-UD-IQ3_XXS | 11.5 | 12.9 | 98/100 | 45.3 | 13.7 | 98/100 | 45.1 | 14.7 | 45/410 | 22.7 |
| Qwen3.5-27B-IQ4_XS.gguf | 15.0 | 14.6 | 49/406 | 20.5 | 14.7 | 37/465 | 17.4 | 14.7 | 23/533 | 13.3 |
| Qwen3.5-122B-A10B-UD-IQ3_XXS | 44.7 | 14.7 | 30/470 | 22.3 | 14.7 | 30/480 | 21.8 | 14.7 | 28/490 | 21.5 |
| Qwen3.5-122B-A10B-UD-IQ3_S | 46.5 | 14.7 | 25/516 | 19.4 | 14.7 | 24/516 | 19.5 | 14.7 | 24/516 | 19.6 |
| Mistral-Small-4-119B UD-IQ3_XXS | 42.8 | 14.8 | 28/585 | 30.4 | 14.7 | 27/574 | 28.5 | 14.9 | 20/590 | 31.5 |
| Qwen3-Coder-Next-UD-IQ4_XS | 38.4 | 14.6 | 32/460 | 41.1 | 14.7 | 29/440 | 41.3 | 14.8 | 32/460 | 38.3 |
| Nemotron Super 120b IQ3_XXS | 56.2 | 15.0 | 26/517 | 17.5 | 14.6 | 26/531 | 17.4 | 14.6 | 26/535 | 17.6 |
| gemma-4-26B-A4B-it-UD-IQ4_XS | 13.4 | 14.7 | 95/100 | 121.7 | 14.9 | 95/115 | 114.9 | 14.9 | 75/190 | 96.1 |
| gemma-4-31B-it-UD-IQ3_XXS | 11.8 | 14.8 | 68/287 | 29.2 | 14.8 | 41/480 | 18.4 | 14.8 | 18/634 | 8.1 |
| GLM-4.7-Flash-IQ4_XS | 16.3 | 15.0 | 66/240 | 91.8 | 14.9 | 62/262 | 86.1 | 14.9 | 53/313 | 72.5 |
| GLM-4.7-Flash-REAP-23B IQ4_XS | 12.6 | 13.7 | 92/100 | 122.0 | 14.4 | 95/102 | 123.2 | 14.9 | 71/196 | 97.1 |
19K、32K、64Kはコンテキストサイズを指します。
RTX 4080(VRAM 16GB)におけるLLM速度テスト
大規模言語モデル(LLM)をローカルで実行することで、プライバシーの保護、オフラインでの利用、そしてAPIコストのゼロ化を実現できます。 このベンチマークでは、RTX 4080上でOllamaを使用する14のポピュラーなLLMの性能について、何を期待できるかを具体的に明らかにします。
BAMLとInstructorによる型安全なLLM出力
プロダクション環境で大規模言語モデル(LLM)を扱う際、構造化され、型安全性のある出力を得ることが極めて重要です。 この問題の解決策として、2つの人気フレームワーク—BAMLとInstructor—がそれぞれ異なるアプローチを採用しています。
インテリジェントなトークン最適化でLLMコストを80%削減
トークン最適化は、コスト効率の高いLLMアプリケーションと、予算を浪費するだけの実験を分ける重要なスキルです。
GPT-OSS 120bの3つのAIプラットフォームにおけるベンチマーク
私は、Ollama上でGPT-OSS 120bのパフォーマンステストを3つの異なるプラットフォームで確認しました:NVIDIA DGX Spark, Mac Studio, and RTX 4080。OllamaライブラリのGPT-OSS 120bモデルは65GBあり、これはRTX 4080(または新しいRTX 5080の16GB VRAMには収まらないことを意味します。
ASICおよびカスタムシリコンにより、LLM推論の速度と効率を追求する
これらの2つのモデルの速度、パラメータ、性能を比較する
以下は、Qwen3:30b と GPT-OSS:20bの比較です。 指示への追従(Instruction Following)および性能パラメータ、仕様、速度に焦点を当てています。
あまり良くない。
OllamaのGPT-OSSモデルは、LangChainやOpenAI SDK、vllmなどのフレームワークと使用する際に、構造化された出力を処理する際に繰り返し問題が発生しています。
わずかに異なるAPIには、特別なアプローチが必要です。
主要なLLMプロバイダーで構造化出力(信頼性の高いJSONの取得)を並べて比較したサポート状況と、最小限のPythonの例をご紹介합니다。