
オープンモデルの効率的フロンティア:2026年の最適点を探る
2026年のオープンLLMにおける最適解:30B前後
2026年9月、オープンモデルにおける効率的フロンティアは25B〜34Bパラメータの間に位置しています。単一の24GB GPUで、70Bクラスのハードウェアを遥かに上回るコスト効率で、フロンティアに近いエージェント系タスクが実行可能です。
2026年のオープンLLMにおける最適解:30B前後
2026年9月、オープンモデルにおける効率的フロンティアは25B〜34Bパラメータの間に位置しています。単一の24GB GPUで、70Bクラスのハードウェアを遥かに上回るコスト効率で、フロンティアに近いエージェント系タスクが実行可能です。
16GBでは128Kコンテキストが死ににくい理由
モデルが128Kのコンテキストウィンドウを宣伝していても、16 GBのGPUでは40Kトークンで失敗する可能性があります。アーキテクチャ上の上限は、重み、KVキャッシュ、計算バッファ、そしてデスクトップコンポジターが同時にあなたのGPUに収まることを約束したことはありませんでした。
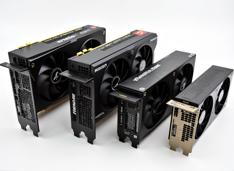
3社によるAI GPUの比較
2026年、AIハードウェアの状況は大きく変化しました。NVIDIA、AMD、Intelの各社が、ローカル環境で大型言語モデル(LLM)やAI推論ワークロードを実行できるGPUを必要とする開発者を獲得するため、激しい競争を繰り広げています。
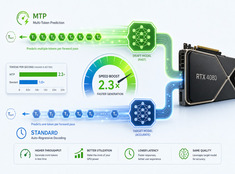
RTX 4080におけるMTPと標準デコーディングの実ベンチマーク比較
Qwen 3.6 27B と 35B において、RTX 4080(16 GB VRAM)上で投機的デコーディング(マルチトークン予測、MTP)のパフォーマンスをテストしました。
llama.cppの16 GB VRAMにおけるトークン速度(テーブル)。
ここでは、16GBのVRAMを備えたGPUで動作する複数のLLM(大規模言語モデル)の速度を比較し、セルフホスティングに最適なモデルを選びます。
これらのLLMは、llama.cpp上で19K、32K、64Kトークンのコンテキストウィンドウで実行しました。
スタイライズされたGPUとVRAMブロック、およびベンチマーク風のチャート
この記事では、速度という観点から、可能な限り高いパフォーマンスを引き出そうとした試みを記録しています。
| モデル | サイズ | 19K VRAM | 19K GPU/CPU | 19K T/s | 32K VRAM | 32K 負荷 | 32K T/s | 64K VRAM | 64K 負荷 | 64K: T/s |
|---|---|---|---|---|---|---|---|---|---|---|
| Qwen3.6-35B-A3B-UD-IQ3_XXS | 13.2 | 13.8GB | 96%/100% | 147.5 | 14.0GB | 96%/101% | 149.1 | 14.7GB | 96%/101% | 145.8 |
| Qwen3.6-35B-A3B-UD-IQ4_XS | 17.7 | 14.3GB | 62%/266% | 95.0 | 14.9GB | 58%/279% | 92.3 | 14.9GB | 57%/293% | 86.4 |
| Qwen3.5-35B-A3B-UD-IQ3_S | 13.6 | 14.3GB | 93%/100% | 136.4 | 14.6GB | 93%/100% | 138.5 | 14.9GB | 88%/115% | 136.8 |
| Qwen3.5-27B-IQ3_XXS-bartowsky | 11.3 | 12.8 | 98/100 | 44.9 | 13.5 | 98/100 | 44.9 | 14.5 | 45/415 | 23.6 |
| Qwen3.5-27B-UD-IQ3_XXS | 11.5 | 12.9 | 98/100 | 45.3 | 13.7 | 98/100 | 45.1 | 14.7 | 45/410 | 22.7 |
| Qwen3.5-27B-IQ4_XS.gguf | 15.0 | 14.6 | 49/406 | 20.5 | 14.7 | 37/465 | 17.4 | 14.7 | 23/533 | 13.3 |
| Qwen3.5-122B-A10B-UD-IQ3_XXS | 44.7 | 14.7 | 30/470 | 22.3 | 14.7 | 30/480 | 21.8 | 14.7 | 28/490 | 21.5 |
| Qwen3.5-122B-A10B-UD-IQ3_S | 46.5 | 14.7 | 25/516 | 19.4 | 14.7 | 24/516 | 19.5 | 14.7 | 24/516 | 19.6 |
| Mistral-Small-4-119B UD-IQ3_XXS | 42.8 | 14.8 | 28/585 | 30.4 | 14.7 | 27/574 | 28.5 | 14.9 | 20/590 | 31.5 |
| Qwen3-Coder-Next-UD-IQ4_XS | 38.4 | 14.6 | 32/460 | 41.1 | 14.7 | 29/440 | 41.3 | 14.8 | 32/460 | 38.3 |
| Nemotron Super 120b IQ3_XXS | 56.2 | 15.0 | 26/517 | 17.5 | 14.6 | 26/531 | 17.4 | 14.6 | 26/535 | 17.6 |
| gemma-4-26B-A4B-it-UD-IQ4_XS | 13.4 | 14.7 | 95/100 | 121.7 | 14.9 | 95/115 | 114.9 | 14.9 | 75/190 | 96.1 |
| gemma-4-31B-it-UD-IQ3_XXS | 11.8 | 14.8 | 68/287 | 29.2 | 14.8 | 41/480 | 18.4 | 14.8 | 18/634 | 8.1 |
| GLM-4.7-Flash-IQ4_XS | 16.3 | 15.0 | 66/240 | 91.8 | 14.9 | 62/262 | 86.1 | 14.9 | 53/313 | 72.5 |
| GLM-4.7-Flash-REAP-23B IQ4_XS | 12.6 | 13.7 | 92/100 | 122.0 | 14.4 | 95/102 | 123.2 | 14.9 | 71/196 | 97.1 |
19K、32K、64Kはコンテキストサイズを指します。
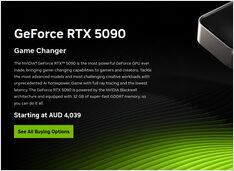
オーストラリアではRTX 5090は供給不足であり、価格が高騰しています。
オーストラリアにはRTX 5090の在庫があります。 ただし、ごくわずかです。 もし見つけたとしても、現実感の欠けた、莫大なプレミアム価格を支払わなければなりません。
GPUと永続化対応のコンポーズファーストOllamaサーバー。
Ollama はベアメタル上で非常に良好に動作します。サービスとして扱うようになると、さらに興味深いものになります。安定したエンドポイント、ピン留めされたバージョン、永続化ストレージ、そして利用可能かどうかの明確な GPU。
RTX 4080(VRAM 16GB)におけるLLM速度テスト
大規模言語モデル(LLM)をローカルで実行することで、プライバシーの保護、オフラインでの利用、そしてAPIコストのゼロ化を実現できます。 このベンチマークでは、RTX 4080上でOllamaを使用する14のポピュラーなLLMの性能について、何を期待できるかを具体的に明らかにします。
Linuxワークフローに適したターミナルを選択する
Linuxユーザーにとって最も欠かせないツールの一つがターミナルエミュレーターです。
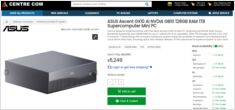
オーストラリアの小売業者から、リアルなオーストラリアドルでの価格を今すぐ。
NVIDIA DGX Spark (GB10 Grace Blackwell) は、主要な PC 小売店に国内在庫があり、オーストラリアで入手可能 となっています。 世界的な DGX Spark の価格と入手性 を追いかけていただいている方なら、オーストラリアでの価格帯はストレージ構成や小売店によって 6,249 オーストラリアドルから 7,999 オーストラリアドル であることが、ご関心をお持ちいただけるでしょう。
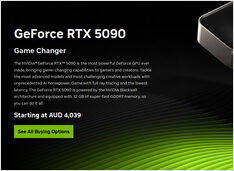
AI 向けコンシューマー GPU の価格 - RTX 5080 と RTX 5090
特に大規模言語モデル(LLM)向け、そして AI 全般に適した、トピレベルの消費者用 GPU の価格を比較してみましょう。 具体的には、RTX-5080 と RTX-5090 の価格 に注目しています。
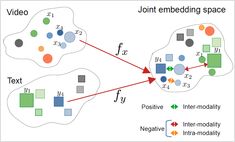
テキスト、画像、音声を共有された埋め込み空間に統一する
クロスモーダル埋め込みは、人工知能において画期的な進展をもたらし、統一された表現空間内で異なるデータタイプ間の理解と推論を可能にします。
オープンモデルを活用して、予算内のハードウェアでエンタープライズAIをデプロイする
AI の民主化はここにやってきました。 Llama、Mistral、Qwen などのオープンソース大規模言語モデル(LLM)が現在、プロプライエタリなモデルと競合するレベルに達しており、チームは 消費级ハードウェアを使用した AI インフラストラクチャ を構築することで、コストを削減しながらもデータプライバシーとデプロイの完全な制御を維持することが可能になりました。
Docker Model Runnerでコンテキストサイズを設定する際の回避策
Docker Model Runnerにおけるコンテキストサイズの設定は、本来よりも複雑です。
テキスト指示を使って画像を拡張するためのAIモデル
ブラックフォレスト・ラボズは、FLUX.1-Kontext-devという高度な画像から画像へのAIモデルをリリースしました。このモデルは、テキストの指示を使って既存の画像を補強します。
NVIDIA CUDAをサポートしたDocker Model RunnerでGPU加速を有効にする
Docker Model Runner は、Dockerが公式に提供するローカルでAIモデルを実行するためのツールですが、
Docker Model RunnerにおけるNVidia GPUの加速の有効化 には特定の設定が必要です。