
OpenClaw: ascesa e caduta — cronologia e reali motivi del crollo
OpenClaw è cresciuta rapidamente. Poi è scomparsa ancora più velocemente.
OpenClaw non ha fallito come prodotto. Ha perso il suo combustibile.
OpenClaw è cresciuta rapidamente. Poi è scomparsa ancora più velocemente.
OpenClaw non ha fallito come prodotto. Ha perso il suo combustibile.
Servire e sostituire LLM senza riavvi.
Per molto tempo, llama.cpp ha avuto una limitazione evidente:
era possibile servire solo un modello per processo, e cambiare modello richiedeva un riavvio.
Confronto tra strumenti PKM, metodologie e wiki self-hosted.
La gestione della conoscenza personale abbraccia Obsidian, Logseq, DokuWiki, Zettelkasten e PARA — la scelta giusta dipende da ciò che desideri: un grafo di note locale, un wiki self-hosted o un flusso di lavoro guidato da un outliner.
Configurazioni Hermes orientate al profilo per carichi di lavoro impegnativi
L’assistente AI Hermes, documentato ufficialmente come Hermes Agent, non è posizionato come un semplice wrapper per le chat.
Le competenze da conservare e quelle da saltare
OpenClaw ha due storie di estensioni, ed è facile confonderle.
Le plugin estendono il runtime. Le competenze (skills) estendono il comportamento dell’agente.
Prima i plugin. Nomenclatura delle competenze in breve.
Questo articolo riguarda i plugin OpenClaw — pacchetti gateway nativi che aggiungono canali, fornitori di modelli, strumenti, voce, memoria, media, ricerca web e altre superfici runtime.
Come sono strutturati realmente i sistemi OpenClaw
OpenClaw sembra semplice nelle dimostrazioni. In produzione, diventa un sistema.

Ricerca AI self-hosted con LLM locali
Vane è una delle opzioni più pragmatiche nell’ambito della “ricerca AI con citazioni”: un motore di risposta self-hosted che combina il recupero live dal web con LLM locali o cloud, mantenendo l’intero stack sotto il vostro controllo.
Installazione e quickstart di Hermes Agent per sviluppatori
Hermes Agent è un assistente AI self-hosted, agnostico rispetto al modello, che funziona su un’ macchina locale o su un VPS a basso costo, opera tramite interfacce da terminale e di messaggistica e migliora nel tempo trasformando i task ripetitivi in abilità riutilizzabili.
Installa TGI, rilascia velocemente, debugga più rapidamente.
Text Generation Inference (TGI) ha un’energia molto specifica. Non è il più nuovo arrivato nella strada dell’inferenza, ma è quello che ha già imparato come la produzione si rompe -
Servire modelli open-source rapidamente con SGLang.
SGLang è un framework di serving ad alte prestazioni per grandi modelli linguistici e modelli multimodali, progettato per fornire inferenza a bassa latenza e alto throughput in tutto, da una singola GPU a cluster distribuiti.
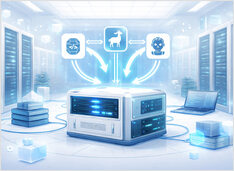
Hot-swap dei LLM locali senza modificare i client.
Presto ti ritroverai a gestire vLLM, llama.cpp e altri componenti, ognuno su una porta propria. Tutta l’infrastruttura a valle richiede comunque un unico /v1 come base URL; altrimenti continuerai a riordinare porte, profili e script one-off. llama-swap è il proxy /v1 da posizionare davanti a quegli stack.
La maggior parte delle configurazioni di AI locali parte da un modello e da un runtime.
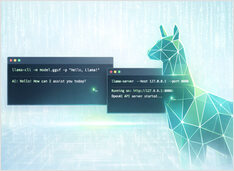
Eseguire modelli GGUF tramite CLI e server
llama.cpp è un motore di inferenza in C/C++ per modelli GGUF: llama-cli per la chat interattiva, llama-completion per prompt scriptizzati e llama-server per un’API HTTP compatibile con OpenAI.
Guida all'Assistente AI OpenClaw
La maggior parte delle configurazioni locali per l’IA inizia allo stesso modo: un modello, un runtime e un’interfaccia di chat.
Confronta i CMS headless - funzionalità, prestazioni e casi d'uso
Scegliere il giusto headless CMS può fare la differenza nel tuo piano di gestione del contenuto. Confrontiamo tre soluzioni open source che influenzano il modo in cui gli sviluppatori costruiscono applicazioni guidate dal contenuto.