
OpenClaw: ascesa e caduta — cronologia e reali motivi del crollo
OpenClaw è cresciuta rapidamente. Poi è scomparsa ancora più velocemente.
OpenClaw non ha fallito come prodotto. Ha perso il suo combustibile.
OpenClaw è cresciuta rapidamente. Poi è scomparsa ancora più velocemente.
OpenClaw non ha fallito come prodotto. Ha perso il suo combustibile.
Servire e sostituire LLM senza riavvi.
Per molto tempo, llama.cpp ha avuto una limitazione evidente:
era possibile servire solo un modello per processo, e cambiare modello richiedeva un riavvio.
Crea Claude Skills che resistano al lavoro reale
La maggior parte dei team usa in modo improprio Claude Skills in uno di due modi. O trasformano SKILL.md in un contenitore di tutto, o non riescono a superare la fase dei grandi prompt copiati e incollati.
Configurazioni Hermes orientate al profilo per carichi di lavoro impegnativi
L’assistente AI Hermes, documentato ufficialmente come Hermes Agent, non è posizionato come un semplice wrapper per le chat.
Le competenze da conservare e quelle da saltare
OpenClaw ha due storie di estensioni, ed è facile confonderle.
Le plugin estendono il runtime. Le competenze (skills) estendono il comportamento dell’agente.
Prima i plugin. Nomenclatura delle competenze in breve.
Questo articolo riguarda i plugin OpenClaw — pacchetti gateway nativi che aggiungono canali, fornitori di modelli, strumenti, voce, memoria, media, ricerca web e altre superfici runtime.
Come sono strutturati realmente i sistemi OpenClaw
OpenClaw sembra semplice nelle dimostrazioni. In produzione, diventa un sistema.
Gli abbonamenti a Claude non alimentano più gli agenti
La falla silenziosa che ha alimentato un’onda di sperimentazione con gli agenti è ora chiusa.
Ricerca AI self-hosted con LLM locali
Vane è una delle opzioni più pragmatiche nell’ambito della “ricerca AI con citazioni”: un motore di risposta self-hosted che combina il recupero live dal web con LLM locali o cloud, mantenendo l’intero stack sotto il vostro controllo.
Coding agentico, ora con backend di modelli locali.
Claude Code non è un’autocompletamento con un marketing migliore. È uno strumento di coding agentic: legge la tua codebase, modifica i file, esegue comandi e si integra con i tuoi strumenti di sviluppo.
Installazione e avvio rapido dell'agente Hermes per gli sviluppatori
L’agente Hermes è un assistente AI self-hosted, agnostico rispetto al modello, che opera su un computer locale o su un VPS a basso costo, funziona attraverso interfacce terminali e di messaggistica e migliora nel tempo trasformando le attività ripetitive in abilità riutilizzabili.
Installa TGI, rilascia velocemente, debugga più rapidamente.
Text Generation Inference (TGI) ha un’energia molto specifica. Non è il più nuovo arrivato nella strada dell’inferenza, ma è quello che ha già imparato come la produzione si rompe -
Velocità dei token di llama.cpp su 16 GB di VRAM (tabelle).
Qui sto confrontando la velocità di diversi LLM eseguiti su una GPU con 16 GB di VRAM, per scegliere quello migliore per l’auto-hospitng.
Server Ollama con approccio compose-first, GPU e persistenza.
Ollama funziona egregiamente su hardware nudo (bare metal). Diventa ancora più interessante quando lo si tratta come un servizio: un endpoint stabile, versioni bloccate, archiviazione persistente e una GPU che è disponibile o non lo è.
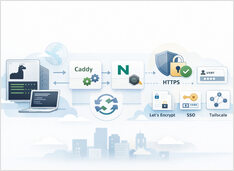
HTTPS per Ollama senza interrompere le risposte in streaming.
Eseguire Ollama dietro un proxy inverso è il modo più semplice per ottenere HTTPS, un controllo degli accessi opzionale e un comportamento di streaming prevedibile.
Servire modelli open-source rapidamente con SGLang.
SGLang è un framework di serving ad alte prestazioni per grandi modelli linguistici e modelli multimodali, progettato per fornire inferenza a bassa latenza e alto throughput in tutto, da una singola GPU a cluster distribuiti.