Oh My Opencode превращает OpenCode в многоагентскую среду для разработки: оркестратор делегирует работу специализированным агентам, которые выполняются параллельно.
Тест LLM OpenCode — статистика по кодированию и точности
Я протестировал, как OpenCode работает с несколькими локальными LLM, запущенными через Ollama и llama.cpp, а для сравнения добавил несколько бесплатных моделей из OpenCode Zen.
Познакомьтесь с Sisyphus и его командой специализированных агентов.
Наибольший скачок в возможностях OpenCode обеспечивается специализированными агентами: осозванным разделением оркестрации, планирования, выполнения и исследований.
OpenHands — это открытая платформа, не зависящая от конкретной модели, для агентов ИИ в сфере разработки программного обеспечения.
Она позволяет агенту вести себя скорее как партнер по программированию, чем как простой инструмент автодополнения.
Запустите собственные API, совместимые с OpenAI, с помощью LocalAI за несколько минут.
LocalAI — это самодостаточный сервер вывода с приоритетом на локальное использование, разработанный для работы как прямая замена OpenAI API для запуска ИИ-нагрузок на вашем собственном оборудовании (ноутбук, рабочая станция или сервер в центре обработки данных).
Инференс LLM выглядит как «еще один API» — до тех пор, пока не возникнут скачки задержки, не начнут накапливаться очереди, а ваши GPU не окажутся загружены по памяти на 95% без очевидной причины.
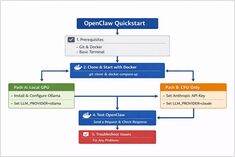
Локальная установка OpenClaw с использованием Ollama
OpenClaw — это автономный ИИ-ассистент, предназначенный для работы с локальными средами выполнения LLM, такими как Ollama, или с облачными моделями, такими как Claude Sonnet.
AWS S3 остаётся «стандартным» базовым решением для объектного хранилища: это полностью управляемая система, обеспечивающая высокую согласованность и разработанная для достижения экстремально высокой надёжности и доступности. Garage и MinIO — это самодеплируемые альтернативы, совместимые с S3: Garage предназначен для лёгких, географически распределённых небольших и средних кластеров, тогда как MinIO делает акцент на широком охвате функций API S3 и высокой производительности в крупных развёртываниях.
Гараж — это открытое, саморазмещаемое, совместимое с S3 объектное хранилище, предназначенное для небольших и средних развертываний с акцентом на устойчивость и геораспределение.
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.
Управляйте данными и моделями с помощью развернутых локально LLM
Хостинг больших языковых моделей (LLM) на собственных серверах обеспечивает контроль над данными, моделями и процессом инференса — это практический путь к суверенному искусственному интеллекту для команд, предприятий и целых стран.
Локальный запуск больших языковых моделей обеспечивает конфиденциальность, работу в автономном режиме и отсутствие затрат на API.
Данный бенчмарк точно показывает, чего можно ожидать от 14 популярных
LLM на Ollama на видеокарте RTX 4080.
Экосистема Go продолжает процветать с инновационными проектами, охватывающими инструменты ИИ, самоуправляемые приложения и инфраструктуру разработчиков. Этот обзор анализирует самые популярные репозитории Go на GitHub в этом месяце.
Сегодня мы рассматриваем топовые потребительские графические процессоры и модули оперативной памяти. Конкретно я смотрю на цены на RTX-5080 и RTX-5090, а также на 32ГБ (2x16ГБ) DDR5 6000.
Самостоятельно развёрнутая альтернатива ChatGPT для локальных LLM
Open WebUI — это мощный, расширяемый и функционально насыщенный веб-интерфейс для самостоятельного хостинга, предназначенный для взаимодействия с большими языковыми моделями.
Установка, обслуживание и настройка vLLM в 2026 году
vLLM — это высокопроизводительный, энергоэффективный движок вывода и обслуживания для больших языковых моделей (LLM), разработанный лабораторией вычислений Sky Computing Лейденского университета Беркли (UC Berkeley).