AI Coding

Решения при разработке программного обеспечения с использованием ИИ

Решения при разработке программного обеспечения с использованием ИИ

Держите намерение близко к коду.

Записи о принятых решениях — это недостающий слой памяти в разработке программного обеспечения с помощью ИИ. Они фиксируют не только то, что было построено, но и почему — и это различие становится критически важным, когда ваш код пишут инструменты на базе искусственного интеллекта.

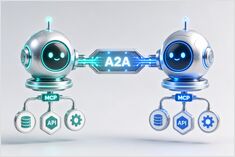
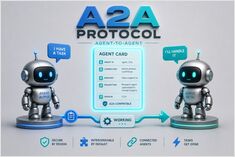
Что такое протокол A2A? Разбираем Agent Cards и Tasks

Что такое протокол A2A? Разбираем Agent Cards и Tasks

A2A превращает агентов в равноправных участников сети.

Протокол A2A (Agent-to-Agent Protocol), аббревиатура от Agent2Agent Protocol, представляет собой открытый стандарт для взаимодействия между независимыми системами ИИ-агентов.

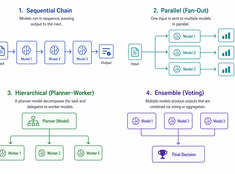
Проектирование систем с использованием множества моделей: когда одной модели недостаточно

Проектирование систем с использованием множества моделей: когда одной модели недостаточно

Выбирайте самый простой работающий паттерн.

Системы с одной моделью просты. Системы с множеством моделей мощны. Сложность не в выборе моделей — а в проектировании архитектуры, которая их оркестрирует.

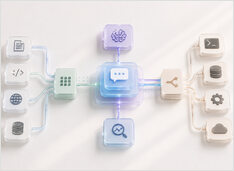
Архитектура ИИ-ассистента: LLM, память, инструменты, маршрутизация, наблюдаемость

Архитектура ИИ-ассистента: LLM, память, инструменты, маршрутизация, наблюдаемость

«Как на самом деле создаются серьезные ассистенты.»

Промышленный ИИ-ассистент — это не «LLM с промптом». Это система, которая принимает намерение, сохраняет состояние, принимает решения о поиске или выполнении действий и предоставляет достаточно информации о времени выполнения для отладки сбоев.

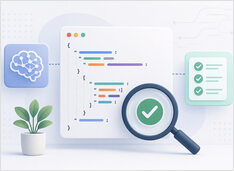
Валидация структурированного вывода LLM на Python, которая работает надёжно

Валидация структурированного вывода LLM на Python, которая работает надёжно

Перестаньте полагаться на интуицию. Валидируйте контракты.

Большинство руководств по «структурированному выводу» (structured output) для больших языковых моделей (LLM) не обладают должной серьезностью. Они учат вас вежливо просить модель выдавать JSON и затем надеяться, что она поступит правильно. Это не валидация. Это оптимизм, обернутый в фигурные скобки.

Справочник по параметрам агентного вывода LLM для Qwen и Gemma

Справочник по параметрам агентного вывода LLM для Qwen и Gemma

Справочное руководство по настройке агентов LLM

Эта страница представляет собой практическое руководство по настройке агентов на базе LLM (температура, top_p, top_k, штрафы и их взаимодействие в многоступенчатых рабочих процессах с интенсивным использованием инструментов).

Claude Skills и SKILL.md для разработчиков: VS Code, JetBrains, Cursor

Claude Skills и SKILL.md для разработчиков: VS Code, JetBrains, Cursor

Создавайте Claude Skills, которые выдерживают реальную работу

Большинство команд неправильно используют Claude Skills одним из двух способов. Либо они превращают SKILL.md в свалку информации, либо так и не переходят от огромных скопированных промптов к чему-то более структурированному.

Установка и настройка Claude Code для Ollama и llama.cpp, тарифы

Установка и настройка Claude Code для Ollama и llama.cpp, тарифы

Агентное программирование теперь поддерживает локальные модельные бэкенды.

Claude Code — это не автодополнение с более удачным маркетингом. Это агентный инструмент для кодирования: он читает вашу кодовую базу, редактирует файлы, выполняет команды и интегрируется с вашими инструментами разработки.

Быстрый старт SGLang: установка, настройка и развертывание больших языковых моделей через API OpenAI

Быстрый старт SGLang: установка, настройка и развертывание больших языковых моделей через API OpenAI

Запускайте открытые модели быстро с помощью SGLang.

SGLang — это высокопроизводительный фреймворк для развертывания больших языковых и мультимодальных моделей, созданный для обеспечения низколатентного и высокопроизводительного вывода на устройствах от одной GPU до распределенных кластеров.

Быстрый старт с обменом моделей llama для локальных LLM, совместимых с OpenAI

Быстрый старт с обменом моделей llama для локальных LLM, совместимых с OpenAI

Горячая замена локальных LLM без изменения клиентов.

Вскоре вы уже управляете несколькими инструментами: vLLM, llama.cpp и другими — каждый стек работает на своём собственном порту. При этом все последующие звенья цепочки по-прежнему ожидают один базовый URL /v1; иначе вам придётся постоянно перенастраивать порты, профили и разовые скрипты. llama-swap — это прокси для /v1, который размещается перед этими стеками.

Обзор Opencode: честные результаты, риски биллинга и когда это того стоит

Обзор Opencode: честные результаты, риски биллинга и когда это того стоит

Что происходит на самом деле при запуске Ultrawork.

Oh My Opencode обещает «виртуальную команду AI-разработчиков» — Сизиф координирует специалистов, задачи выполняются параллельно, а волшебное ключевое слово ultrawork активирует всё это.