
構造化出力によるLLMの制約:Ollama、Qwen3、PythonまたはGo
Ollamaから構造化された出力を取得するいくつかの方法
大規模言語モデル(LLM) は強力ですが、プロダクション環境では自由形式の段落を欲しがることは稀です。 むしろ、アプリケーションに投入できる予測可能なデータ(属性、事実、構造化オブジェクト)が欲しいのです。 それがLLM構造化出力です。
Ollamaから構造化された出力を取得するいくつかの方法
大規模言語モデル(LLM) は強力ですが、プロダクション環境では自由形式の段落を欲しがることは稀です。 むしろ、アプリケーションに投入できる予測可能なデータ(属性、事実、構造化オブジェクト)が欲しいのです。 それがLLM構造化出力です。
オラマモデルのスケジューリングに関する自分のテスト
ここでは、新しいバージョンのOllamaがモデルに対してどのくらいのVRAMを割り当てているかについて、Ollama VRAM割り当てと以前のOllamaバージョンを比較しています。新しいバージョンは、以前のバージョンよりも劣っています。
Ollama開発の現状についての私の見解
Ollamaは、LLM(大規模言語モデル)をローカルで実行するための最も人気のあるツールの一つに急速に成長しました。 そのシンプルなCLIと、洗練されたモデル管理は、クラウド外でAIモデルを扱いたい開発者にとって、定番の選択肢となっています。
2025年のOllamaで最も注目されているUIの概要
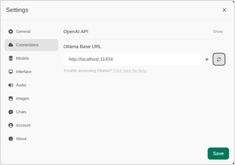
ローカルにホストされた Ollama は、あなたのマシン上で大規模言語モデルを実行できるが、コマンドライン経由での使用はユーザーにとって使いにくい。
以下に、ローカルの Ollama に接続するための、いくつかのオープンソースプロジェクトが提供する ChatGPTスタイルのインターフェース がある。
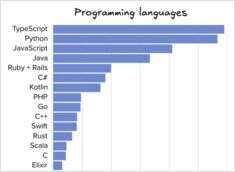
ソフトウェアエンジニアリングツールおよび言語の比較
The Pragmatic Engineerのレターは数日前に、2025年中盤におけるプログラミング言語、IDE、AIツールの普及状況などのデータを掲載しました。
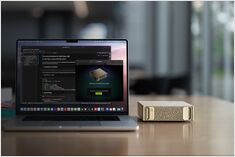
2025 年 7 月にもまもなく利用可能となるでしょう。
Nvidia 社がNVIDIA DGX Sparkの発売を控えています。これは Blackwell アーキテクチャを採用した小型 AI スーパーコンピュータで、128GB 以上の統一メモリと 1 PFLOPS の AI 性能を備えています。LLM を実行するに最適なデバイスです。
RAG を実装中ですか?Go のコードスニペットを紹介 - 2 部目
標準の Ollama には直接的なリランク API がないため、クエリ - ドキュメントペアのエンベッディングを生成してスコアリングを行うことで、Go 言語による Qwen3 Reranker を使ったリランキング を実装する必要があります。
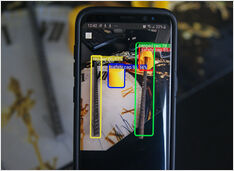
以前、オブジェクト検出AIのトレーニングを行いました。
ある寒い冬の7月の日… その日はオーストラリアにいた… 私は、未封のコンクリート補強筋を検出するためのAIモデルを訓練するという緊急の必要性を感じた…
Qwen3 8B、14Bおよび30B、Devstral 24B、Mistral Small 24B
このテストでは、Ollama上でホストされているさまざまなLLMがHugoページを英語からドイツ語に翻訳する方法を比較しています。英語からドイツ語への翻訳。
RAG の実装ですね。Golang 用のコードスニペットをいくつか紹介します。
この小さな Reranking Go コード例は、クエリと各候補ドキュメントの埋め込みを生成するために Ollama を呼び出し、 その後、コサイン類似度で降順にソートします。
LLMのために2枚目のGPUを追加する予定はありますか?
PCIeレーン数がLLMのパフォーマンスに与える影響? タスクによって異なります。トレーニングやマルチGPU推論では、パフォーマンスの低下が顕著です。
LLMでHTMLからテキストを抽出する...
Ollama モデルライブラリには、HTML コンテンツを Markdown に変換できるモデルが存在します。これはコンテンツ変換タスクに役立ちます。このガイドは、2026年のドキュメンテーションツール: Markdown、LaTeX、PDFおよび印刷ワークフロー ハブの一部です。
「あなたのタスクには、どのAIリサーチモードが適していますか?」
Cursor AI vs GitHub Copilot vs Cline AI vs…
ここでは、AI支援コーディングツールやAIコーディングアシスタントとその優れた点についていくつか紹介します。
LLMプロバイダーの短いリスト
LLMを使用することは非常に高価ではありません。新しい高性能なGPUを購入する必要がないかもしれません。LLMプロバイダーの一覧は、クラウド上のLLMプロバイダー で確認できます。それぞれが提供しているLLMについても記載されています。
インテルCPUにおけるOllamaの効率的なコアとパフォーマンスコアの比較
私はある仮説をテストしたいと思っています。すなわち、「インテルCPUのすべてのコアを活用することで、LLMの速度が向上するか?」というものです。このテストについては、ALL cores on Intel CPU would raise the speed of LLMs?をご覧ください。
新しいgemma3 27bitモデル(gemma3:27b、ollama上では17GB)が私のGPUの16GB VRAMに収まらず、部分的にCPU上での実行に頼っているという点が気になります。