
Hermesエージェントのための「Hindsight」:ローカルLLMによるセルフホスト型メモリ
自社ハードウェアでの永続的なHermesメモリ。
セルフホストするAIエージェントには、長いコンテキストウィンドウだけでは不十分です。有用な事実を保持し、過去の決定を呼び出し、プロジェクトの進化に伴って自分が知っていることを再考する仕組みが必要です。
Hermes Agent は、組み込みのメモリファイルを持っていますが、外部プロバイダを使用することで、セッションにわたるより豊かな検索が可能になります。Hindsight は、その分野で最も興味深い選択肢の一つです。このガイドでは、クラウド推論なしで Hindsight を Hermes にインストールする方法を解説します。まずオールインワン Docker コンテナとして、次に既存の PostgreSQL サーバーに対して個別のローカルモデルエンドポイントを使用する方法を扱います。
このガイドでは、デプロイメント、ローカルでの埋め込み・リランキング・生成モデルの選択と配線、auto-retain がバンクに書き込む内容の制御、Hermes への接続、そして運用レイヤー(バックアップ、移行、日常のバンク保守)を扱います。例では、意図的にポートスхемаを使用しています — メインの llama.cpp サーバーには 8080、埋め込みに 8081、リランキングに 8082、Ollama に 11434 — したがって、すでに使用しているポートに変更し、小さなサーバーをメインモデルのポートから分離してください。
Hindsight の機能
Hindsight は、3つの主要な操作を持つ永続的なエージェントメモリエンジンです:retain(保持)、recall(想起)、reflect(考察)。Retain は情報を抽出して保存し、recall は意味的、キーワード、グラフ、時間的検索を組み合わせて行います。Reflect は蓄積されたメモリから回答を合成します。バックグラウンドでの整理(consolidation)により、重複する観測をより有用な知識レイヤーに変えることができます。
これは単なる埋め込みデータベースではありません。ベクトルストアは類似の段落を特定できますが、メモリシステムは時系列、プロジェクトの境界、矛盾する証拠、決定の変化も保持する必要があります。これらの失敗モードは、自己強化型メモリループ で詳しく扱います。
より広い市場については、エージェントメモリプロバイダ比較 を参照してください。Hermes の組み込み MEMORY.md、USER.md、およびメモリモードは、Hermes Agent メモリシステム ガイドで扱われているため、この記事では組み込みレイヤーの動作を既知として前提とします。
なぜ Mnemosyne を超えるのか
Mnemosyne for Hermes は、SQLite ストレージやハイブリッド検索など魅力的なローカルファーストのアイデアを提供します。しかし実際には、インストール制約、バージョン互換性、書き込み承認の動作、4.0 プリリリース周辺の迅速な変更により、予測可能な動作が難しい場合があります。これらは運用上の懸念であり、Mnemosyne のメモリモデルが根本的に欠陥があるという証拠ではありません。
Hindsight も依存関係ゼロではありません。その Docker イメージとローカルモデルは、かなりのディスク容量を消費する可能性があります。推論を別場所で行い、その API を独立したサービスとして実行することで、アップグレードとトラブルシューティングをエージェント本体から分離できます。
デプロイメントの選択
| コンポーネント | A: オールインワンコンテナ | B: 既存の PostgreSQL サーバー |
|---|---|---|
| Hindsight API と UI | Docker コンテナ | Docker コンテナ |
| PostgreSQL | コンテナ内蔵の pg0 |
既存の PostgreSQL マシン |
| 生成 LLM | 外部 llama.cpp | 外部 llama.cpp |
| 埋め込み | デフォルトのローカルまたは外部 | 外部 Ollama または llama.cpp |
| リランキング | デフォルトのローカルまたは外部 | 外部リランクサーバー |
| 最適用途 | 迅速な評価 | 長期動作、分離されたインストール |
ここでは、「オールインワン」とは、Hindsight API、UI、データベースが1つのコンテナに含まれていることを意味しますが、推論用 LLM は依然として別ホストでホストされます。これは意図的なものです:Docker の公式 Hindsight イメージには、すぐに使えるローカル生成 llama.cpp サーバーがバンドルされていません。
別ホストで実行されているサービスには、localhost ではなく LAN で到達可能なアドレスを使用してください。これらのポートは信頼できるクライアントに制限してください;例の dummy キーは認証ではなく互換性用のプレースホルダーです。
オプション A: オールインワン Hindsight コンテナ
これは、Hermes VM を Python、Torch、ローカルモデルの依存関係で埋め込まずに Hindsight を評価する最も簡単な方法です。コンテナは Hindsight と内蔵 PostgreSQL を実行し、メインの llama.cpp LLM がメモリ抽出と reflect を処理します。
ここでは2つのイメージタグが重要です。ghcr.io/vectorize-io/hindsight:latest は大きなイメージです — AMD64 で約 9 GB — BGE エンベッダー、MiniLM リランカー、内蔵 PostgreSQL がバンドルされているためです。latest-slim は約 500 MB で、これら2つのモデルが別にあることを前提としています。これは、Hindsight を Serve and Wire Local Models セクションで示す埋め込みとリランキングの設定に向けた際に望ましいものです。ヘルスチェックが通過したら、特定のタグをピン留めしてください:動くタグは、保持しようとするデータベースには適していません。
Hindsight ホスト上でディレクトリと Compose ファイルを作成します:
mkdir -p ~/services/hindsight
cd ~/services/hindsight
cat > compose.yaml <<'YAML'
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest
    container_name: hindsight
    restart: unless-stopped
    shm_size: 1gb
    extra_hosts:
      - "host.docker.internal:host-gateway"
    ports:
      - "8888:8888"  # Memory API
      - "9999:9999"  # Control-plane UI
    environment:
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://WORKSTATION_IP:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
    volumes:
      - hindsight-pg0:/home/hindsight/.pg0
volumes:
  hindsight-pg0:
YAML
WORKSTATION_IP を llama.cpp を実行しているホストに変更してください。Linux では、host.docker.internal はコンテナが上記の host-gateway マッピングを宣言した場合にのみ解決されます;これがない場合、http://host.docker.internal:8080/v1 というベース URL はどこにもポイントしません。1 GB の共有メモリ予約は、内蔵 PostgreSQL のインデクシングに特に有用です;Docker の小さなデフォルト /dev/shm は失敗の原因になる可能性があります。名前付きボリュームにより、コンテナが再生成されてもデータベースが保持され、バインドマウントの代替案はイメージ内のユーザー(uid 1000)が所有するものでなければなりません。
HINDSIGHT_API_WORKER_ID は再生成間でも安定して保つべきです — Docker のデフォルトはコンテナのホスト名であり、コンテナが死亡した際に進行中だったタスクは、古い worker id の下でスタックしたままになります。
docker compose up -d
docker compose logs -f --tail=100
curl -f http://localhost:8888/health
インストールした Hindsight バージョンがヘルスを異なるパスに公開している場合は、http://localhost:8888/docs とコンテナログを確認してください。コントロールプレーンは通常 http://HINDSIGHT_HOST:9999 で利用可能です。基本的なデプロイメントが動作したら、コンテナ内でデフォルトモデルを読み込むのではなく、その埋め込みとリランキングプロバイダを Serve and Wire Local Models の設定に向けることもできます。
ポート 8888 または 9999 を直接インターネットに公開しないでください。 プライベートネットワークまたは認証付きリバースプロキシを使用してください。内蔵 PostgreSQL はテストには便利ですが、外部管理のデータベースはバックアップとメンテナンスが容易です。
オプション B: 既存の PostgreSQL サーバーに対する Hindsight
長期動作するインストールの場合、Hindsight API、データベース、推論エンドポイントを分離して保つことを好みます。Hindsight VM は重いモデルではなくオーケストレーションと HTTP サービスを実行するため、小さく保つことができます。
PostgreSQL と pgvector の準備
Hindsight には PostgreSQL 14 以降と hindsight データベース内のベクトル拡張機能が必要です。拡張機能はデータベースごとに適用されます:サーバーにパッケージをインストールするだけでは、そこに CREATE EXTENSION が実行されるまで何も起きません。Debian や Ubuntu の PostgreSQL サーバーでは、実際の PostgreSQL メジャーバージョンに一致する pgvector パッケージをインストールしてください;例えば、PostgreSQL 16 の場合:
sudo apt update
sudo apt install postgresql-16-pgvector
パッケージ名と可用性は、設定された apt リポジトリに依存します。利用できない場合は、pgvector インストール手順 に従ってください、または PostgreSQL PGDG リポジトリから互換パッケージをインストールしてください。共有サーバーで PostgreSQL のメジャーバージョンを盲目的に変更しないでください。
PostgreSQL 管理者として専用のロールとデータベースを作成します:
CREATE ROLE hindsight LOGIN PASSWORD 'REPLACE_WITH_LONG_PASSWORD';
CREATE DATABASE hindsight OWNER hindsight;
新しいデータベースに接続して拡張機能を有効にします:
sudo -u postgres psql -d hindsight -c \
  'CREATE EXTENSION IF NOT EXISTS vector;'
sudo -u postgres psql -d hindsight -c \
  "SELECT extname, extversion FROM pg_extension WHERE extname = 'vector';"
拡張機能は通常、インストールには特権昇格が必要ですが、アプリケーションロールはスーパーユーザーである必要はありません。Hindsight はデフォルトで pgvector を使用し、反復的 ANN スキャンには 0.8.0 以降を要求します;古いサーバーはそれを拒否します。HINDSIGHT_API_VECTOR_EXTENSION は代わりに pgvectorscale(非常に大きなバンクのための Hindsight が文書化している DiskANN オプション)または vchord を選択できますが、どちらもこの特定の PostgreSQL ビルドに追加のパッケージングが必要です。メモリが存在した後にアルゴリズムを切り替えると、起動が停止し移行が要求されるため、最初の retain の前に選択してください。個人の Hermes バンクにとって、pgvector をインストールしてそれで止めるのがよいでしょう。
pg_hba.conf により、Hindsight ホストのみを許可してください。例えば:
host hindsight hindsight 192.168.1.50/32 scram-sha-256
PostgreSQL の listen_addresses を適切に設定し、ホスト間の接続には TLS または信頼できるプライベートネットワークを使用してください。このデータベースは Hindsight Docker コンテナから独立してバックアップしてください。サーバーが他のアプリケーションと共有されている場合は、Hindsight を独自のデータベースに保つか、HINDSIGHT_API_DATABASE_SCHEMA を自分が所有するスキーマに設定してください;デフォルトのスキーマは public です。
PostgreSQL に対する Hindsight の実行
Hindsight VM に compose.yaml を作成します。このバージョンでは、意図的にローカルで PostgreSQL を開始しません:
services:
  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest-slim
    restart: unless-stopped
    ports:
      - "8888:8888"
      - "9999:9999"
    env_file: .env
    environment:
      HINDSIGHT_API_LLM_PROVIDER: openai
      HINDSIGHT_API_LLM_BASE_URL: http://WORKSTATION_IP:8080/v1
      HINDSIGHT_API_LLM_MODEL: LocalMegaLLM
      HINDSIGHT_API_LLM_API_KEY: dummy
      HINDSIGHT_API_LLM_MAX_CONCURRENT: "2"
      HINDSIGHT_API_DB_POOL_MIN_SIZE: "2"
      HINDSIGHT_API_DB_POOL_MAX_SIZE: "10"
      HINDSIGHT_API_WORKER_ID: hindsight-standalone
外部データベース URL を .env という名前のファイルに保存します:
HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:YOUR_PASSWORD@POSTGRES_IP:5432/hindsight
chmod 600 .env
docker compose up -d
docker compose logs -f --tail=100
パスワードに @、:、/ または他の予約 URL 文字が含まれている場合は、接続文字列に入れる前に URL エンコードしてください。Hindsight VM から PostgreSQL ポート 5432 に到達できること、および pg_hba.conf が Hindsight ホストを許可していることをテストしてください — 127.0.0.1 のみにバインドされたサーバーは、URL が正しく見える場合でも接続を拒否します。最初の起動でデータベース移行が実行されるのを許可してください;HINDSIGHT_API_RUN_MIGRATIONS_ON_STARTUP=false を設定しない限り、起動時に移行が実行されます。API とデータベースが立ち上がったら、Hermes に接続する前に、Hindsight 用のモデル選択 と ローカルモデルの配信と配線 を続けてください。
Hindsight 用のモデル選択
デプロイにより、API とデータベースがネットワーク上に置かれます。次の決定は、3つの推論ロールを埋めるモデルです:recall 候補用の埋め込み、それらを再順序付けるリランカー、および retain、reflect、consolidation 用の生成 LLM。対話にすでに GPU が使われている CPU の Hindsight ホストのための実用的なデフォルトは、プロセス内 Qwen/Qwen3-Embedding-0.6B、プロセス内 BAAI/bge-reranker-v2-m3、および生成タスク用の共有 llama.cpp チャットモデルです。
埋め込みモデル
Hindsight は起動時に埋め込み次元を読み取り、バンクに合わせてサイズを設定するため、最初の retain で選んだモデルは、バンクを再構築するまでバンクが保持するモデルです。リーダーボードの順位よりも、次元と指示の動作が重要です:バンクがすでに 384 または 1024 次元である場合、より強力な 8B エンベッダーは移行の価値がありません。以下の行は、最も軽いものから最も重いものに並べ替えられています;RAM 数値は CPU(FP16 / 典型的なローカルロード)での約々のロード足取りであり、GGUF ファイルサイズではありません。
| モデル | パラメータ | 次元 | コンテキスト | ロード | 実行対象 | 備考 |
|---|---|---|---|---|---|---|
BAAI/bge-small-en-v1.5 |
33M | 384 | 512 | ~100–130 MB | CPU | Hindsight デフォルト;hindsight:latest に同梱。最も速いローカルパス。スコア分布は、それを離れる後も多くの recall_min_scores デフォルトをキャリブレーションする。 |
BAAI/bge-base-en-v1.5 |
109M | 768 | 512 | ~400 MB | CPU | ミッドティヤーの英語 BGE;768 次元バンクを固定。 |
sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 |
~118M | 384 | 512 | ~200 MB | CPU | Hindsight が文書化している多言語 MiniLM;BGE-small と同じ 384 次元バンク幅で 50 以上の言語。 |
intfloat/multilingual-e5-small |
~118M | 384 | 512 | ~200 MB | CPU | onnx プロバイダのデフォルト;ONNX エクスポートがある場合の軽い多言語 CPU パス。 |
nomic-ai/nomic-embed-text-v1.5 |
~137M | 768 | 8k | ~500 MB | CPU | 一般的な Ollama エンベッダー;クラシック BGE より長いコンテキスト、依然として英語優先。 |
google/embeddinggemma-2 |
270M | 768 | 8k | ~540 MB | CPU | EmbeddingGemma 2 テキストのみ(ビジョン/オーディオタワーを無効化)。100 以上の言語 + コード;MRL で 512/256/128 に切り詰め可能;検索とドキュメント用の指示プレフィックス。フルマルチモーダルロードは 740M。 |
BAAI/bge-m3 |
568M | 1024 | 8k | ~1.1 GB | CPU または GPU | 強力な多言語デュアルエンコーダ;Qwen3-0.6B と同じ幅なので、同次元のスワップでもフル再エンベッドが必要。 |
Qwen/Qwen3-Embedding-0.6B |
0.6B | 1024 | 32k | ~1.2 GB | CPU | このガイドのデフォルト。指示認識型(クエリ側に検索指示);CPU で快適。ローカルプロバイダは指示を自動適用;OpenAI 互換サーバーには HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX が必要。 |
Qwen/Qwen3-Embedding-4B |
4B | 2560 | 32k | ~8 GB FP16 / ~2.5 GB 量子化 | GPU | Qwen3 品質ティア;2560 次元バンクを固定。対話 GPU がすでに飽和している場合、実行不可能。 |
モデルを実行する方法は選択のもう半分です。Hindsight の埋め込みプロバイダは、最も単純なものから多くの動く部品を含むものまで:
| プロバイダ | 実行方法 | 最適な場面 | 備考 |
|---|---|---|---|
local |
プロセス内 SentenceTransformers;サイドカーなし | 単一の Hindsight ホスト、CPU エンベッダー | デフォルトパス。HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL を設定。llama.cpp、Ollama、TEI 不要。 |
onnx |
プロセス内 ONNX Runtime | Torch より軽い CPU;ONNX エクスポートをすでに持っている | hindsight-api-slim[local-onnx] と HINDSIGHT_API_EMBEDDINGS_ONNX_* が必要。 |
openai / tei |
外部 OpenAI 互換または HF TEI エンドポイント | API プロセスからの埋め込み分離;共有 GPU/CPU ホスト | Ollama / llama.cpp / TEI 用の Serve and Wire Local Models が設定するもの。分離や別マシンが望ましい場合のみサイドカーの価値あり。 |
Qwen3-Embedding-0.6B は外部埋め込みサービスを必要としません。CPU の Hindsight ホストでは、local プロバイダで API プロセス内にロードされ — Hugging Face が最初の起動時に重みをダウンロードし、プロバイダがモデルの検索指示を自分自身で適用します:
# Compose 環境(または同等の .env キー)
HINDSIGHT_API_EMBEDDINGS_PROVIDER: local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL: Qwen/Qwen3-Embedding-0.6B
エンベッダーを別マシンに置きたい場合、または API プロセスから外したい場合のみ、外部 OpenAI 互換エンドポイントを使用してください。Ollama はそのようなホストの一つです:
# Embeddings: Qwen3-Embedding-0.6B on Ollama
HINDSIGHT_API_EMBEDDINGS_PROVIDER: openai
HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL: http://192.168.1.123:11434/v1
HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL: qwen3-embedding:0.6b-q8_0
HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY: dummy
推論マシンで ollama list が示すホスト、ポート、タグに変更してください。
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX はプロバイダに依存します:
| パス | HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX |
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX |
|---|---|---|
local (Qwen/Qwen3-Embedding-0.6B) |
未設定/空のまま — プロセス内プロバイダが Qwen の検索指示を自分自身で適用 | 未設定/空のまま |
| 外部 Ollama / llama.cpp / OpenAI 互換 | 公式 Qwen3 検索指示(Query: の前に実際の改行) |
空のまま — 保存されたメモリは生のテキストのまま |
| サーバーがすでに Qwen のテンプレートで入力をラップしている | 両方とも空のまま — さもなくば指示が2回適用される | 空のまま |
外部パスの場合、以下を設定します:
# Query:の前に実際の改行。Bash $'...' がそれを渡す確実な方法です。
HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=
Compose YAML では、同じ文字列に明示的な \n(またはリテラルの複数行値)が必要です。最初の retain 前にプレフィックスを設定してください:後で変更すると、古いベクトルと新しいクエリが同じ空間に座らなくなります。
リーダーボードの位置よりも2つの特性が決定します。指示への敏感さ:Qwen3 埋め込みはクエリ側に検索指示を適用します;OpenAI 互換サーバーで対応するプレフィックスがない場合、保存側とクエリ側が同じ空間に座らなくなります。次元ロック:幅は起動時に1回だけ読み取られるため、後で 0.6B から 4B への変更はバンクの移行であり、設定変更ではありません — 同じ次元のスワップ(BGE-M3 ↔ Qwen3-0.6B、または 768 の EmbeddingGemma 2 ↔ nomic)でもベクトル空間が変わるため、バンクベクトルは自動的に再計算されません。新しいバンクまたは手動の再エンベッド/再インデックスを計画してください;メモリのバンクのエクスポート、インポート、移行 を参照してください。BGE-small を離れる後、新しいスコア分布に対して recall_min_scores を探査してください — BGE-small でキャリブレーションされた閾値は Qwen3-0.6B に対して厳しすぎ、リランカーに候補を供給できない可能性があります。Qwen3 ファミリーのベンチマークと GGUF/Ollama の背景については、Ollama 上の Qwen3 Embedding と Reranker モデル を参照してください。
リランキングモデル
埋め込みは候補セットを想起し、リランカーは各クエリ/段落ペアをスコアリングして、Hindsight が注入する前に再順序付けします。local プロバイダの場合、Hindsight は SentenceTransformers クロスエンコーダー(またはサポートされている場合、生成型リランカー)をロードします。外部 Cohere 互換エンドポイントの場合、完全な Cohere スタイルのボディを HINDSIGHT_API_RERANKER_COHERE_BASE_URL に POST します。リランカーは任意ですが、エンベッダーが固定された時点で、通常は recall 品質の最大のレバーであり — CPU では、recall のウォールクロックの多くを占める場合もあります。行は最も軽いものから最も重いものに並べ替えられています。
| モデル | パラメータ | タイプ | コンテキスト | 実行対象 | 備考 |
|---|---|---|---|---|---|
cross-encoder/ms-marco-MiniLM-L-6-v2 |
23M | クロスエンコーダ | 128 | CPU | Hindsight デフォルト;hindsight:latest に同梱。約20の候補でサブセカン ド。より重い BGE モデルが遅すぎる場合の名前の付いたフォールバックとして保持。 |
cross-encoder/ms-marco-MiniLM-L-12-v2 |
~33M | クロスエンコーダ | 512 | CPU | 同じファミリー、より高い精度;依然として英語寄りの MS MARCO。 |
cross-encoder/mmarco-mMiniLMv2-L12-H384-v1 |
~33M | クロスエンコーダ | 512 | CPU | Hindsight が文書化している多言語 MiniLM リランカー。 |
BAAI/bge-reranker-base |
278M | クロスエンコーダ | 512 | CPU | MiniLM より適度なアップグレード;en/zh。議論が多いが、v2-m3 がすでにレイテンシ予算に収まる場合にスキップ。 |
BAAI/bge-reranker-v2-m3 |
568M | クロスエンコーダ | 8k | CPU または GPU | CPU での実用的な多言語デフォルト。約500メモリのバンクで、20候補のフロアで約2.6–2.8 秒/リコール(約140 ms/候補;recall 時間の約93–99%)。候補上限 20/40/80;フロアを 20 → 10 に下げるとリランクコストはほぼ半分。 |
Qwen/Qwen3-Reranker-0.6B |
0.6B | 生成型(yes-token) | 32k | GPU 推奨 | 指示認識型、長いコンテキスト。ドロップインのクロスエンコーダではない:最近の SentenceTransformers の生成型リランカーサポートが必要、llama.cpp /rerank スコアリングには既知の間違ったスコアのバグがある(hindsight-benchmarks#11)。採用前に検証してください。 |
BAAI/bge-reranker-v2-gemma |
2.5B | クロスエンコーダ | 8k | GPU 推奨 | 強力な多言語品質;GPU がすでに満杯の場合、数百メモリの個人バンクに対しては過剰。 |
Qwen/Qwen3-Reranker-4B |
4B | 生成型 | 32k | GPU | より高品質な Qwen 候補;専用 VRAM なしでは実行不可能。 |
Qwen/Qwen3-Reranker-8B |
8B | 生成型 | 32k | GPU | ファミリー最上位;同じ生成型スコアリングの注意点、さらに大きい。 |
クラウド API リランカー(Cohere、ZeroEntropy、Alibaba qwen3-rerank、TypeSafe など)は Hindsight で動作しますが、メモリテキストをボックス外に送信します。ローカル専用のクロスドメイン構成では、スコープ外です。
2つの運用上の制約が選択を支配します。VRAM:対話モデルがすでに GPU を飽和させている場合(例えば、余剰がない 16 GB カード上の Qwen3.8-27B Q5)、すべての「GPU 推奨」行はテーブルから除外され、ライブ選択は CPU 上の MiniLM または BGE-v2-m3 に収束します。候補数:HINDSIGHT_API_RERANKER_MAX_CANDIDATES(下記の外部エンドポイント例では 30)は、モデルが再スコアリングする段落数を制限します;各候補は完全なフォワードパスであるため、モデルティアを飛躍する前にフロアを切り捨ててください。llama.cpp を通じた Qwen3 の場合、GGUF はランキングヘッドを保持する必要があります — それを落とす古い convert_hf_to_gguf.py はすべての段落をほぼゼロでスコアリングし、生成型スコアリングパスが確認されるまで、既知の良/悪の段落テストが必要です。
生成 LLM ティア
埋め込みとリランキングモデルは、メモリを抽出・推論するために使用される生成 LLM の代わりにはなりません。Hindsight はデフォルト LLM と操作固有の上書きをサポートし、同じ llama.cpp サーバーまたは独立したエンドポイントをターゲットにできます。
| Hindsight 操作 | 目的 | 実用的なモデルティア | Qwen の例 |
|---|---|---|---|
| Retain | 事実、エンティティ、決定、時系列の抽出 | テストには 4B 最小;9B が推奨 | Qwen3.5-4B / Qwen3.5-9B |
| Recall | 意味的、キーワード、グラフ、時間的検索 | 生成 LLM 不要 | Qwen3-Embedding-0.6B + リランカー |
| Reflect | 想起されたメモリを合成して質問に回答 | 9B から 27B+ | Qwen3.5-9B / Qwen3.8-27B |
| Consolidation | 関連する事実の調整と圧縮 | 9B が推奨 | Qwen3.5-9B / Qwen3.8-27B |
| Mental model refresh | より長く生きる合成理解の更新 | 9B から 35B | Qwen3.5-9B / Qwen3.6-35B-A3B |
これらは運用上の推奨であり、公式な Hindsight 最小パラメータ数ではありません。小さなモデルはポート番号を正しく抽出しても、以前のアーキテクチャ決定が取代されたことに気づかないかもしれません。構造化出力の信頼性と否定の忠実な処理は、名目上のパラメータ数だけよりも重要です。Hindsight 自身の温度デフォルトは触らない価値があります — retain に 0.1、consolidation に 0.0、reflect に 0.9 — そして retain と consolidation にとって、llama.cpp ビルドがあれば、非思考エイリアスを配信する価値があります。小さな Qwen3.5 チェックポイントは思考モードで多くのトークンを消費するためです。
既存の Qwen3.8-27B llama.cpp エンドポイントのあるデプロイメントでは、低い並行性でそれを生成 Hindsight タスク全体に共有することから始めてください:
HINDSIGHT_API_LLM_PROVIDER=openai
HINDSIGHT_API_LLM_BASE_URL=http://WORKSTATION_IP:8080/v1
HINDSIGHT_API_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_LLM_API_KEY=dummy
HINDSIGHT_API_LLM_MAX_CONCURRENT=2
HINDSIGHT_API_RETAIN_LLM_MAX_CONCURRENT=1
HINDSIGHT_API_CONSOLIDATION_LLM_MAX_CONCURRENT=1
後で、通常の抽出を独立した 9B モデルにルーティングし、困難な reflect には 27B を予約します:
HINDSIGHT_API_RETAIN_LLM_PROVIDER=openai
HINDSIGHT_API_RETAIN_LLM_BASE_URL=http://MEMORY_LLM_HOST:8083/v1
HINDSIGHT_API_RETAIN_LLM_MODEL=MemoryLLM
HINDSIGHT_API_RETAIN_LLM_API_KEY=dummy

HINDSIGHT_API_REFLECT_LLM_PROVIDER=openai
HINDSIGHT_API_REFLECT_LLM_BASE_URL=http://WORKSTATION_IP:8080/v1
HINDSIGHT_API_REFLECT_LLM_MODEL=LocalMegaLLM
HINDSIGHT_API_REFLECT_LLM_API_KEY=dummy
より小さな 4B モデルは経済的ですがテストが必要です;9B は品質/性能の妥当な妥協点です。retain と consolidation が小さなモデルを共有する場合、HINDSIGHT_API_CONSOLIDATION_LLM_BATCH_SIZE を 2 に下げてください — デフォルトのバッチ 8 は、小さなコンテキストウィンドウには長いプロンプトです。Qwen3.6-35B-A3B は、適切にプロビジョニングされた独立した推論サーバーにとって魅力的です(これは約30億のアクティブパラメータを持つ混合エキスパートモデルなので、小さなアクティブモデルとして予算計上してください)、一方で 27B の密モデルは、すべての通常の retain イベントに通常必要ありません。バックグラウンド並行性の制限は、メモリメンテナンスのバーストから Hermes の対話モデルを保護します。
ローカルモデルの配信と配線
モデル選択でのプロセス内 local 埋め込みとリランカーの設定が十分な場合、外部 Ollama と llama.cpp サブセクションをスキップして配線へ飛ぶことができます — または Compose をそこに示す local デフォルトのままにできます。外部エンドポイントは、エンベッダーやリランカーを別ホストに置きたい場合に重要です。
外部埋め込み:Ollama または llama.cpp
外部埋め込みは、Qwen3-Embedding-0.6B(または他のモデル)を別ホストに置きたい場合のためのものです。2つの実用的なオプションは、Ollama(設定をほとんど必要とせずにモデル取得と配信を処理)と llama.cpp(GGUF 量子化、CPU スレッド、デバイス配置、バッチリングの正確な制御を提供)です。両方の Qwen3 モデルのモデル背景とベンチマークは Ollama 上の Qwen3 Embedding と Reranker モデル にあります。
Qwen3-Embedding-0.6B は 1024 次元のベクトルを返し、Hindsight は起動時にその幅を読み取り、データベースをそれに合わせてサイズを設定します。バンドルされた 384 次元の BGE モデルで作られたバンクは、このモデルを受け入れられません — 空のデータベースまたはボリュームから始めて、最初の retain の前に埋め込みモデルを決定してください。後の埋め込みプロバイダの切り替えは、両方のモデルが同じ次元を使用する場合でも、保存されたレコードの再エンベッドを必要とします。
オプション 1: Qwen3-Embedding-0.6B 用の Ollama
推論ホストに Ollama を 公式 Linux インストール文書 を使用してインストールし、埋め込みモデルを開始します:
ollama pull qwen3-embedding:0.6b
ollama serve
リモートアクセスのために、Ollama のサービス環境で OLLAMA_HOST=0.0.0.0:11434 を設定し、サービスを再起動し、Hindsight VM にファイアウォールしてください — 手順は Ollama リモートアクセス で扱われています。127.0.0.1 のみにバインドされたデーモンは Hindsight コンテナから見えません。まず ollama list でモデル名を確認し、標準的な埋め込みエンドポイントをテストしてください:
curl http://EMBED_HOST:11434/api/embed \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding:0.6b","input":"A test memory"}'
Hindsight の OpenAI 埋め込みプロバイダは代わりに Ollama の OpenAI 互換 /v1/embeddings エンドポイントを呼び出します。Hindsight を設定する前に、そのエンドポイントが自分の Ollama バージョンで動作することを確認してください。Ollama は埋め込みには単純ですが、その API が互換性のあるリランキングエンドポイントを提供すると仮定しないでください。 リランキングについては、以下のプロセス内 local BGE パス、またはスコアを検証した後の別 llama.cpp / TEI エンドポイントを好んでください。
オプション 2: Qwen3-Embedding-0.6B 用の llama.cpp
検証済みの Qwen3-Embedding-0.6B GGUF コンバージョンをダウンロードします。実際にダウンロードした GGUF ファイル名を使用してください:
#!/bin/sh
# start-embedding.sh - CPU のみ埋め込みサーバー
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8081 \
  --model "$HOME/ggufs/Qwen3-Embedding-0.6B-Q8_0.gguf" \
  --alias qwen3-embedding-0.6b \
  --embedding --pooling last \
  --ctx-size 4096 --parallel 1 \
  --threads 4 --threads-batch 4 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 0
Qwen3 埋め込みはトークン最後のプーリングを使用しますが、一部の BGE モデルが使用する CLS プーリングとは異なります。GPU が大きな対話モデルで占有されているワークステーションで、絶対的な CUDA 初期化を避けたい場合は、CPU のみ llama.cpp ビルドが望ましいです。この埋め込みサーバーで --reranking を有効にしないでください:その組み合わせはゼロのベクトルを得る既知の方法です。
curl -s http://EMBED_HOST:8081/v1/embeddings \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-embedding-0.6b","input":"A test memory"}' \
  | jq '.data[0].embedding | length'
フル次元の Qwen3-Embedding-0.6B 出力には 1024 個のフロートが含まれるべきです。GGUF コンバージョンと Hindsight のクエリ/ドキュメント指示処理が互換性があることを確認してください;指示に敏感な埋め込みモデルは、誤ってプロンプトされた場合、精度を失う可能性があります。
リランカー:ローカル BGE または llama.cpp 経由の Qwen3
リランキングは埋め込みとは異なります:モデルは各クエリ/ドキュメントペアをスコアリングして関連性スコアを返します。CPU のみ Hindsight ホスト — または対話 GPU に VRAM の余剰がない場合 — では、実用的なパスは BAAI/bge-reranker-v2-m3(またはより軽い MiniLM デフォルト)による Hindsight の local プロバイダです。サイドカーは不要です:
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20
Qwen3-Reranker-0.6B は生成型 yes-token スコアラーであり、クラシックなクロスエンコーダではありません。ランキング用に設計された GGUF コンバージョンで llama.cpp 経由で配信できますが、既知の良/悪のペアでスコアを確認するまで、そのパスを実験的と見なしてください:ランキングヘッドを落とす古い convert_hf_to_gguf.py はすべての段落をほぼゼロでスコアリングし、llama.cpp のネイティブ /rerank パスはこのファミリーに既知の間違ったスコアの報告があります。
#!/bin/sh
# start-reranker.sh - --n-gpu-layers によって選択された GPU または CPU
set -eu
cd "$HOME/prj"
exec ./llama.cpp/llama-server \
  --host 0.0.0.0 --port 8082 \
  --model "$HOME/ggufs/Qwen3-Reranker-0.6B-Q8_0.gguf" \
  --alias qwen3-reranker-0.6b \
  --embedding --reranking --pooling rank \
  --ctx-size 4096 --parallel 1 \
  --batch-size 512 --ubatch-size 256 \
  --n-gpu-layers 99
CPU で実行するには --n-gpu-layers 0 に設定してください。GPU バージョンは、モデルの重みのだけでなく、計算バッファとコンテキストにも追加の VRAM が必要です;ファイルサイズが総 GPU アロケーションであると仮定しないでください。
curl -s http://RERANK_HOST:8082/v1/rerank \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3-reranker-0.6b", "query":"PostgreSQL storage", "documents":["Hindsight stores memories in PostgreSQL.","A recipe for bread."], "top_n":2}' \
  | jq
PostgreSQL のドキュメントは、無関係なドキュメントより上にランクされるべきです;関連性スコアがすべてゼロである場合、GGUF が誤ったコンバージョンを意味し、事実が保存されていても recall はランダムに見えます。正確な results[].index と results[].relevance_score の形状を確認してください:Hindsight は Cohere 互換のリランク応答を期待し、llama.cpp の互換性はビルド間で異なる可能性があります。
エンドポイントを Hindsight に配線
以下の環境設定を Hindsight Compose サービスに追加するか、その .env ファイルに保存します。埋め込みパスを1つ選びます — プロセス内 local、Ollama、または llama.cpp — 一度に2つは選択しないでください。
# Option A: in-process Qwen3 on the Hindsight host (CPU; no sidecar)
HINDSIGHT_API_EMBEDDINGS_PROVIDER=local
HINDSIGHT_API_EMBEDDINGS_LOCAL_MODEL=Qwen/Qwen3-Embedding-0.6B

# Option B: llama.cpp embedding service
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://EMBED_HOST:8081/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding-0.6b
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BATCH_SIZE=8
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Option C: Ollama on another host
# HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
# HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL=http://192.168.1.40:11434/v1
# HINDSIGHT_API_EMBEDDINGS_OPENAI_MODEL=qwen3-embedding:0.6b-q8_0
# HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=dummy
# HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX=$'Instruct: Given a web search query, retrieve relevant passages that answer the query\nQuery:'
# HINDSIGHT_API_EMBEDDINGS_PASSAGE_PREFIX=

# Option: local BGE reranker (no sidecar; preferred on CPU)
HINDSIGHT_API_RERANKER_PROVIDER=local
HINDSIGHT_API_RERANKER_LOCAL_MODEL=BAAI/bge-reranker-v2-m3
HINDSIGHT_API_RERANKER_MAX_CANDIDATES=20

# Option: llama.cpp Cohere-compatible rerank endpoint (validate Qwen3 scores first)
# HINDSIGHT_API_RERANKER_PROVIDER=cohere
# HINDSIGHT_API_RERANKER_COHERE_BASE_URL=http://RERANK_HOST:8082/v1/rerank
# HINDSIGHT_API_RERANKER_COHERE_MODEL=qwen3-reranker-0.6b
# HINDSIGHT_API_RERANKER_COHERE_API_KEY=dummy
# HINDSIGHT_API_RERANKER_MAX_CANDIDATES=30
変数名はプロバイダ固有であり、微妙な違いは沈黙します:HINDSIGHT_API_EMBEDDINGS_BASE_URL は誤ったキーであり、Hindsight は自分のローカルサーバーではなく OpenAI 自身の埋め込みエンドポイントを無言でターゲットにします。HINDSIGHT_API_EMBEDDINGS_OPENAI_BASE_URL を使用してください。Cohere 互換リランカーパスでは、Hindsight は完全な Cohere スタイルのボディを HINDSIGHT_API_RERANKER_COHERE_BASE_URL に POST します;コンテナログが /v1/rerank/rerank の 404 を示す場合、あなたのビルドは独自に /rerank を追加しており、値は /v1 で止まるべきです。
オプション B と C の場合、埋め込みモデル の HINDSIGHT_API_EMBEDDINGS_QUERY_PREFIX 値を使用してください(オプション A は未設定のまま)。最初の retain の後、実際のメモリに対してクエリから段落への検索をテストしてください。
記憶されるものを制御する
スタックが動作すると、次の失敗モードは通常、書き込みパスです:Hermes はデフォルトで auto_retain: true であり、すべての会話ターンがバンクに抽出される可能性があります。誤った推測、破棄された計画、探索的な声明が検索可能な事実になり、後の recall はそれらを証拠として扱います — 自己強化型メモリループ で説明されたループです。Hindsight を含む他のプロバイダのキャプチャポリシーは、エージェントメモリプロバイダ比較 で要約されています。
現在存在するキャプチャモード
| モード | Hermes / Hindsight 設定 | 得られるもの |
|---|---|---|
| 継続的 | auto_retain: true、retain_every_n_turns: 1 |
すべてのターンが保持・抽出される |
| バッチ自動 | auto_retain: true、retain_every_n_turns を引き上げる |
より少なくて大きな retain ペイロード — 依然として自動、レビューキューではない |
| 明示的のみ | auto_retain: false + ツール hindsight_retain |
エージェントがツールを呼び出した場合のみ保存(例えば「これを覚えておいて」と言った後) |
| セッション合成 | セッション終了時のサマリーの hindsight_retain、またはバンク reflect / consolidation |
あなたまたはエージェントが呼び出しを規律する場合の厳選された書き込み — 組み込みの承認用フラッシュではない |
auto_retain を false に設定すると、自動保存が無効になります。書き込みの各前に人間の承認ダイアログを追加するわけではありません。エージェントはツールが許可する限りいつでも hindsight_retain を呼び出すことができます;明示的 retain を保留キューではなく、意図的なキャプチャとして扱ってください。
承認キューのギャップ
一般的な要望は、バンクに入る前にあなたがレビューして承認する候補メモリの保留キューです。Hermes 下の Hindsight は、今日、その契約を提供していません。Mnemosyne for Hermes は、一部のバージョンでプロバイダ固有の段階的書き込みを実装しています;そのパスは共有 Hermes 標準ではなく、Hindsight プラグインには適用されません。アップストリームの承認フローが存在するまで、実用的なパターンは auto_retain: false、意図的な hindsight_retain、および次のセッションが悪い事実を頼る前に Hindsight コントロールプレーン UI での検査または削除です。Hindsight 用に config.json で探すのに欠けている write_approval キーはありません。
バンク操舵(ミッション、ラベル、ディレクティブ、メンタルモデル)
人々は次のレイヤーをしばしば「ファインチューニング」と呼びます。Hindsight では、それはほとんど バンク設定であり、Hermes の config.json だけではありません:ミッションと抽出設定が retain が何を保持するかを操舵し;ラベルがエンティティを構造化し;ディレクティブとメンタルモデルが後の合成を形成します。
| 制御 | 存在場所 | 助け方 |
|---|---|---|
Retain ミッション(retain_mission / Hermes bank_retain_mission) |
バンク設定 | 抽出に注入される素の言葉の「X に注意し、Y を無視する」 |
抽出モード(concise、verbose、custom、…) |
バンク設定 | concise(デフォルト)は長期価値のある事実を保持;custom は retain_custom_instructions 経由で組み込みルールを置換 |
| エンティティラベル | バンク設定 | retain 時の制御された key:value 語彙 → グラフラインクと任意のタグ;検索構造を改善するが、誤った声明をそれ自体では拒否しない |
| ディレクティブ(「ハードルール」) | バンクディレクティブ API | reflect(タグスコープ)中に強制される明示的な指示;合成を制約するが、書き込み承認ゲートではない |
| メンタルモデル | バンクメンタルモデル API | 繰り返し質問に対する常設回答、対応するメモリから reflect 経由で更新;派生なので、悪いソース事実は依然としてそれを汚染する |
| Reflect / 観測ミッション | バンク設定 | 合成と整理を操舵するが、生の retain ファイアホースではない |
ミッション、簡潔な抽出、ラベルはノイズを減らし、検索を改善します。正確性が完全性より重要である場合、auto-retain をオフにすることを置き換えません。持続可能なプロジェクト決定を名乗り、チャットのロジスティクスを無視する短い retain ミッションを優先し;実用的な分類法がある場合のみエンティティラベルを追加し;バンクがすでに清潔な事実を保持した後、2、3の繰り返し質問に対してメンタルモデルを追加してください。
推奨される衛生プロファイル
個人の Hermes バンクのための具体的な出発点:
{
  "mode": "local_external",
  "api_url": "http://HINDSIGHT_VM_IP:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": false,
  "retain_async": true,
  "recall_prefetch_method": "recall"
}
バンクには retain ミッションを設定し、抽出を concise モードのままにしてください(コントロールプレーンまたは Banks API を経由)。明示的 retain の後、UI を開き、観測を確認し、consolidation またはメンタルモデルの刷新が実行される前に誤りを削除してください。recall_prefetch_method は recall のままにしてください — reflect はすべてのターンの前にチャットモデルの呼び出しを消費し、基礎事実ではなく合成を注入します。
Hermes Agent を Hindsight に接続
Hermes VM で、カタログプラグインをインストールし、セットアップウィザードを実行します。Hindsight と local_external モードを選択してください;プラグインは内蔵 PostgreSQL を開始したり、Hindsight モデルスタックをローカルで実行する必要はなく、local_embedded はまさに実行したコンテナの隣で2番目の Hindsight デーモンを開始します。
hermes plugins install hindsight
hermes memory setup hindsight
Hindsight を使用するエージェントロールの興味深いオプションセットがあります
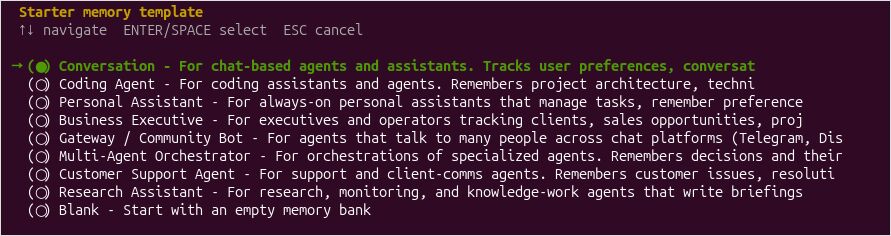
hermes memory status
外部 Hindsight 接続は ~/.hermes/hindsight/config.json にあります。継続的なキャプチャ(Hermes デフォルト)を保持する例示的な設定:
{
  "mode": "local_external",
  "api_url": "http://HINDSIGHT_VM_IP:8888",
  "bank_id": "hermes",
  "memory_mode": "hybrid",
  "auto_recall": true,
  "recall_sync": false,
  "auto_retain": true,
  "retain_async": true,
  "retain_every_n_turns": 1
}
明示的のみ retain とバンク操舵のために、auto_retain をオンにしたままにする代わりに、記憶されるものを制御する の衛生プロファイルを使用してください。recall_sync: false はインタラクティブな応答性を優先しますが、次のターンで想起されたコンテキストを注入する可能性があります。現在のリクエストがモデルが回答を始める前に最新のメモリを組み込まなければならない場合、同期 recall を使用してください。retain_async: true はメモリが処理されるとき、通常の応答をブロッキングしません。
プラグインの recall デフォルトは観測のみです;生のワールドと経験事実は、consolidation が観測を書いた後、または recall_types を observation,world,experience に広げるまで、バンク内に残ってプロンプトの外にあります。最初の1週間広げてコントロールプレーンを見守り、その後絞り込むのは、合理的な順序です。
組み込み Hermes メモリはプロバイダの隣でアクティブなままです;Hindsight が何を追加するか学ぶ間 MEMORY.md と USER.md をオンにしておくのは問題なく、フラットファイルを残すべきかどうかを決める場所は、メモリシステムの記事です。
すでに実行されている場合、ゲートウェイを再起動します:
hermes gateway restart
hermes memory status
ステータスは Hindsight をアクティブなプロバイダとして識別すべきです。より広いコマンド参照、Hermes の TUI とプラグインコマンドを含むものは、Hermes Agent CLI チートシート を参照してください。
メモリを検証する、インストールだけでなく
Hermes にテストプロジェクトについて使い捨てな事実を覚えてもらい、別のセッションを開始し、その事実を再度尋ねてください。Retention はデフォルトで非同期であり、抽出はチャットモデルを待つため、判断する前にメイン llama.cpp サーバーに少しの間を与えてください。その後、より難しいケースをテストしてください:Hermes に以前の決定が変わったと伝え、現在の決定と理由を尋ねてください。memory status が取り込みと recall が正しいことを証明すると仮定するのではなく、Hindsight の UI と保存された観測を確認してください。
回答が空で返ってくる場合、モデルを変更する前にコントロールプレーンを検査してください。recall_types が観測のみで、consolidation が実行されていない間、retain は成功しても recall に見えない場合があります — recall_types を広げるのが最初のチェックです。埋め込みサーバーログでの接続拒否は、コンテナが埋め込みポートに到達できないことを意味し、リランカースコアがすべてゼロであることは GGUF が誤ったコンバージョンを意味します。
書き込みパスの選択(auto_retain、ミッション、承認ギャップ)は 記憶されるものを制御する で扱われています。
トラブルシューティングと運用上の注意
| 症状 | 考えられる原因 | 最初のチェック |
|---|---|---|
| Hermes がプロバイダ利用不可と言う | 誤った local_external URL またはネットワークルール |
curl http://HINDSIGHT_VM_IP:8888/health |
| Docker が起動し、PostgreSQL エラー | 拡張機能の欠落、誤った認証情報、または不十分な共有メモリ | コンテナログと pg_extension |
| 埋め込みが 401 または 404 を返す | 誤った OpenAI 互換 URL、誤った環境キー名、またはモデルエイリアスの不一致 | 直接 /v1/embeddings テストと変数名 |
| リランキングが失敗 | エンドポイントまたは応答形式の不一致、二重の /rerank パスを含む |
直接 /v1/rerank テストとコンテナログ |
| Recall が利用可能なものを返さない | recall_types が観測に制限、またはリランカースコアがゼロ |
コントロールプレーン、次に recall_types、次にリランカーコンバージョン |
| 既存のバンクが次元不一致を報告 | 埋め込みモデルが変更された | 一貫したモデルでベクトルを再構築/再インポート |
| Hermes の応答が遅くなる | 同期 recall または共有 LLM の競合 | 同期 recall をオフ;retain 並行性をキャップ |
| 無関係なメモリが繰り返す | 弱い抽出、ノイズの多い検索、または不十分な整理 | 観測と関連性スコアを検査 |
実用的な小さなデプロイメントは、PostgreSQL とすべての推論が外部の場合、Hindsight API VM に 2-4 vCPU と 4-6 GB RAM です。ディスク割当は、選択された Docker イメージと保持されたイメージレイヤーに依然として依存します;拡大する余地を置いて、最初に約 30-40 GB を割当てください。PostgreSQL ホストは、実際のメモリ量、ストレージ性能、および提供する他のデータベースに基づいてサイズを設定してください。
Hindsight バンクのバックアップとリストア
メモリバンクが唯一の重要な状態であり、PostgreSQL にあります。オプション B では、あなたが管理するデータベースです;オプション A では、コンテナ内の内蔵 pg0 名前付きボリュームです。Hindsight コンテナから独立してバックアップしてください — ボリュームまたはデータベースを最初にキャプチャせずにコンテナを再生造すると、バンクが破棄され、hermes backup は別サービスで実行されているバンクには到達しません。
オプション B — 外部 PostgreSQL。 カスタム形式で hindsight データベースをダンプし、アーカイブを信頼する前にスクラッチデータベースにリストアして検証します:
pg_dump -h POSTGRES_IP -U hindsight -Fc hindsight > hindsight-bank.dump

# ダンプが使えることを証明するためにスクラッチデータベースにリストア
createdb -h POSTGRES_IP -U postgres hindsight-verify
pg_restore -h POSTGRES_IP -U postgres -d hindsight-verify hindsight-bank.dump
元のダンプターゲットを削除する前に、リストアされたコピーに pgvector 拡張機能とサンプル recall が存在することを確認してください。ダンプを Hindsight VM とは異なるホストに保ち、PostgreSQL 管理者(データベースを作成できるロール)として実行し、アプリケーションロールではなくしてください。
オプション A — オールインワンコンテナ。 内蔵データベースは名前付きボリュームなので、コンテナを停止し、使い捨てのイメージを通してボリュームを tar します:
docker stop hindsight
docker run --rm -v hindsight-pg0:/data -v "$PWD":/backup alpine \
  tar czf /backup/hindsight-bank.tgz -C /data .
docker start hindsight
tar コンテナ内のマウントポイント(/data)は任意です;単に名前付きボリュームをエイリアス化して tar が読むのを可能にするだけです。リストアするには、コンテナを停止し、ボリュームをクリアし、アーカイブをそこにアンパッキングするか、コンテナをオプション B の外部 PostgreSQL リストアに向けます。
カレンダースケジュールではなく、3つの瞬間にスナップショットを取ってください:埋め込みモデルを変更する前、Hindsight または PostgreSQL の主要なアップグレードの前、バンクを書き換える reflect または consolidation パスの前。スクラッチバンクにリストアしたバックアップは、書き込んだだけのバックアップよりも価値があります。
メモリのバンクのエクスポート、インポート、移行
バックアップとリストアは、その場でバンクを保護します。エクスポート/インポートは、Hindsight インスタンス間でそれを移動し、それがモデル変更が実際に強いることです。
埋め込みモデルの変更は設定の編集ではありません。バンクのベクトルは古いモデルで計算され、異なるモデル — 例えば、バンドルされた 384 次元 BGE エンベッダーと 1024 次元 Qwen3-Embedding-0.6B — は異なる空間に書き、通常は異なる幅です。既存のインスタンスを新しいエンベッダーに向けることができて、古いベクトルを保つことはできません;次元は新しい埋め込みモデルですべてのメモリを再エンベッドして再計算されなければなりません。
エンベッダーとその設定は Hindsight インスタンスごとに設定されるため、クリーンなパスは、すでに recall を提供しているものの内でベクトルを再構築するのではなく、新しい埋め込み設定で新しいインスタンスを立てて、そこにバンクを移行することです。Hindsight API もバンクを移動できますが、一度の変更では、エクスポート/インポートの方が簡単で検査可能なルートです:
# 古いインスタンスからバンクをエクスポート
docker exec hindsight \
  hindsight-admin export-bank \
    --bank hermes2 \
    --output /tmp/hermes2.zip

docker cp hindsight:/tmp/hermes2.zip ./hermes2.zip

ls -lh hermes2.zip
unzip -t hermes2.zip

# 新しいインスタンスにバンクをインポート
docker cp ./hermes2.zip hindsight-q06:/tmp/hermes2.zip

docker exec hindsight-q06 \
  hindsight-admin import-bank \
    --archive /tmp/hermes2.zip
unzip -t は、新しいインスタンスに送る前にアーカイブを検証します。インポート後、~/.hermes/hindsight/config.json の api_url を新しいインスタンスに向けます、ゲートウェイを再起動し、以前のメモリ検証を実行します:保持された事実は新しいエンベッダーを通して想起されるべきです。新しいものが高くなるまで、古いバンクとそのベクトルを古いインスタンスに残し、依然として動作するフォールバックを持つようにしてください。
モニタリング、剪定、バンクの安定維持
バンクが動作すると、日常の作業は、抽出モデルが保存すると決定したものを見守り、派生状態をチェックすることです。memory status が取り込みと recall が正しいことを証明すると仮定するのではなく、コントロールプレーン UI(hindsight-embed -p hermes ui start)を使用して、観測、関連性スコア、consolidation 出力を検査してください。重複または古いメモリは、通常、弱い抽出または実行不足の整理です;検索を広げる前に、抽出ティアまたは整理頻度を修正してください。
バンクに頼る前にテストする価値がある2つのメンテナンストラップがあります。第一に、観測の削除は、すべての派生表現がそれとともに消えることを保証しません — それから構築された reflect 事実やグラフエッジは削除後も生存し得るため、自己強化型メモリループ で扱われるのと同じ出所懸念について、削除をエンドツーエンドで検証してください。第二に、HINDSIGHT_API_WORKER_ID を再生成間でも安定して保ち、特定のイメージタグをピン留めしてください:コンテナが死亡した際に進行中だったタスクは、古い worker id の下でスタックしたままになり、動くタグは保持しようとするデータベースには適していません。
