
構造化出力によるLLMの制約:Ollama、Qwen3、PythonまたはGo
Ollamaから構造化された出力を取得するいくつかの方法
大規模言語モデル(LLM) は強力ですが、プロダクション環境では自由形式の段落を欲しがることは稀です。 むしろ、アプリケーションに投入できる予測可能なデータ(属性、事実、構造化オブジェクト)が欲しいのです。 それがLLM構造化出力です。
スキーマの強制により、不適切なロジットが無効なJSONに変換される頻度は減少しますが、リトライの嵐を避けるためには、温度(temperature)やペナルティの設定も重要です。エージェントとformat制約を組み合わせる場合は、QwenとGemma向けのエージェント推論パラメータを参照してください。
サービスレイヤーでは、スキーマの強制が設定されていてもOllamaとクライアント間で正確な文字列について意見が食い違う可能性があるため、常にパース・正規化・バリデーションロジックが必要です(実用的なPythonによるLLM構造化出力の検証参照)。
少し前、Ollamaは構造化出力のサポートを導入しました(アナウンス)。これにより、モデルの応答をJSONスキーマに準拠するように制約することが可能になりました。 これによって、LLM機能のカタログ作成、モデルのベンチマーク、システムの統合自動化などのタスクにおいて、一貫性のあるデータ抽出パイプラインが実現できます。
本記事では、以下の内容について説明します:
- 構造化出力とは何か、そしてなぜそれが重要なのか
- LLMから構造化出力を得る簡単な方法
- Ollamaの新しい機能の仕組み
- LLM機能の抽出の例:
構造化出力とは?
通常、LLMはフリーテキストを生成します:
「モデルXはChain-of-Thoughtによる推論をサポートし、200Kコンテキストウィンドウを持ち、英語、中国語、スペイン語に対応しています。」
これは人間には読めますが、機械によるパースが困難です。
代わりに、構造化出力では厳密なスキーマでの出力を要求します:
{
  "name": "Model X",
  "supports_thinking": true,
  "max_context_tokens": 200000,
  "languages": ["English", "Chinese", "Spanish"]
}
このJSONは、バリデーションしやすく、データベースに保存したり、UIに渡したりしやすくなります。
LLMから構造化出力を得る簡単な方法
LLMはスキーマの概念を理解している場合があり、特定のスキーマに基づいてJSON形式での出力をLLMに要求できます。 アリババ社のQwen3モデルは、推論および構造化された応答のために最適化されています。明示的にJSONで応答するよう指示できます。
例1: Pythonでollamaを使い、Qwen3にスキーマ付きのJSONを要求する
import json
import ollama

prompt = """
You are a structured data extractor.
Return JSON only.
Text: "Elon Musk is 53 and lives in Austin."
Schema: { "name": string, "age": int, "city": string }
"""

response = ollama.chat(model="qwen3", messages=[{"role": "user", "content": prompt}])
output = response['message']['content']

# Parse JSON
try:
    data = json.loads(output)
    print(data)
except Exception as e:
    print("Error parsing JSON:", e)
出力:
{"name": "Elon Musk", "age": 53, "city": "Austin"}
Pydanticによるスキーマ検証の実装
誤った形式の出力を回避するために、PythonでPydanticスキーマに対して検証を行うことができます。
from pydantic import BaseModel

class Person(BaseModel):
    name: str
    age: int
    city: str

# 'output'がQwen3からのJSON文字列だと仮定します
data = Person.model_validate_json(output)
print(data.name, data.age, data.city)
これにより、出力が期待される構造に適合することが保証されます。
Ollamaの構造化出力
Ollamaでは、formatパラメータにスキーマを渡すことができるようになりました。これにより、モデルはスキーマに準拠したJSONでのみ応答するよう制約されます(ドキュメント)。
Pythonでは、通常Pydanticでスキーマを定義し、それをJSONスキーマとしてOllamaに利用させます。
例2: LLM機能メタデータの抽出
LLMの能力を説明するテキストスニペットがあるとします:
「Qwen3は強力な多言語サポート(英語、中国語、フランス語、スペイン語、アラビア語)を備えています。推論ステップ(Chain-of-Thought)を許可します。コンテキストウィンドウは128Kトークンです。」
構造化データを取得したいとします:
from pydantic import BaseModel
from typing import List
from ollama import chat

class LLMFeatures(BaseModel):
    name: str
    supports_thinking: bool
    max_context_tokens: int
    languages: List[str]

prompt = """
Analyze the following description and return the model’s features in JSON only.
Model description:
'Qwen3 has strong multilingual support (English, Chinese, French, Spanish, Arabic).
It allows reasoning steps (chain-of-thought).
The context window is 128K tokens.'
"""

resp = chat(
    model="qwen3",
    messages=[{"role": "user", "content": prompt}],
    format=LLMFeatures.model_json_schema(),
    options={"temperature": 0},
)

print(resp.message.content)
可能性のある出力:
{
  "name": "Qwen3",
  "supports_thinking": true,
  "max_context_tokens": 128000,
  "languages": ["English", "Chinese", "French", "Spanish", "Arabic"]
}
例3: 複数モデルの比較
複数モデルの说明を入力し、構造化形式に抽出します:
from typing import List

class ModelComparison(BaseModel):
    models: List[LLMFeatures]

prompt = """
Extract features of each model into JSON.

1. Llama 3.1 supports reasoning. Context window is 128K. Languages: English only.
2. GPT-4 Turbo supports reasoning. Context window is 128K. Languages: English, Japanese.
3. Qwen3 supports reasoning. Context window is 128K. Languages: English, Chinese, French, Spanish, Arabic.
"""

resp = chat(
    model="qwen3",
    messages=[{"role": "user", "content": prompt}],
    format=ModelComparison.model_json_schema(),
    options={"temperature": 0},
)

print(resp.message.content)
出力:
{
  "models": [
    {
      "name": "Llama 3.1",
      "supports_thinking": true,
      "max_context_tokens": 128000,
      "languages": ["English"]
    },
    {
      "name": "GPT-4 Turbo",
      "supports_thinking": true,
      "max_context_tokens": 128000,
      "languages": ["English", "Japanese"]
    },
    {
      "name": "Qwen3",
      "supports_thinking": true,
      "max_context_tokens": 128000,
      "languages": ["English", "Chinese", "French", "Spanish", "Arabic"]
    }
  ]
}
これにより、機能ごとにモデルをベンチマーク、可視化、フィルタリングすることが容易になります。
例4: ギャップの自動検出
フィールドが欠落している場合、null値を許可するように設定することもできます:
from typing import Optional

class FlexibleLLMFeatures(BaseModel):
    name: str
    supports_thinking: Optional[bool]
    max_context_tokens: Optional[int]
    languages: Optional[List[str]]
これにより、一部の情報が不明な場合でも、スキーマが有効なままで保たれます。
利点、注意点、ベストプラクティス
Ollama(またはそれをサポートする任意のシステム)を通じて構造化出力を使用するには多くの利点がありますが、注意点もあります。
利点
- より強い保証: フリーテキストではなく、モデルはJSONスキーマに準拠するよう要求されます。
- パースが容易: レジックスやヒューリスティクスではなく、
json.loadsやPydantic / Zodによるバリデーションを直接適用できます。 - スキーマベースの進化: スキーマのバージョン管理を行い、フィールドを追加(デフォルト値付き)、後方互換性を維持できます。
- 相互運用性: 下流のシステムは構造化データを期待しています。
- 決定論(低温度で向上): 温度が低い場合(例: 0)、モデルはスキーマに厳密に従う可能性が高まります。Ollamaのドキュメントでもこれが推奨されています。
注意点と落とし穴
- スキーマの不一致: モデルがまだ逸脱する可能性があります。例えば、必須プロパティを見逃す、キーの順序を変える、余分なフィールドを含めるなどです。バリデーションが必要です。
- 複雑なスキーマ: 非常に深いまたは再帰的なJSONスキーマは、モデルを混乱させたり、失敗の原因となったりします。
- プロンプトの曖昧さ: プロンプトが曖昧であれば、モデルがフィールドや単位を誤って推測する可能性があります。
- モデル間の不一致: 構造化制約を守る能力は、モデルによって異なります。
- トークン制限: スキーマ自体がプロンプトまたはAPI呼び出しにトークンコストを加えます。
ベストプラクティスとヒント(Ollamaのブログと経験から得たもの)
- スキーマを定義し、JSONスキーマを自動生成するために**Pydantic (Python)またはZod (JavaScript)**を使用します。これにより、手動でのエラーを回避できます。
- プロンプトには、「JSONでのみ応答する」や「説明や余計なテキストを含めないでください」といった指示を必ず含めてください。
- ランダム性を最小限に抑え、スキーマへの遵守を最大化するために、temperature = 0(または非常に低い値)を使用します。Ollamaは決定論を推奨しています。
- JSONのパースに失敗したり、スキーマのバリデーションに失敗したりした場合、バリデーションし、フォールバック(例: リトライやクリーンアップ)を行います。
- 最初はよりシンプルなスキーマから始めて、徐々に拡張します。最初から過剰に複雑にしないようにします。
- 有用だが制約されたエラー指示を含めます。例えば、モデルが必須フィールドを埋められない場合、スキーマが許可している場合は、それを省略するのではなく
nullで応答するよう指示します。
Go 例1: LLM機能の抽出
ここでは、LLMの機能に関する構造化出力をQwen3に要求するシンプルなGoプログラムを紹介します。
package main

import (
	"context"
	"encoding/json"
	"fmt"
	"log"

	"github.com/ollama/ollama/api"
)

type LLMFeatures struct {
	Name             string   `json:"name"`
	SupportsThinking bool     `json:"supports_thinking"`
	MaxContextTokens int      `json:"max_context_tokens"`
	Languages        []string `json:"languages"`
}

func main() {
	client, err := api.ClientFromEnvironment()
	if err != nil {
		log.Fatal(err)
	}

	prompt := `
  Analyze the following description and return the model’s features in JSON only.
  Description:
  "Qwen3 has strong multilingual support (English, Chinese, French, Spanish, Arabic).
  It allows reasoning steps (chain-of-thought).
  The context window is 128K tokens."
  `

	// Define the JSON schema for structured output
	formatSchema := map[string]any{
		"type": "object",
		"properties": map[string]any{
			"name": map[string]string{
				"type": "string",
			},
			"supports_thinking": map[string]string{
				"type": "boolean",
			},
			"max_context_tokens": map[string]string{
				"type": "integer",
			},
			"languages": map[string]any{
				"type": "array",
				"items": map[string]string{
					"type": "string",
				},
			},
		},
		"required": []string{"name", "supports_thinking", "max_context_tokens", "languages"},
	}

	// Convert schema to JSON
	formatJSON, err := json.Marshal(formatSchema)
	if err != nil {
		log.Fatal("Failed to marshal format schema:", err)
	}

	req := &api.GenerateRequest{
		Model:   "qwen3:8b",
		Prompt:  prompt,
		Format:  formatJSON,
		Options: map[string]any{"temperature": 0},
	}

	var features LLMFeatures
	var rawResponse string
	err = client.Generate(context.Background(), req, func(response api.GenerateResponse) error {
		// Accumulate content as it streams
		rawResponse += response.Response

		// Only parse when the response is complete
		if response.Done {
			if err := json.Unmarshal([]byte(rawResponse), &features); err != nil {
				return fmt.Errorf("JSON parse error: %v", err)
			}
		}
		return nil
	})
	if err != nil {
		log.Fatal(err)
	}

	fmt.Printf("Parsed struct: %+v\n", features)
}
このGoプログラムをコンパイルして実行するには、フォルダollama-structにmain.goファイルがあると仮定しましょう。
このフォルダ内で、以下を実行する必要があります:
# initialise module
go mod init ollama-struct
# pull all the dependencise
go mod tidy
# build & execute
go build -o ollama-struct main.go
./ollama-struct
出力例
Parsed struct: {Name:Qwen3 SupportsThinking:true MaxContextTokens:128000 Languages:[English Chinese French Spanish Arabic]}
Go 例2: 複数モデルの比較
これを使用して、比較用のモデルのリストを抽出するように拡張できます。
  type ModelComparison struct {
		Models []LLMFeatures `json:"models"`
	}

	prompt = `
	Extract features from the following model descriptions and return as JSON:

	1. PaLM 2: This model has limited reasoning capabilities and focuses on basic language understanding. It supports a context window of 8,000 tokens. It primarily supports English language only.
	2. LLaMA 2: This model has moderate reasoning abilities and can handle some logical tasks. It can process up to 4,000 tokens in its context. It supports English, Spanish, and Italian languages.
	3. Codex: This model has strong reasoning capabilities specifically for programming and code analysis. It has a context window of 16,000 tokens. It supports English, Python, JavaScript, and Java languages.

	Return a JSON object with a "models" array containing all models.
	`

	// Define the JSON schema for model comparison
	comparisonSchema := map[string]any{
		"type": "object",
		"properties": map[string]any{
			"models": map[string]any{
				"type": "array",
				"items": map[string]any{
					"type": "object",
					"properties": map[string]any{
						"name": map[string]string{
							"type": "string",
						},
						"supports_thinking": map[string]string{
							"type": "boolean",
						},
						"max_context_tokens": map[string]string{
							"type": "integer",
						},
						"languages": map[string]any{
							"type": "array",
							"items": map[string]string{
								"type": "string",
							},
						},
					},
					"required": []string{"name", "supports_thinking", "max_context_tokens", "languages"},
				},
			},
		},
		"required": []string{"models"},
	}

	// Convert schema to JSON
	comparisonFormatJSON, err := json.Marshal(comparisonSchema)
	if err != nil {
		log.Fatal("Failed to marshal comparison schema:", err)
	}

	req = &api.GenerateRequest{
		Model:   "qwen3:8b",
		Prompt:  prompt,
		Format:  comparisonFormatJSON,
		Options: map[string]any{"temperature": 0},
	}

	var comp ModelComparison
	var comparisonResponse string
	err = client.Generate(context.Background(), req, func(response api.GenerateResponse) error {
		// Accumulate content as it streams
		comparisonResponse += response.Response

		// Only parse when the response is complete
		if response.Done {
			if err := json.Unmarshal([]byte(comparisonResponse), &comp); err != nil {
				return fmt.Errorf("JSON parse error: %v", err)
			}
		}
		return nil
	})
	if err != nil {
		log.Fatal(err)
	}

	for _, m := range comp.Models {
		fmt.Printf("%s: Context=%d, Languages=%v\n", m.Name, m.MaxContextTokens, m.Languages)
	}
出力例
PaLM 2: Context=8000, Languages=[English]
LLaMA 2: Context=4000, Languages=[English Spanish Italian]
Codex: Context=16000, Languages=[English Python JavaScript Java]
ちなみに、qwen3:4bもこれらの例では良好に動作し、qwen3:8bと同じような結果になります。
Go開発者向けのベストプラクティス
- スキーマへの最大限の遵守のために、温度を0に設定します。
- パースに失敗した場合のフォールバックを含め、
json.Unmarshalで検証します。 - スキーマはシンプルに保ちます。深くネストされたまたは再帰的なJSON構造は問題を引き起こす可能性があります。
- データの欠落を予期している場合、オプションフィールドを許可します(Goの構造体タグで
omitemptyを使用)。 - モデルが時折無効なJSONを出力することがある場合、リトライを追加します。
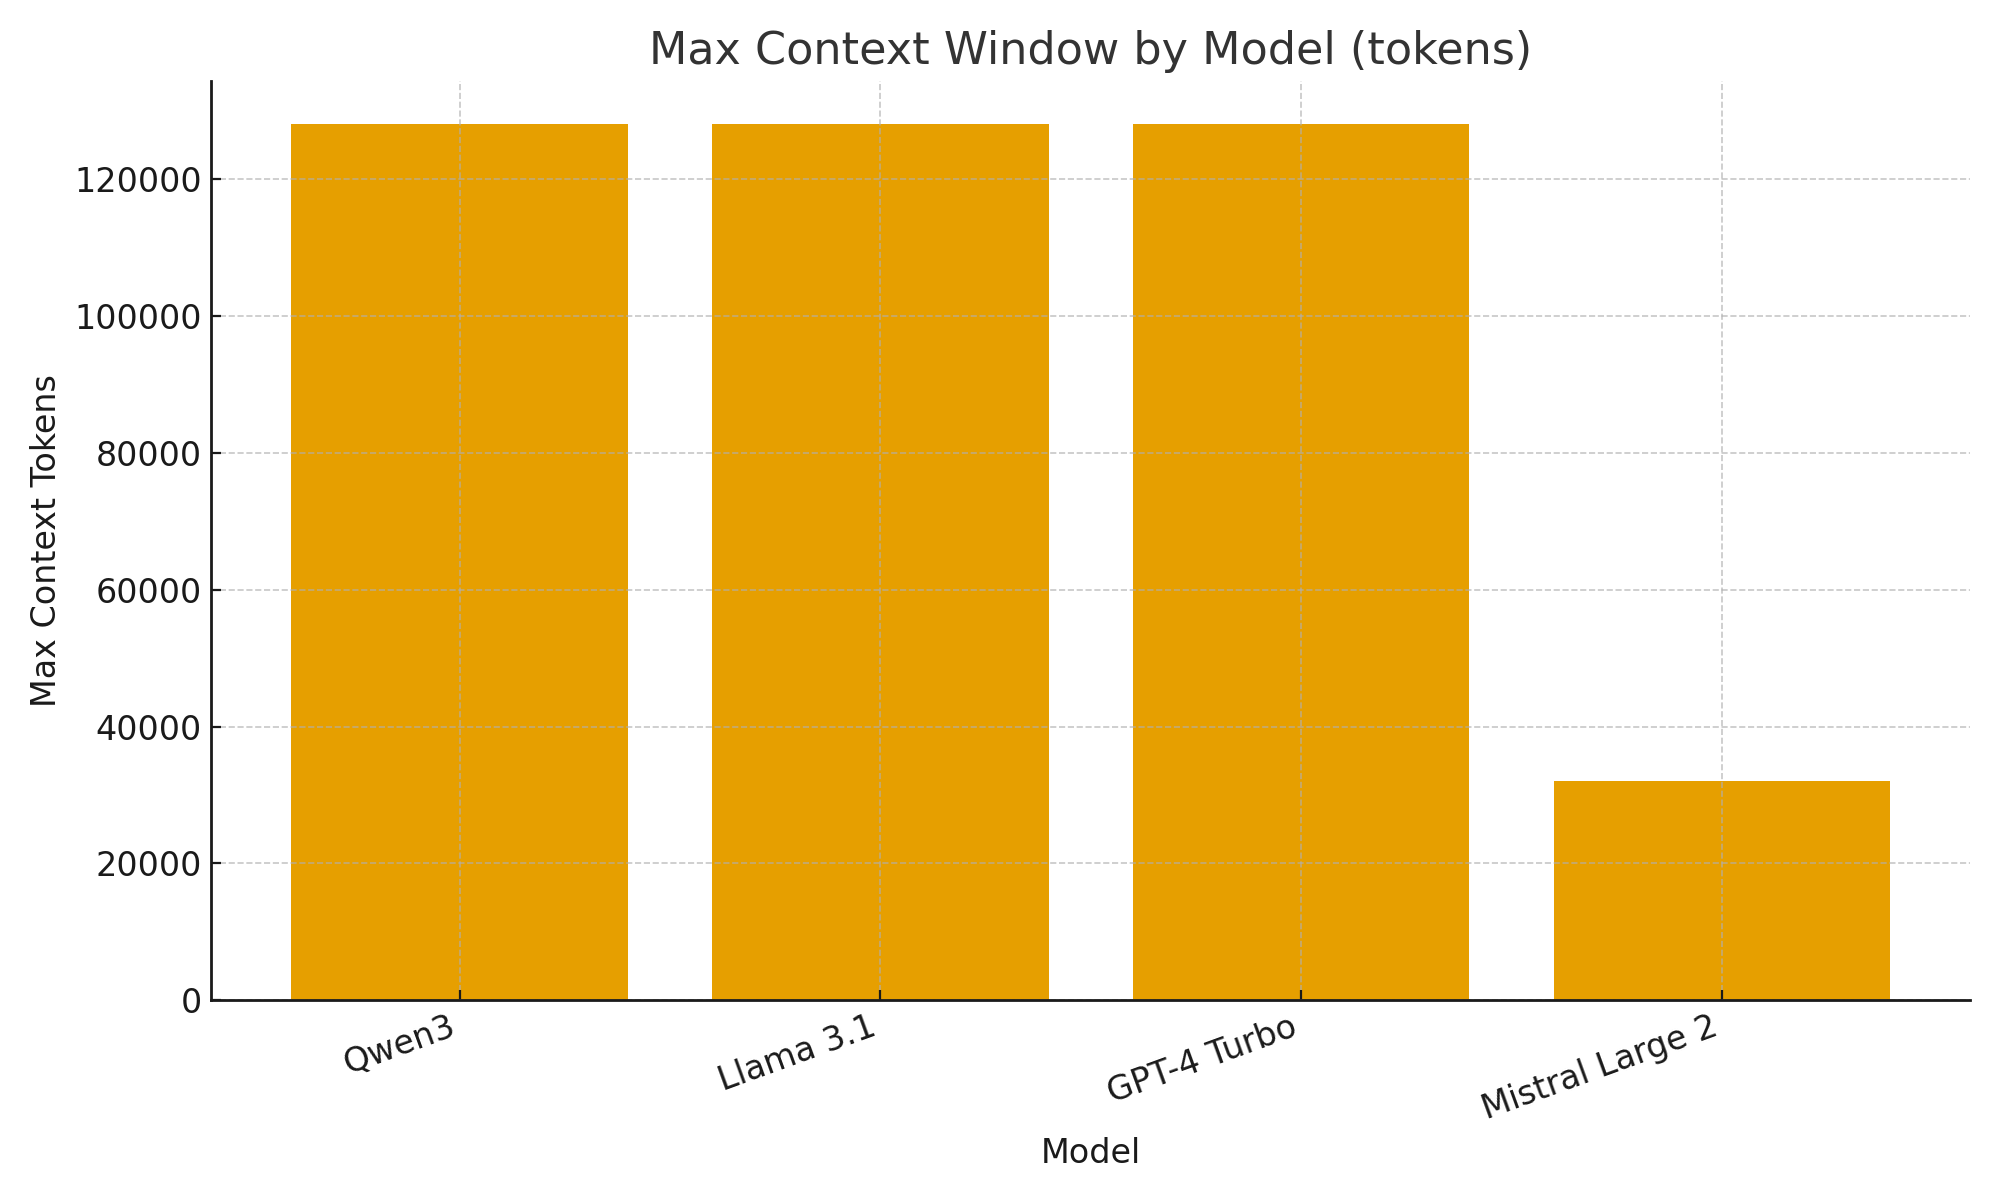
完全な例 - LLM仕様のチャート描画(構造化JSONから比較テーブルへ:段階的ガイド)
- 欲しいデータのためのスキーマを定義する
OllamaへのJSONスキーマの生成と、モデルの応答のバリデーションの両方を行うため、Pydanticを使用します。
from pydantic import BaseModel
from typing import List, Optional

class LLMFeatures(BaseModel):
    name: str
    supports_thinking: bool
    max_context_tokens: int
    languages: List[str]
- Ollamaに、その形状のJSONのみを返すよう要求する
スキーマをformat=に渡し、決定論のために温度を下げて設定します。
from ollama import chat

prompt = """
Extract features for each model. Return JSON only matching the schema.
1) Qwen3 supports chain-of-thought; 128K context; English, Chinese, French, Spanish, Arabic.
2) Llama 3.1 supports chain-of-thought; 128K context; English.
3) GPT-4 Turbo supports chain-of-thought; 128K context; English, Japanese.
"""

resp = chat(
    model="qwen3",
    messages=[{"role": "user", "content": prompt}],
    format={"type": "array", "items": LLMFeatures.model_json_schema()},
    options={"temperature": 0}
)

raw_json = resp.message.content  # JSON list of LLMFeatures
- バリデーションと正規化
本番環境で使用する前に、常にバリデーションを行ってください。
from pydantic import TypeAdapter

adapter = TypeAdapter(list[LLMFeatures])
models = adapter.validate_json(raw_json)  # -> list[LLMFeatures]
- 比較テーブルの構築 (pandas)
バリデーション済みオブジェクトを、ソート/フィルタリングおよびエクスポートできるDataFrameに変換します。
import pandas as pd

df = pd.DataFrame([m.model_dump() for m in models])
df["languages_count"] = df["languages"].apply(len)
df["languages"] = df["languages"].apply(lambda xs: ", ".join(xs))

# Reorder columns for readability
df = df[["name", "supports_thinking", "max_context_tokens", "languages_count", "languages"]]

# Save as CSV for further use
df.to_csv("llm_feature_comparison.csv", index=False)
- (オプション) 簡単な可視化
シンプルなチャートは、モデル間の違いを素早く目で確認するのに役立ちます。
import matplotlib.pyplot as plt

plt.figure()
plt.bar(df["name"], df["max_context_tokens"])
plt.title("Max Context Window by Model (tokens)")
plt.xlabel("Model")
plt.ylabel("Max Context Tokens")
plt.xticks(rotation=20, ha="right")
plt.tight_layout()
plt.savefig("max_context_window.png")
まとめ
Ollamaの新しい構造化出力サポートにより、LLMをチャットボットとしてだけでなく、データ抽出エンジンとして扱うことができます。
上記の例では、思考サポート、コンテキストウィンドウサイズ、サポート言語といったLLM機能に関する構造化メタデータを自動的に抽出する方法を示しました。これらは、それではもろいパースが必要となるタスクです。
LLMモデルカタログ、評価ダッシュボード、AI支援リサーチアシスタントのいずれを構築しても、構造化出力によって統合が滑らか、信頼性高く、プロダクションレディになります。
