
階層化コンテキスト:AIエージェントのための知識階層
エージェント記憶のための5層型知識階層構造
フラットな記憶ファイル1つしか持たないエージェントは、物を忘れることはない。しかし、要求されていないことを記憶し続けることを止めることもできない。解決策は、各知識レイヤーが異なるトリガーを通じてコンテキストに投入される階層的なコンテキストにある。
故障モードは忘却ではなく、その逆である。単一のフラットなストレートでは、すべての事実が同じ場所に存在し、同じ方法でコンテキストに入り、そのため常に同じ方法で利用可能になる。エージェントにクライアントのメールについて尋ねると、返信を作成しながらルーター設定について語ってくる。サービスをトラブルシューティングさせると、先月見積もったスポンサー料金を言及してくる。記憶の山はモノリス(単一構造体)である:ある関心事に対する変更は他のすべての関心事に影響し、すべてのクエリの影響範囲は全コーパスに及ぶ。
標準的なアドバイスは行動論的である:現在のトピックに関連するものをエージェントに教えること。これは、「重要な壁に『気をつけてください』と書くこと」にsoftware的に等しい — エージェントには指示ができ、大半の時間は従うだろう。しかし、従わない日というものが必ずある。構造的な代替案は、それが必要とされる活動が既に進行していない限り、会話はに入れない知識である。この記事は、その構造を5層の知識階層として定義する — 各レイヤーとは何か、その注入トリガーは何か、何が含まれるべきか、そしてどこで失敗するか — 并将其、具体的なマルチドメイン設定に適用する:一般プロファイル1つ、ホームラボ用1つ、個人用1つ、仕事用1つ、教育用1つ。
階層の命名
業界標準の用語は単一ではないため、ここでは定義を明示する。**知識階層(knowledge hierarchy)**とは、エージェントが知っているものを層状に並べたものである。各層は3つの性質で異なる:モデルのコンテキストに入る方法、許容されるサイズ、そして正しく留まる見込まれる期間である。知識アーキテクチャのレベルで、隣接するパラダイム — PKM、RAG、Wiki、記憶システム — は PKM vs RAG vs Wiki vs Memory Systems で比較され、アシスタントが実際に実装するランタイム契約は Memory Systems in AI Assistants でマップされている。どちらも Knowledge Management クラスターの中に位置し、人間の知識システムの基礎、方法、ツールをカバーする。この記事は、配置を強制可能にするトリガーベースの分類とプロファイル境界を追加する。
2つの系譜が、階層の形を説明する。
1つ目はCPUメモリ階層である。プロセッサは、いつか必要になるかもしれないすべてのバイトを同じレジスタに保存するわけではない。L1キャッシュ — 小規模、常にレジデント、決定なしでアクセス — L2、メインメモリ、ディスクがあり、各層はより大きく、アクセスがより遅く、上位層に答えがない場合のみアクセスされる。設計ルールは「すべてを速く保つ」ことではない。ほとんどのデータはまれにしか重要にならない。重要になった場合のみアクセスコストを支払え である。フラットな記憶ファイル1つしか持たないエージェントは、すべてがL1に詰め込まれたCPUである:レジスタファイルが巨大なので、すべてが見える。現在の命令が要求しなかったバイトも含めて。MemGPT はエージェントのために同じ動きを行い、メインコンテキストと外部ストレージ間のページングを備えた階層としてメモリをモデル化した。
2つ目は認知記憶分類学であり、知識を手順記憶(物事のやり方)、意味記憶(世界についての事実)、情景記憶(何が、いつ、誰に対して起きたか)に分類する。分類学が重要なのは、故障モードがタイプによって異なるからである:手順知識が古くなればそれはワークフローのバグであり、意味記憶が古くなればそれは誤った事実であり、情景記憶が漏洩すればそれはプライバシーインシデントである。場所ではなく内容のタイプで組織化された階層は、どの故障が危険であるかを教えてくれる。
この記事の組織軸は、上記のどちらでもない。知識がコンテキストに入る原因によって知識を分類する。注入トリガーがメカニズムであり、メカニズムこそが実際に強制できるものである。エージェントシステムは正確に4つのトリガーを提供する:
- 常に(Always)。 全ターンに、無条件で注入される。
- タスクトリガー。 現在の活動が宣言された条件に一致した時に読み込まれる。
- セマンティック検索(recall)。 現在のメッセージが保存された何かに類似している時に表面化される。
- 明示的参照。 タスクがファイルやクエリを名指ししたため取得される。
階層のすべてのレイヤーは、それを供給するトリガーによって定義される。それが設計のすべてであり、この記事の残りは、1つの表の詳細化である。
5つのレイヤー
| レイヤー | 内容 | 注入トリガー | 典型的なキャリア | サイズ規律 | 故障モード |
|---|---|---|---|---|---|
| 0 — アイデンティティ | エージェントとは何か、話す方法、しないこと | 常に | SOUL.md または同等のもの | 小規模;変更は稀 | ブLOAT(肥大化)— アイデンティティが事実ストアになる |
| 1 — レジデント記憶 | すべてのセッションに適用される永続的ファクト | 常に | MEMORY.md / USER.md または同等のもの | 文字数で予算管理;ポインタ密集 | モノリス — ドメイン事実が移動してくる |
| 2 — 手順(Procedural) | 繰り返しタスクのやり方、およびそのデータがある場所 | タスクトリガー | スキル | スキルごとに上限;手順でありデータではない | データの浸食 — スキルがデータベースになる |
| 3 — 参照 | 記録の源:テーブル、設定、契約、ランブック | 明示的参照 | ファイル、wiki | 無制限;grep可能、バージョン管理 | 陳腐化 — 誰も記録を更新しない |
| 4 — 検索された記憶 | 情景・関係性ファクト:決定、やり取り、状態変化 | セマンティック検索 | 検索機能を持つメモリバックエンド(例:ベクター/グラフストア) | 検索ごとに予算管理;タグでスコアリング可能 | 浸透 — 検索が誤ったドメインを表面化 |
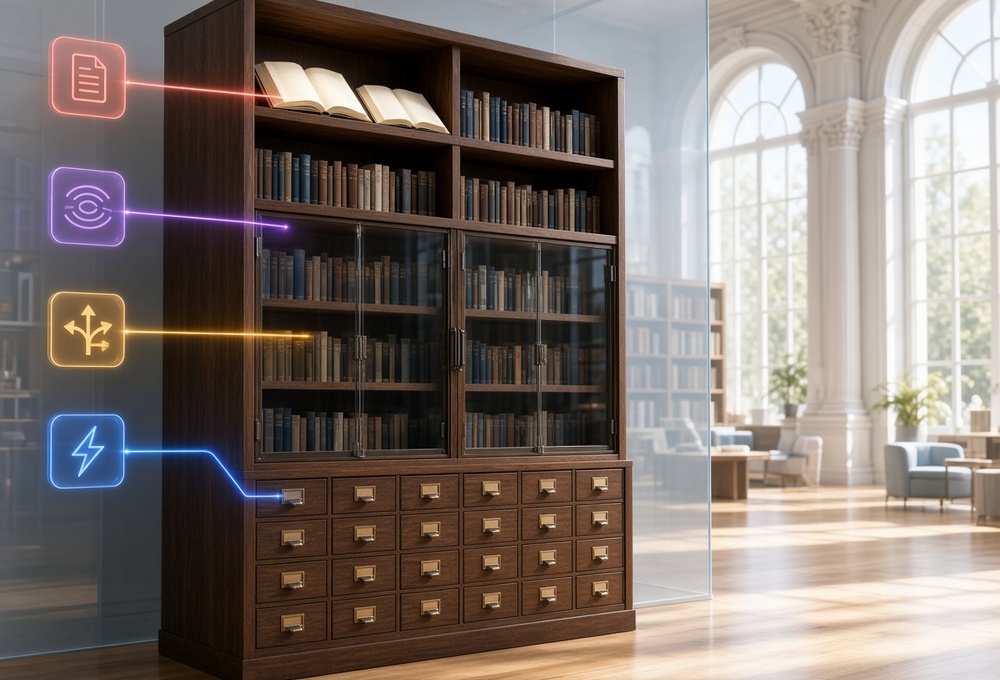
表は行に渡ってではなく、トリガー列を下に向けて読むこと。レイヤー0とレイヤー1はL1キャッシュである:常にレジデントという特権の代償として、微小であることが求められる。レイヤー2は命令キャッシュである:ブランチ条件、すなわちタスクがスキルトリガーと一致した時に取得される。レイヤー3はディスクである:タスクのステップが明示的に名のあるファイルを読み込むまでコンテキストに入らないため、巨大でよい。レイヤー4は厄介なものである — それはメインメモリであり、類似性によってアクセスされる。これは、あなたやタスクによる決定を含まない唯一のトリガーである。類似性は確率的なゲートであり、それが最も厳格な外部統制を必要とする理由であり、プロファイルセクションがそれを提供する。この記事の上部にあるキャビネットの画像は同じアイデアを符号化している:階層が上にあるほど、その内容がより自由に会話に入り、ガラスの仕切りは1つのドメインの棚が終わる場所を示す。
レイヤー0:アイデンティティ
SOUL.md、あるいはあなたのエージェントがシステムプロンプトと呼んでいるもの。その役割は who(誰であるか)を定義することであり、what(何をするか)ではない:トーン、価値観、拒否境界、記憶ポリシー。記憶ポリシーがここに含まれるのは、それがメモリを参照する前に効力を持つ必要がある唯一の指示だからである。サーバー名、クライアント名、または料金をリスト出し始めるアイデンティティファイルは、すでに失敗している — レイヤー0のバッジを付けたレイヤー1の内容となり、それが出てきてはならない会話にも乗ってくる。
レイヤー1:レジデント記憶
永続メモリファイル:一般的なノートとユーザープロファイル。このレイヤーを支配する2つのルールがある。これらは、機能する階層を積み重なった単なる山と区別するルールである。
第一に、ポインタであり、事実ではない。1つのドメインにのみ適用される事実なら、ここには属さない。正しいエントリは事実そのものではなく、標識である:
Infra facts: wiki/infra/ + memory bank 'homelab'.
Clients and contracts: wiki/business/clients/ + bank 'business'.
標識はドメインに中立であるため、どこに運んでも安全である。それが指し示す事実は、目的地を名指しした活動によってのみ読み込まれる。
第二に、強制されるハードバジェット。ストアに文字数制限がなければ、それは満たされ、満たされるのは常に最近議論されたトピックである — その結果、インフラの週が静かに一般コンテキストを追い出したり、インフラで囲ったりする。ほとんど満杯のバジェットはトリアージ(選別)を強制し、トリアージはこのレイヤーを誠実に保つ唯一のメカニズムである。Hermesの実装は機能する例である:MEMORY.md は2,200文字、USER.md は1,375文字の上限で、セッション開始時にフリーズブロックとして注入される。これは Hermes Agent Memory System に記載されている。
レイヤー2:手順知識
スキルは、エージェントが how(やり方)を符号化する手段である:手順、落とし穴、そして — この記事にとって重要であり — より深いレイヤーへのポインタ。ホームラボ管理のスキルは、インベントリを含むwikiディレクトリと、検索すべきメモリバンクを名指しする。クライアント作業のスキルは、契約ストアとビジネスバンクを名指しする。スキルの説明はそのトリガーである:手順、したがってそのポインタがコンテキストに入るかどうかを決定するブランチ条件である。
これは階層を操作上機能させるレイヤーであり、「何が起きているか」と「その活動が見えるデータは何か」の間のシームだからである。クライアントメールに関するタスクはクライアントスキルを読み込む;クライアントスキルはビジネスバンクと契約ディレクトリを名指しする;ホームラボバンクとインフラディレクトリは、タスクが歩いたパスからは参照されない。
故障モードはデータの浸食である:実際のクライアントリストや実際のIPテーブルをスキル本体に貼り付けること。そうすると、データは手順が読み込まれるたびに常に読み込まれ、手順のトリガーがデータの露出境界になる。スキルはデータへのパスを運び、機密なものは他には運ばない。
レイヤー3:参照データ
Wiki、ノートツリー、記録の源。最も制約が少なく、驚きが少ないレイヤーである。なぜなら、決定的なアクセスパスを持つ唯一のレイヤーだからである:タスクのステップが明示的にそのファイルを読み込んだため、コンテキストに入ることがある。テーブル、インベントリ、契約、ランブック、統計 — データベースや設定管理システムに保持するもの。コーパスがLLMによって維持されている場合、LLM Wiki パターンが適用される:統合は取り込み時に発生し、結果は構造化されたリンク付きページとして保存される。
参照データがレイヤー4ではなくここにある理由は、検索品質がテーブルには誤ったツールだからである。セマンティック検索は「クライアントXが締切について何を確認したか」には優れているが、「ホストY上のサービスのポートは何ですか」には劣る — 後者は正確に1行のみ正しく、再ランキングが3つの最も近い段落を返すことは負荷になる。決定的な検索が参照データに勝る;類似性がエピソードに勝る。それらを分離し、各レイヤーのアクセスパターンがその内容の形状と一致させる。
故障モードは陳腐化であり、それはアーキテクチャの問題ではなく、保守の問題である:記録が現実からずれていき、エージェントはすべて正しく行っているが、誤ったテーブルから作業する。緩和策は、記録の源が必要なものと同一である — 1ファイルにつき1人のライター、変更ログ、監査サイクル — に加えて、LLM Wiki Maintenance: Drift, Contradictions and Review でカバーされるドリフト検出と矛盾チェックの実践である。
レイヤー4:検索された記憶
ターンごとの自動検索を備えたメモリバックエンド:エージェントの情景記憶と関係性記憶。決定とその日付、「クライアントXがYを確認した」、「Zを試したが機能しなかった」。これは、システムの動的な自己組織化部分が住む場所であり — セキュリティの物語が興味深い場所でもある。セマンティック検索は確率的なゲートであり、確率的なゲートは浸透するからである。
「クライアントXの請求に関する質問」と「どのホストが請求サーバーを動かしているか」は埋め込み空間で近い。クライアント記録とインフラインベントリを両方保持する単一のバンクは、前者の後者に、無視できない確率で後者を表面化する。タグと検索制限でこれを狭めることができるし、そうすべきである — しかし、混合コーパス上のタグフィルターは規律であり、構造ではない。構造的な答えは混合を止めることである:ドメインごとに1つのバンク。そうすることで、検索の浸透半径は、構造により、1つのドメインになる。バックエンド自体の選択 — キャプチャポリシー、依存関係、セルフホスティング制約 — は別の比較であり、Agent Memory Providers Compared でカバーされる。
このレイヤーを接続する際、2つの機械的な詳細が重要である。書き込みパスと読み込みパスは別々の制御である:バンクは検索には含まれつつ保持からは除外できる。これは、すべてを読み取り何も書き込みないプロファイルを作る方法である。そしてすべてのバンクは、そのバンクが存在して保持すべきものの短いステートメント、すなわち保持ミッションを持っているべきである。「クライアントのやり取り、契約条件、交渉の状態;決してインフラ詳細を含まない」というミッションを持つビジネスバンクは、抽出がミッションを読み込むLLM呼び出しであるため、それに応じて抽出する。OpenAI’s personalization cookbook は、統合をメモリライフサイクルの中で最も敏感かつ誤りやすい段階として扱う — 保持ミッションは、その段階を誠実に保つ契約である。
プロファイル:分離を構造的にする境界
ここまでの、階層は知識をレイヤーによって分離する — 必要だが十分ではない。上記の5レイヤーは、1つのエージェントの解剖学である。この記事が始まった質問はドメインに関するものである:ホームラボ、個人、仕事、教育、それらを超一般コンテキスト。
ドメイン分離のメカニズムはプロファイルである — エージェントの完全で独立したインスタンス:独自のアイデンティティファイル、独自のレジデント記憶、独自のスキルディレクトリ、独自にスケジュールされたジョブ、そして決定적으로、独自のメモリバンクの配線。プロファイルは会話へのタグではなく、偶然1つの機械を共有する別個のシステムである。agent -p homelab を実行すると、レイヤー0からレイヤー4までがホームラボドメインにスコープされたプロセスが得られ、その検索プールにビジネスバンクを含むことはできない。なぜならビジネスバンクは、その構成に全く存在しないからである。
これは、漏洩問題への2つの答えの違いである。「ビジネス会話でインフラを公開しないでください」はプロンプト指示である — 確率である。「ビジネスプロファイルの検索プールにはインフラバンクが含まれていない」は設定である — 保証である。階層は、何がどこにあるかを教えてくれる;プロファイル境界は、配置を会話の中からバイパス不能にするものである。
5ドメインの実演例:
| common (default) | homelab | personal | work | education | |
|---|---|---|---|---|---|
| アイデンティティ (L0) | 共有ベース + 記憶ポリシー | ベース + 「インフラオペレーター」フレーム | ベース + 「プライベート、ビジネストーン禁止」 | ベース + 「プロフェッショナル、クライアント対応」 | ベース + 「教師、事前知識なしと仮定」 |
| レジデント記憶 (L1) | ポインタのみ — 4つのドメインホームへ | ホームラボポインタ、機械事実 | 個人ポインタ | 仕事ポインタ | コースポインタ |
| スキル (L2) | 一般的なワークフロースキル | インフラスキル、ランブックスキル、モニタースキル | — | クライアント運営スキル、アウトリーチスキル | 授業計画スキル |
| 参照 (L3) | Wikiの共有インデックス | wiki/infra/ | wiki/personal/ | wiki/business/clients/ | wiki/education/ |
| 保持バンク (L4) | なし (読み取り専用) | bank: homelab | bank: personal | bank: business | bank: education |
| 検索専用バンク (L4) | homelab, personal, business, education | — | — | — | — |
その表の2つのセルが、重い作業を行う。
commonプロファイルのバンク行は「なし、読み取り専用」である。一般的な会話は、横断的な質問をする場所であり、そのため、すべてのドメインの検索された事実を見るべきである — しかし、それらのいずれかへの書き込みはしないべきである。一般的なセッションでのチャットは、ドメインの永続メモリに抽出したくない材料そのものであり、読み取り専用配線はモデルから選択を完全に排除する。バックエンドの配線が検索専用バンクリスト(書き込みバンクから分離)をサポートする場合、これはドメインバンクごとに設定1行である;サポートしない場合、commonプロファイルは専用のgeneralバンクから検索し、弱いクロスドメインビューを受け入れることになる。
ドメインプロファイルの検索行は空である。各ドメインプロファイルは正確に1つのバンクを見る。ホームラボプロファイルは、クライアントの契約条件を検索することはない。指示されたからではなく、その用語がクエリするプールに含まれていないからである。これは、この演習全体の目的である双方向分離である:それは指示をどちらの方向にも関与させることなく、構造により対称的に機能する。
3つの操作的な帰結が folgen し、それがプロファイルアプローチが単一エージェントアプローチよりコストがかかるが、真に不連続なドメインを持つ人にとってはそれに見る価値がある理由である。
- トリガーが表面になる。ホームラボ作業が
-p homelabで起動するターミナルで行われ、クライアント作業が仕事プロファイルにルーティングされたメッセージングアカウントで行われる場合、あなたが被っている帽子は、エージェントを呼び出した方法の性質であり、あなたが状態を覚えているべきフラグではない。誤誘導 — 不注意でホームラボコンテキストでクライアントタスクを実行すること — は、誤ったシェルを実行することと同様に顕著になる。 - スケジュールされた作業が境界を継承する。Cronジョブと委譲されたサブタスクは、それらを所有するプロファイルの中で実行される。ホームラボプロファイルでスケジュールされた毎晩のインフラチェックは、ビジネス内容をホームラボバンクにドリフトさせることはできない。なぜなら、それを決して持たないからである。
- ファイルシステムは共有であり、それが誠実な限界である。プロファイルはコンテキストを分離するが、アクセスではない。すべてのプロファイルのターミナルは、すべてのプロファイルのファイルを読み取ることができる;境界は会話を保護するが、ディスクではない。したがって、本当に機密の材料を持つレイヤーは独自の規律を必要とする:Wikiのプレーンテキストではなく、環境ファイルやシークレットストアでの資格情報、パブリックリポジトリ外でのWiki、OSが助ける場合のディレクトリごとの権限。プロファイル境界はコンテキストのためのファイアウォールとして扱い — それの仕事は優れている — データのためのファイアウォールと誤解させないでください。
フラットな山からのブートストラップ
階層は通常、下から到達する:1つのメモリファイルから始まり、今もすべてをそこに保持しているエージェント。移行の順序が重要であり、なぜなら各ステップは、前のものが完了した後のみ安価だからである。
第一に、検索プールの分割。ドメインごとに1つのメモリバンクの作成は、コンテンツのリライトではなく設定変更である — そして、それは最もレバレッジの高いステップであり、検索の浸透はバンクが分割した日に止まるからである。コンテンツはその後で移行できる;境界はそれを待つべきではない。
第二に、レイヤー1のバジェット設定。レジデントファイルに文字数上限を設定し、次に上限に対して既存の内容を監査する。ドメイン固有の事実は、それらが存在する場所へのポインタになる;残るものは、本当にすべてのセッションに適用されるものである。
第三に、降格された事実に目的地を与える。ドメインごとに1つのwikiディレクトリ、1人のライターと変更ログの規律で、レイヤー1が解放するものを受け取る。スキルは、存在しないディレクトリを名指しするスキルは、スキルがないより悪いから、最後にそのポインタを取る。
階層が腐る場所
アーキテクチャはその保守と同程度の品質であり、各レイヤーは特徴的な方法で腐る。
レイヤー1が最初に満たされる。最も便利な書き込みパス(「これを覚えておいて」)を持つレイヤーであり、偽装されたドメイン事実が最初に蓄積される。バジェットはこの見えを可視化する:ストアが90%満杯になった時、ポインタであるべきエントリを監査する。修正は常に同じ動きである — 事実をレイヤー3に降格し、標識を昇格させる。
レイヤー2が次に浸食する。スキルは、手順とデータが一緒に住みたい場所である。「手順が常にデータを参照する」ことは、書き込み時に妥当に感じられるからである。チェックは機械的である:スキル本体に、何らかのものへの真実の源であるテーブルが含まれている場合、それはwikiに属し、スキルはパスを運ぶべきである。
レイヤー4が静かにドリフトする。検索された記憶は追記志向であり自己説明的であるため、古いエピソードは修正されることはなく、ただ寿命を終える。検索の前書き(「これらの記憶は過去の文脈であり、検証された事実ではない」)は標準的な緩和策である。よりクリーンな緩和策は、レイヤー3が使用するものと同一である:エピソードが永続的ファクトになった時(「クライアントはこの日にこの条件で署名した」)、それは記録の源に書き込まれ、そこで可視かつ編集可能になり、バンクはナラティブのみを保持する。このドリフトのより鋭いバリアント — エージェント自身の推論が証拠として書き戻されること — は Self-Reinforcing Memory Loops in AI Agents で詳しく扱われている。
プロファイルが増殖する。5つのプロファイルは管理可能だが、15つは艦隊である。規律は、新しいドメインが現れた時のみ、新しいプロファイルが現れることである — 新規プロジェクト、新規ツール、新規ムードのためではない。プロジェクトレベルの分離は参照レイヤーのディレクトリ構造が担うものであり、ドメインレベルの分離がプロファイルが担うものである。2つの混同は、プロファイル動物園と明確な検索ストーリーのない状態に人がなる方法である。
要点:1つの配置ルール
すべての知識の断片を、そのトリガーがそのニーズと一致する最も浅いレイヤーに置く:常に必要な事実はレジデント記憶のポインタとして、手順はスキルに、参照データはファイルに、エピソードはバンクに — そして、他のドメインのプロファイルが検索できないプロファイルの背後に各ドメインのバンクを置く。その時、エージェントはよく設計されたシステムのように振る舞う:正しい知識が存在するのは、正しい活動がそれを要求したからであり、誤った知識が欠如するのは、会話の中にそれがアクセスするパスを持たなかったからであり、2つを一緒に強制できる唯一のものは、設定の変更 — あなたが意図的に行うものであり、したがってそれが起きた時にそれを視認できるもの — である。
フラットな山は決して規律の失敗ではなかった。それは、すべての事実が1つのトリガーを共有するアーキテクチャであり、そのトリガーは「常に」である。トリガーを分離し、漏洩はモデルの判断の問題ではなくなる。それは可能ではなくなる。
参考文献
- PKM vs RAG vs Wiki vs Memory Systems — 個人知識ストア、検索パイプライン、エージェント記憶の基礎的比較
- Memory Systems in AI Assistants — この階層が座るランタイムメモリスタック
- Retrieval vs Representation in Knowledge Systems — なぜストアの形状が、それが答えられるものを決定するか
- AI Systems Memory hub
