
16GB GPUでのQwen 3.6 27Bおよび35B MTP版と標準版の比較
RTX 4080におけるMTPと標準デコーディングの実ベンチマーク比較
Qwen 3.6 27B と 35B において、RTX 4080(16 GB VRAM)上で投機的デコーディング(マルチトークン予測、MTP)のパフォーマンスをテストしました。
同じハードウェア上で、より多くのモデルにおけるトークン速度と VRAM のトレードオフについてより幅広い視点を得たい場合は、16 GB VRAM での llama.cpp による LLM ベンチマーク をご覧ください。
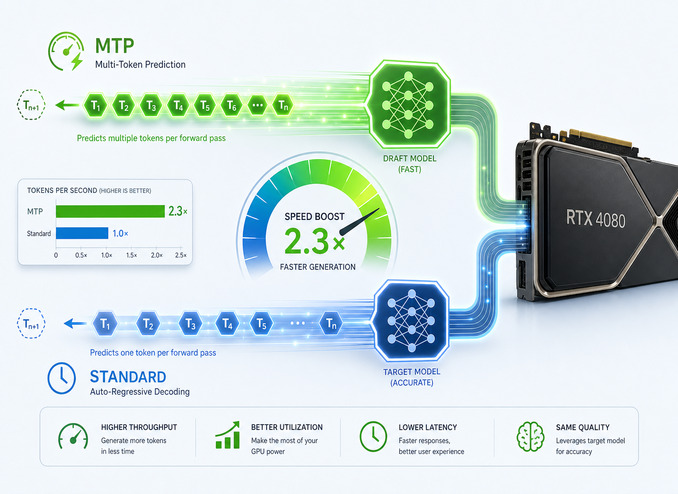
MTP(マルチトークン予測)とは
マルチトークン予測(MTP)は、特定のモデルチェックポイントに直接組み込まれた投機的デコーディングの一種です。1 回のフォワードパスにつき 1 つのトークンを予測するのではなく、モデルは追加の「MTP ヘッド」を持っています。このヘッドが単一のステップで複数の将来トークンを提案し、その後並列でそれらを検証します。予測が受理された場合、出力品質を変えずに実効スループットが向上します。
Qwen 3.6 ファミリーには、標準 GGUF ファイルと MTP 有効化されたバリエーションの両方が提供されています。llama.cpp では、MTP は以下のようにアクティブ化されます。
--spec-type draft-mtp --spec-draft-n-max 3
--spec-draft-n-max が重要な調整ポイントです。これは、MTP ヘッドが各ステップでいくつの投機的トークンを提案するかを設定します。値が高いほど潜在的な速度向上が見込めますが、ドラフトバッファのための追加の VRAM コストが発生します — 16 GB の GPU では実質的な制約となります。
テスト内容と方法
**16 GB VRAM 搭載 GPU(RTX 4080)**で、2 つの Qwen 3.6 モデルが MTP 有効時と標準デコーディング時でどのように動作するかをテストしました。
モデル重みと KV キャッシュを VRAM に収めるため、強く量子化されたバリエーションを使用しました。
Qwen3.6-27B-UD-IQ3_XXSおよびQwen3.6-27B-UD-IQ3_XXS-MTPQwen3.6-35B-A3B-UD-IQ3_SおよびQwen3.6-35B-A3B-UD-IQ3_S-MTP
各ランにおいて、2 つのコンテキスト予算を追跡します。
- Avg Ctx(平均コンテキスト) — llama.cpp が約 14.8 GB の VRAM を占有し、他のアプリ(Xorg、GNOME Shell、Cursor)に快適な約 500 MB のバッファを残すときのコンテキストサイズ。
- Max Ctx(最大コンテキスト) — 同じデスクトップアプリがすでに約 500 MB の VRAM を保持していることを前提として、llama.cpp が割り当て可能な最大のコンテキスト。
平均コンテキストを実用的な目標に保つ重要な理由は、このマシン上で llama.cpp に接続する主要な AI アシスタントとして使用している Hermes Agent が、デフォルトで少なくとも 64K コンテキストを必要とするためです。より小さなウィンドウを持つモデルは、起動時に拒否されます。その閾値未満のモデルでは、多段階のツール呼び出しワークフローに必要な十分なワーキングメモリを維持できません。llama.cpp では、これは --ctx-size 65536 以上を渡すことを意味します。したがって、平均使用可能コンテキストを 64K 未満に大幅に圧縮する MTP 設定は、日常的な Hermes ワークロードには適していません。それが、以下の表の Avg Ctx の数値が最も決定に relevant なものである理由です。
両方の KV キャッシュ量子化レベルがテストされました:q8(高い品質、多くの VRAM)と q5(少ない VRAM、長いコンテキスト)。q8 から q5 への KV キャッシュの変更が著しい品質の低下を引き起こす可能性があることに注意してください。私のテストでは、劣化は q5 が私のワークロードに不向きなほど重大でした。q5 の速度とコンテキストの数値は完全性のために含めていますが、採用する前に、ご自身のタスクでレスポンス品質をテストすべきです。
Qwen 3.6 27B MTP vs 標準
KV キャッシュ q8
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | 標準 (IQ3_XXS) | |
|---|---|---|---|---|---|
| Prompt 速度 | 148 t/s | 151 t/s | 148 t/s | 147 t/s | 200 t/s |
| Gen 速度 | 65 t/s | 75 t/s | 73 t/s | 75 t/s | 45 t/s |
| Avg Ctx | 40 K | 40 K | 40 K | 30 K | 80 K |
| Max Ctx | 60 K | 60 K | 60 K | 50 K | 100 K |
q8 KV キャッシュでは、--spec-draft-n-max 2 での MTP は、平均コンテキストウィンドウを 80K から 40K に半減させるコストで、約 67% 高速な生成(45 t/s に対し 75 t/s)を実現します。MTP はプリフィルフェーズ中にデバイスからホストへの転送を必要とするため、プロンプト取り込み速度は 200 t/s から約 150 t/s に低下します。
KV キャッシュ q5
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | 標準 (IQ3_XXS) | |
|---|---|---|---|---|---|
| Prompt 速度 | 145 t/s | 144 t/s | 141 t/s | 139 t/s | 191 t/s |
| Gen 速度 | 57 t/s | 62 t/s | 67 t/s | 66 t/s | 41 t/s |
| Avg Ctx | 70 K | 60 K | 60 K | 50 K | 130 K |
| Max Ctx | 100 K | 100 K | 90 K | 80 K | 160 K |
q5 KV キャッシュに切り替えることで、意味のあるコンテキストが回復します。--spec-draft-n-max 1 は 57 t/s で平均コンテキスト 70K を提供し、コンテキストウィンドウを実用的なサイズに保ったまま、標準デコーディングに対して39% の生成速度向上を実現します。--spec-draft-n-max 3 ではコンテキストが 60K に低下しますが、生成速度は 67 t/s(+63%)に達します。
Qwen 3.6 27B まとめ
MTP は 27B dense モデルに対して真に有用です。16 GB VRAM での最適点は以下の通りです。
- q8 KV +
--spec-draft-n-max 2— 最速の生速度(75 t/s)、コンテキストは 40–60 K - q5 KV +
--spec-draft-n-max 1— 速度とコンテキストのバランスが最良(57 t/s、平均コンテキスト 70 K)
Qwen 3.6 35B MTP vs 標準
35B モデルは、Mixture-of-Experts(MoE)アーキテクチャです(35B-A3B は総パラメータ 35B、トークンあたり約 3B がアクティブであることを意味します)。MoE モデルは通常、スパースルーティングにより、完全なフォワードパスに対して MTP ヘッドの計算コストが相対的に安いため、MTP の恩恵をより大きく受けます。
KV キャッシュ q8
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | 標準 (IQ3_S) | |
|---|---|---|---|---|---|
| Prompt 速度 | 277 t/s | 277 t/s | 265 t/s | 275 t/s | 368 t/s |
| Gen 速度 | 186 t/s | 189 t/s | 180 t/s | 171 t/s | 146 t/s |
| Avg Ctx | 15 K | 10 K | — | — | 80 K |
| Max Ctx | 80 K | 70 K | 60 K | 50 K | 150 K |
MoE アーキテクチャは、MTP を使用して印象的な生の生成速度をもたらします(max 1 で +27%、max 2 で +29%、標準の 146 t/s に対し)。しかし、実用的な問題は平均コンテキストです。q8 KV キャッシュでは、--spec-draft-n-max 1 でも平均コンテキストはわずか 15 K しか与えられず、中程度のタスクにはかろうじて十分なレベルです。16 GB のカードでは、より深いドラフト深度では実用的な平均コンテキストが全く存在しません。
これはコンシューマーハードウェアでの MTP の VRAM コストに関する核心的な問題です。追加のドラフトバッファは残りの VRAM バジェットを直接食い込み、35B-A3B モデルが q8 KV キャッシュを使用すると、ほとんど余裕がなくなります。
KV キャッシュ q5
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | 標準 (IQ3_S) | |
|---|---|---|---|---|---|
| Prompt 速度 | 264 t/s | 266 t/s | 270 t/s | 264 t/s | 343 t/s |
| Gen 速度 | 151 t/s | 147 t/s | 137 t/s | 131 t/s | 122 t/s |
| Avg Ctx | 10 K | — | — | — | 120 K |
| Max Ctx | 120 K | 110 K | 110 K | 80 K | 200 K |
q5 KV キャッシュは、平均コンテキストの状況をわずかに改善するだけです。--spec-draft-n-max 1 は 151 t/s で平均コンテキスト 10K を提供します。q5 での標準デコーディングは、平均コンテキスト 120K で 122 t/s です。
Qwen 3.6 35B まとめ
16 GB GPU において、35B MoE モデルと MTP は厳しい壁に直面します:平均使用可能コンテキストが 10–15 K トークンまで崩壊し、実際のワークロードに対して実用的ではなくなります。80–120 K のコンテキストで 122–146 t/s の標準デコーディングの方が、実際のタスクに対してはるかに有用です。
24 GB 以上の VRAM を持っている場合、35B + MTP の組み合わせははるかに魅力的になります — コンテキストウィンドウの問題が消え、速度の恩恵を維持できます。
適切な --spec-draft-n-max 値の選択
各ステップでいくつの投機的トークンを提案するか(--spec-draft-n-max)という問いには、単一の正解はありません — それはモデルアーキテクチャと利用可能な VRAM の両方に依存します。
- 16 GB での 27B dense:q8 KV を用いた
--spec-draft-n-max 2が最速です。q5 KV を用いた--spec-draft-n-max 1がコンテキストにとって最も優しい設定です。 - 16 GB での 35B MoE:
--spec-draft-n-max 1は使用可能なコンテキストを保つ唯一の選択肢ですが、それでもわずかな改善にすぎません。 - より高い値(
3、4)は、比例した速度向上なしに VRAM への圧力を高めます — max 4 では max 2 とほぼ同じ追加の VRAM を消費しますが、生成速度はその pace を追い付きません。
llama.cpp で MTP を有効にする方法
MTP 対応の GGUF(ファイル名に MTP を含むもの)を使用することを確認してください。llama.cpp のフラグが初めての場合、llama.cpp クイックスタート(CLI とサーバー) がすべての基礎をカバーしています。その後、llama-server または llama-cli を以下で起動します。
llama-server \
  --model Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf \
  --ctx-size 40000 \
  -ngl 99 --flash-attn on \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --spec-type draft-mtp \
  --spec-draft-n-max 2
q5 KV キャッシュの場合、q8_0 を q5_1 または q5_0 に置き換え、--ctx-size を上方に調整します。
llama-server \
  --model Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf \
  --ctx-size 80000 \
  -ngl 99 --flash-attn on \
  --cache-type-k q5_1 --cache-type-v q5_1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 1
llama.cpp が GGUF ファイル内の MTP ヘッドを確認し、--spec-type draft-mtp が設定されると、MTP は自動的にアクティブ化されます。
そのため、標準の Qwen3.6-27B-UD-IQ3_XXS.gguf は MTP モードでは動作せず、Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf が必要になります。
ただし、Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf は、投機的デコーディングモードと自動回帰モードの両方で動作します。
結論
16 GB GPU(RTX 4080)で、これらの量子化レベルにおいて、llama.cpp の MTP は実用的な使用において Qwen 3.6 27B に対して明確な優位性を持ち、Qwen 3.6 35B に対してはむしろ不利です。
Qwen 3.6 27B (IQ3_XXS) — MTP は価値がある:
- q8 KV + MTP max 2 → 生成速度が約 67% 向上、コンテキスト 40–60 K(MTP なしの場合 80–100 K)
- q5 KV + MTP max 1 → 生成速度が約 39% 向上、コンテキスト 70–100 K(MTP なしの場合 130–160 K)
--spec-draft-n-max 2で速度と VRAM 効率のバランスが良好
Qwen 3.6 35B (IQ3_S) — 16 GB では MTP は実用的ではない:
- 生成速度は 27–29% 高いものの、平均コンテキストは q8 で 10–15 K、q5 で 10 K にまで崩壊する
- 80–120 K のコンテキストで 122–146 t/s の標準デコーディングの方が、実際のタスクに対してより有用
- 24 GB 以上の VRAM では状況が大幅に改善する
紙面上では、q5 KV キャッシュは MTP の速度向上を維持しながらコンテキストウィンドウを最大化するための明らかな答えですが、実際には q8 から q5 への移行による品質の低下は重大になり得ます。採用する前にご自身のタスクで q5 をテストしてください。私のワークロードでは劣化は許容できず、より厳しいコンテキスト予算での q8 が依然としてより良いトレードオフでした。
LLM サービングオプションとインフラストラクチャのトレードオフについてより広い視点を得るには、2026 年の LLM ホスティング パイラーと 2026 年の LLM パフォーマンス を参照してください。この 27B クラスが 2026 年のサイズとコストのスペクトラム上でどこに位置し、なぜ現在の Qwen3.8-27B Q4 ビルドは 24 GB カードを必要とするのか、一方上記の測定値は 16 GB に留まっているのかは、2026 年のオープンモデルの効率的フロンティア にあります。MTP と並行して Qwen 3.6 のサンプラー設定をチューニングしている場合、Qwen 3.6 および Gemma 4 向けのエージェント型 LLM 推論パラメータ参考資料 が有用な補完資料となります。
