
LLM ASICと専用推論チップ(その重要性)
ASICおよびカスタムシリコンにより、LLM推論の速度と効率を追求する
AIの未来は、より賢いモデルに関するものだけでなく、それらのモデルが実際にサーブされる方法に合致したシリコンについてもです。LLM推論向けに特化したハードウェアは、Bitcoin採掘がGPUから目的構築されたASICへ移行したことを彷彿とさせる道を進んでいますが、モデルと精度のレシピが絶えず進化しているため、より厳しい制約条件があります。
スループット、レイテンシ、VRAM、およびランタイムとハードウェア全体のベンチマークについて詳しくは、LLM性能:ベンチマーク、ボトルネックと最適化をご覧ください。
 Electrical Imagination - Fluxテキストから画像生成LLM。
なぜLLMは推論専用ハードウェアから恩恵を受けるのか
大規模言語モデルはAIを変革してきましたが、すべての流暢な応答は、巨大で予測可能な行列演算とメモリトラフィックのストリームに依存しています。推論への支出が増大するにつれ(しばしばモデルのライフサイクル全体においてトレーニングを上回る傾向にあり)、あらゆるワークロードに対応するのではなく、サーブ専用に最適化されたチップが経済的に魅力的になります。
Bitcoin採掘との類推は不完全ですが、教訓に富んでいます。どちらも反復的で境界が明確なタスクであり、ダイからの未使用の汎用性を除去することで、スループットと有用な操作あたりのジュールあたりの大幅な向上が実現できます。
Bitcoin採掘の歴史が推論ASICについて示唆すること
Bitcoin採掘は4世代にわたり進化してきました:
| 時代 | ハードウェア | 主な利点 | 制限事項 |
|---|---|---|---|
| 2015–2020 | GPU (CUDA, ROCm) | 柔軟性 | 電力消費大、メモリ依存 |
| 2021–2023 | TPU, NPU | 粗粒度の専門化 | まだトレーニング志向 |
| 2024–2025 | Transformer ASIC | 低ビット推論向け調整 | 汎用性の制限 |
AIは、同様の道を辿っています。各世代の移行により、性能とエネルギー効率は何桁もの向上が見られました。
ただし、Bitcoin ASIC(SHA-256のみを計算)とは異なり、推論ASICにはある程度の柔軟性が不可欠です。モデルは進化し、アーキテクチャは変化し、精度スキームは改善されています。コツは、ちょうど十分に特化することです——コアパターンをハードワイヤリングしつつ、エッジ部分には適応性を維持することです。
LLM推論とトレーニングの違い(およびチップが活用する点)
推論ワークロードは、専用ハードウェアがターゲットとできるパターンを露呈させます:
- 低精度が支配的 — 8ビット、4ビット、さらには3値または2値演算が推論によく機能する
- メモリがボトルネック — ウェイトとKVキャッシュの移動は、計算よりもはるかに多くの電力を消費する
- レイテンシがスループットよりも重要 — ユーザーは200ms以内にトークンを期待している
- 大規模なリクエスト並列性 — 1チップあたり数千件の並行推論リクエスト
- 予測可能なパターン — Transformer層は高度に構造化されており、ハードワイヤリングが可能
- スパース性の機会 — モデルはますます剪定やMoE(Mixture-of-Experts)技術を使用している
目的構築された推論チップは、これらの前提をハードワイヤリングすることで、汎用GPUと比較してワットあたり10〜50倍優れた性能を実現できます。
LLM最適化推論シリコンを構築している企業
推論ASIC市場は、既存大手、ウェーファ規模の設計、そしてTransformer形状のシリコンに賭けるスタートアップにわたっています:
| 企業 | チップ / プラットフォーム | 専門分野 |
|---|---|---|
| Groq | LPU (Language Processing Unit) | LLM向けの決定論的スループット |
| Etched AI | Sohu ASIC | ハードワイヤされたTransformerエンジン |
| Tenstorrent | Grayskull / Blackhole | 高帯域メッシュを持つ汎用ML |
| Taalas | HC1 (Llama 3.1 8B製品) / HC2ロードマップ | モデル固有の“ハードコア”シリコン;ストレージと計算を融合 |
| OpenAI × Broadcom | Custom Inference Chip | 2026年展開との噂 |
| Intel | Crescent Island | 160GB HBMを備えた推論専用Xe3P GPU |
| Cerebras | Wafer-Scale Engine (WSE-3) | ダイ上の巨大なメモリ帯域幅 |
これらの中の多くは、すでに本番データセンターで稼働しており、スライド資料にとどまりません。d-Matrix、Rain AI、Mythic、Tenetのような小規模なチームもまた、低ビット推論と構造化スパース性に調整されたアーキテクチャを追求しています。
Taalas HC1, Chat Jimmy、および超高速小型モデルサーブ
Taalas は、「ほぼすべてを専門化する」学派の最近の例です。同社は、メモリと計算の境界(オフチップDRAMとオンチップSRAMの対立)が推論のコスト、電力、エンジニアリングの複雑さを支配しており、モデルごとのシリコン(彼らがHardcore Modelsと呼ぶもの)は、デプロイが重みとグラフを固定することに対応する場合に、その境界を崩すことができると主張しています。
同社が初めて出荷する製品であるHC1は、Llama 3.1 8Bのバリアントをハードワイヤしています。この選択は現実的です:モデルは迅速に立ち上げるのに十分小さく、オープンに文書化されており、生の推論深度よりもレイテンシとコストがより重要となる多くの自動化、分類、ドラフティングタスクで依然として有用です。Taalasはこの構成において、1ユーザーあたり16k〜17kデコードトークン/秒のオーダー(ベンダー手法と比較は彼らの執筆物に表示)を報告しており、同じモデルクラスにおいて従来のGPUスタックと比較して資本と電力の大幅な向上を主張しています。初世代部品は積極的な混合低ビットストレージを使用しています。同社は、品質にヘッドルームを取り戻すため、HC2では標準的な4ビット浮動小数形式へ移行していることを説明しています。
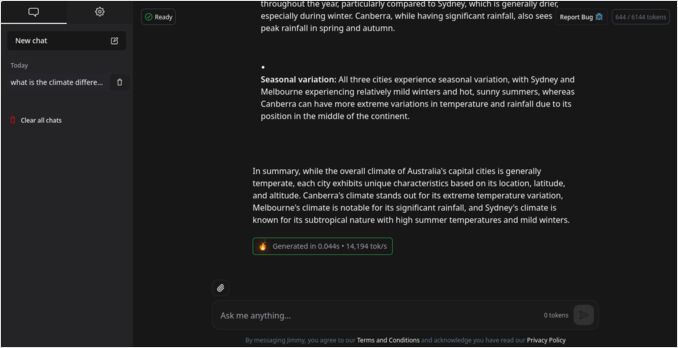
そのスループットクラスが実際に何を意味するかを実感したい開発者のために、Taalasは無料チャットボットデモのChat Jimmyを運営しており、同社のウェブサイト上で申請フォームを通じてAPIアクセスを提供しています。これは明確に概念実証であり、フロンティアアシスタントではありませんが、遅延や高コストに感じる大規模モデルよりも、「人間の認知速度」で動く控えめなモデルを好む現実的なオーディエンスが存在することを示しています。
Transformer推論ASICのアーキテクチャ
Transformer最適化されたチップは、内部では実際にはどのようなものですか?
+--------------------------------------+
|         Host Interface               |
|   (PCIe / CXL / NVLink / Ethernet)   |
+--------------------------------------+
|  On-chip Interconnect (mesh/ring)    |
+--------------------------------------+
|  Compute Tiles / Cores               |
|   — Dense matrix multiply units      |
|   — Low-precision (int8/int4) ALUs   |
|   — Dequant / Activation units       |
+--------------------------------------+
|  On-chip SRAM & KV cache buffers     |
|   — Hot weights, fused caches        |
+--------------------------------------+
|  Quantization / Dequant Pipelines    |
+--------------------------------------+
|  Scheduler / Controller              |
|   — Static graph execution engine    |
+--------------------------------------+
|  Off-chip DRAM / HBM Interface       |
+--------------------------------------+
主なアーキテクチャ機能には以下が含まれます:
- 計算コア — int8, int4, 3値操作のために最適化された密行列積ユニット
- オンチップSRAM — 大きなバッファがホットウェイトとKVキャッシュを保持し、高価なDRAMアクセスを最小限にする
- ストリーミングインターコネクト — メッシュトポロジーが、複数チップにわたる効率的なスケーリングを可能にする
- 量子化エンジン — 層間のリアルタイム量子化/逆量子化
- コンパイラスタック — PyTorch/ONNXグラフを直接、チップ固有のマイクロ操作に変換する
- ハードワイヤされたアテンションカーネル — softmaxなどの操作での制御フローオーバーヘッドを排除する
設計哲学はBitcoin ASICを反映しています:すべてのトランジスタが特定のワークロードに奉仕します。推論が不要とする機能のための無駄なシリコンはありません。
LLM推論におけるGPUとASICのベンチマーク
代表的な公開数値は、同じモデルファミリーにおいて、専用推論ハードウェアが汎用GPUスタックからどのように乖離していくかを示しています(ご自身のワークロードでは常に手法とバッチングの前提を確認してください):
| モデル | ハードウェア | スループット (トークン/s) | 初回トークンまでの時間 | 性能倍率 |
|---|---|---|---|---|
| Llama-2-70B | NVIDIA H100 (8x DGX) | ~80–100 | ~1.7s | ベースライン (1×) |
| Llama-2-70B | Groq LPU | 241–300 | 0.22s | 3–18× 高速 |
| Llama-3.3-70B | Groq LPU | ~276 | ~0.2s | 一貫して 3× |
| Gemma-7B | Groq LPU | 814 | <0.1s | 5–15× 高速 |
| Llama-3.1-8B | Taalas HC1 (ベンダー) | ~16k–17k decode t/s/user | — | 別の軸 (固定8Bグラフ、70Bではない) |
情報源: Groq.com, ArtificialAnalysis.ai, NVIDIA Developer Blog; Taalas HC1の数値は同社の製品投稿からのもの。
Groqに焦点を当てた行は、大規模モデルにおいて高階GPUベースラインと比較して、スループットと初回トークンまでの時間において大きな向上を示しています。Taalasの行は、これらの70B行に対するもう一つの倍率ではなく、モデルとグラフがシリコンに固定された場合、柔軟性を犠牲にして1ユーザーあたりのデコードをどこまで押し上げられるかを示しています。
推論シリコンを専門化する際のトレードオフ
専門化は性能を購入しますが、製品およびエンジニアリングリスクを再導入します:
-
柔軟性と効率。 完全に固定されたASICは、今日のTransformerモデルを素通りしますが、明日のアーキテクチャでは苦労するかもしれません。アテンション機構が進化したり、新しいモデルファミリーが登場したりした場合はどうなるでしょうか? これは仮説ではなく、状態空間モデル、拡散言語モデル、JEPAワールドモデルはすでにモデル側においてTransformerの支配に挑戦しています;これらのアーキテクチャがハードワイヤされたTransformerシリコンに残す可能性がある場所については、LLMのその後をご覧ください。
-
量子化と精度。 低精度は大量の電力を節約しますが、精度劣化の管理には洗練された量子化スキームが必要です。すべてのモデルが4ビット以下に優雅に量子化されるわけではありません。
-
ソフトウェアエコシステム。 堅牢なコンパイラ、カーネル、フレームワークのないハードウェアは無用です。NVIDIAがまだ支配的な地位にあるのは、主にCUDAの成熟したエコシステムのおかげです。新しいチップメーカーはソフトウェアに大きく投資しなければなりません。
-
コストとリスク。 チップのテーパーアウトには数千万ドルから億ドル単位の費用がかかり、12〜24ヶ月かかります。スタートアップにとって、これは成立しないかもしれないアーキテクチャの前提に対する巨大な賭けです。
それでも、ハイパースケールでは、2倍の効率向上であっても数十億ドルの節約に直結します。1秒間に数百万件の推論リクエストを実行しているクラウドプロバイダーにとって、カスタムシリコンはますます妥協できないものになっています。
LLM推論チップのための願望リスト仕様の仕様
| 機能 | 理想的な仕様 |
|---|---|
| プロセス | 3–5nmノード |
| オンチップSRAM | 100MB以上の密結合 |
| 精度 | int8 / int4 / 3値ネイティブサポート |
| スループット | 500+ トークン/秒 (70Bモデル) |
| レイテンシ | <100ms の初回トークンまでの時間 |
| インターコネクト | 低レイテンシメッシュまたは光リンク |
| コンパイラ | PyTorch/ONNX → マイクログコードツールチェーン |
| エネルギー | トークンあたり <0.3 ジュール |
将来展望 (2026–2030)
推論ハードウェアの景況は、3つの粗い層に分化すると予想されます:
-
トレーニングチップ。 NVIDIA B200やAMD Instinct MI400のような高階GPUは、FP16/FP8の柔軟性と巨大なメモリ帯域幅により、トレーニングを引き続き支配し続けるでしょう。
-
推論ASIC。 ハードワイヤされた、低精度のTransformerアクセラレータは、コストと効率に最適化されたハイパースケールでの本番サーブを処理するでしょう。
-
エッジNPU。 小型で超低効率のチップは、量子化されたLLMをスマートフォン、車両、IoTデバイス、ロボットに持ち込み、クラウド依存なしにオンデバイスインテリジェンスを可能にするでしょう。
ハードウェア単独を超えて、私たちは以下を見るでしょう:
- ハイブリッドクラスター — 柔軟なトレーニングのためのGPU、効率的なサーブのためのASIC(またはウェーファ規模推論エンジン)
- 推論-即-サービス (Inference-as-a-Service) — ハイパースケーラーが、第一方アクセラレータ(AWS Inferentia、Google TPU、その他)をGPUと混合する
- ハードウェア–ソフトウェア共設計 — ブロックスパース性、MoEルーティング、量子化フレンドリーな層のために成形されたモデル
- モデルごとまたはファミリーごとのシリコン — Taalasのような企業が、既知のグラフにおいてアーキテクチャの柔軟性を極端なコストとレイテンシのために交換するデプロイがあることに賭けている
- オープンな推論API — シリコンが移植可能でなくても、サーブインターフェースが移植可能であるように保つための圧力
最終的な考え
AI推論の「ASIC化」はすでに進行中です。 Bitcoin採掘がCPUから専用シリコンへと進化したように、AIのデプロイも同じ道を辿っています。
AIの次の革命は、より大きなモデルではなく、より良いチップに関するものになります。Transformer推論の特定のパターンに最適化されたハードウェアが、AIを経済的に大規模にデプロイできる者が誰かを決定します。
Bitcoinマイナーが無駄なワットをすべて最適化して除去したように、推論ハードウェアは最後のFLOP-ジュールを絞り出すでしょう。それが起こったとき、真のブレークスルーはアルゴリズムの中ではなく、それを実行するシリコンの中にあるでしょう。
AIの未来は、1トランジスタずつ、シリコンに刻まれています。
さらに多くのベンチマーク、ハードウェア選択、性能チューニングについては、私たちのLLM性能:ベンチマーク、ボトルネックと最適化ハブをチェックしてください。
有用なリンク
- Groq 公式ベンチマーク
- Taalas — 普遍的AIへの道 (HC1, ロードマップ, 哲学)
- Chat Jimmy — Taalas Llama 3.1 8B デモ
- Taalas APIアクセス申請フォーム
- Artificial Analysis - LLM性能ランキング
- NVIDIA H100 技術ブリーフ
- Etched AI - Transformer ASIC 発表
- Cerebras ウェーファ規模エンジン
- オーストラリアのNVidia RTX 5080およびRTX 5090の価格 - 2025年10月
- LLM性能とPCIeレーン:重要な考慮事項
- 大規模言語モデルの速度テスト
- AIにおけるNVidia GPUの適性比較
- Quadro RTX 5880 Ada 48GBは良いですか?
