
LLM-Leistung im Jahr 2026: Benchmarks, Engpässe und Optimierung
A performance engineering hub for running LLMs efficiently: runtime behavior, bottlenecks, benchmarks, and the real constraints that shape throughput and latency.
Daten und Modelle mit selbst gehosteten LLMs kontrollieren
Das Selbst-Hosting von LLMs hält Daten, Modelle und Inferenzen unter Ihrer Kontrolle – ein praktischer Weg zur AI Sovereignty für Teams, Unternehmen und Nationen.
LLM-Geschwindigkeitstest auf RTX 4080 mit 16 GB VRAM
Das lokale Ausführen großer Sprachmodelle bietet Privatsphäre, Offline-Fähigkeit und null API-Kosten. Dieser Benchmark zeigt genau, was man von 14 populären LLMs auf Ollama auf einer RTX 4080 erwarten kann.
Trendende Go-Repos im Januar 2026
Das Go-Ökosystem floriert weiterhin mit innovativen Projekten, die sich auf KI-Tools, selbstgehostete Anwendungen und Entwicklerinfrastruktur erstrecken. Diese Übersicht analysiert die Top-Trending-Go-Repositories auf GitHub diesen Monat.
Self-gehostete ChatGPT-Alternative für lokale LLMs
[Open WebUI](https://www.glukhov.org/de/llm-hosting/llm-frontends/ „Open WebUI LLM-Oberfläche“) ist eine leistungsstarke, erweiterbare und funktionsreiche, selbst gehostete Web-Oberfläche zur Interaktion mit großen Sprachmodellen.
Echte AUD-Preise von australischen Händlern jetzt verfügbar
Die NVIDIA DGX Spark (GB10 Grace Blackwell) ist in Australien bei großen PC-Händlern mit lokaler Lagerbestellung erhältlich. Wenn Sie die globalen Preise und die Verfügbarkeit des DGX Spark verfolgt haben, werden Sie wissen wollen, dass die Preise in Australien je nach Speicherkonfiguration und Händler zwischen 6.249 und 7.999 AUD liegen.
Cognee mit lokalen LLMs testen – reale Ergebnisse
Cognee ist ein Python-Framework zur Erstellung von Wissensgraphen aus Dokumenten mithilfe von LLMs. Funktioniert es jedoch mit selbstgehosteten Modellen?
Typsichere LLM-Ausgaben mit BAML und Instructor
Bei der Arbeit mit Large Language Models (LLMs) in der Produktion ist es entscheidend, strukturierte und typsichere Outputs zu erhalten. Zwei beliebte Frameworks – BAML und Instructor – verfolgen unterschiedliche Ansätze, um dieses Problem zu lösen.
Gedanken zu LLMs für selbstgehostete Cognee
Die Wahl des Besten LLM für Cognee erfordert das Ausbalancieren von Graph-Qualität, Halluzinationsraten und Hardware-Beschränkungen.
Cognee leistet sich besonders gut mit größeren, niedrig-halluzinierenden Modellen (32B+) über Ollama, doch mittelgroße Optionen sind für leichtere Systeme geeignet.

KI-Suchagenten mit Python und Ollama erstellen
Ollamas Python-Bibliothek umfasst nun native Ollama Websuche-Funktionen. Mit nur wenigen Zeilen Code können Sie Ihre lokalen LLMs mit Echtzeitinformationen aus dem Web ergänzen, was Halluzinationen reduziert und die Genauigkeit verbessert.
KI-Suchagenten mit Go und Ollama erstellen
Mit der Websuche-API von Ollama können Sie lokale LLMs mit Echtzeit-Webinformationen anreichern. Dieser Leitfaden zeigt Ihnen, wie Sie Websuchefunktionen in Go umsetzen, von einfachen API-Aufrufen bis hin zu vollausgestatteten Such-Agenten.
Vergleichen Sie die besten Tools für das lokale Hosten von LLMs im Jahr 2026. Reife der API, Hardware-Support, Tool-Calling und reale Anwendungsfälle.
Das lokale Ausführen von LLMs ist nun auch für Entwickler, Startups und sogar Enterprise-Teams praktikabel.
Doch die Wahl des richtigen Tools – Ollama, vLLM, LM Studio, LocalAI oder andere – hängt von Ihren Zielen ab:
Bereitstellung von Enterprise-KI auf kostengünstiger Hardware mit Open-Modellen
Die Demokratisierung der KI ist da. Mit Open-Source-LLMs wie Llama, Mistral und Qwen, die nun proprietäre Modelle herausfordern, können Teams eine leistungsstarke KI-Infrastruktur mit Consumer-Hardware aufbauen – und dabei die Kosten drastisch senken, während sie die vollständige Kontrolle über Datenschutz und Bereitstellung behalten.
GPT-OSS 120b Benchmarks auf drei AI-Plattformen
Ich habe einige interessante Leistungsbenchmarks von GPT-OSS 120b gefunden, die auf Ollama unter drei verschiedenen Plattformen durchgeführt wurden: NVIDIA DGX Spark, Mac Studio und RTX 4080. Der GPT-OSS 120b-Modell aus der Ollama-Bibliothek wiegt 65 GB, was bedeutet, dass er nicht in die 16 GB VRAM des RTX 4080 (oder der neueren RTX 5080) passt.
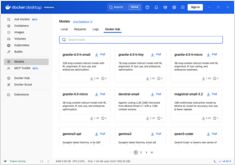
Vergleichen Sie Docker Model Runner und Ollama für lokale LLM
Große Sprachmodelle (LLMs) lokal ausführen wird zunehmend beliebt, um den Schutz der Privatsphäre, den Kostenkontroll und die Offline-Fähigkeiten zu gewährleisten. Der Markt hat sich im April 2025 deutlich verändert, als Docker Docker Model Runner (DMR) eingeführt hat, seine offizielle Lösung zur Bereitstellung von KI-Modellen.
Ollama mit Go integrieren: SDK-Leitfaden, Beispiele und Best Practices für den Produktiveinsatz.
Dieser Leitfaden bietet einen umfassenden Überblick über die verfügbaren Go-SDKs für Ollama und vergleicht deren Funktionsumfang.