
Docker Model Runner: Kontextgrößen-Konfigurationsleitfaden
„Kontextgrößen im Docker Model Runner konfigurieren mit Umgehungsmöglichkeiten“
Einrichten von Kontextgrößen im Docker Model Runner ist komplexer, als es sein sollte.
„Kontextgrößen im Docker Model Runner konfigurieren mit Umgehungsmöglichkeiten“
Einrichten von Kontextgrößen im Docker Model Runner ist komplexer, als es sein sollte.
KI-Modell zur Erweiterung von Bildern mit Textanweisungen
Black Forest Labs hat FLUX.1-Kontext-dev veröffentlicht, ein fortschrittliches Bild-zu-Bild-KI-Modell, das bestehende Bilder mithilfe von Textanweisungen erweitert.
GPU-Beschleunigung für Docker Model Runner mit NVIDIA CUDA-Unterstützung aktivieren
Docker Model Runner ist das offizielle Tool von Docker, um KI-Modelle lokal zu verwenden, aber GPU-Beschleunigung mit NVidia in Docker Model Runner erfordert eine spezifische Konfiguration.
LLM-Kosten um 80 % senken: Intelligente Token-Optimierung
Tokenoptimierung ist die entscheidende Fähigkeit, die kosteneffiziente LLM-Anwendungen von budgetzehrenden Experimenten unterscheidet.
GPT-OSS 120b Benchmarks auf drei AI-Plattformen
Ich habe einige interessante Leistungsbenchmarks von GPT-OSS 120b gefunden, die auf Ollama unter drei verschiedenen Plattformen durchgeführt wurden: NVIDIA DGX Spark, Mac Studio und RTX 4080. Der GPT-OSS 120b-Modell aus der Ollama-Bibliothek wiegt 65 GB, was bedeutet, dass er nicht in die 16 GB VRAM des RTX 4080 (oder der neueren RTX 5080) passt.
Bauen Sie MCP-Server für KI-Assistenten mit Python-Beispielen
Das Model Context Protocol (MCP) revolutioniert die Art und Weise, wie KI-Assistenten mit externen Datenquellen und Tools interagieren. In diesem Leitfaden erkunden wir, wie man MCP-Server in Python aufbaut, mit Beispielen, die sich auf Websuche und Scraping-Funktionen konzentrieren.
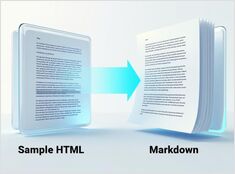
Python zum Konvertieren von HTML in sauberen, LLM-fertigen Markdown
HTML in Markdown konvertieren ist eine grundlegende Aufgabe in modernen Entwicklungsworkflows, insbesondere wenn Webinhalte für Large Language Models (LLMs), Dokumentationssysteme oder statische Seiten-Generatoren wie Hugo vorbereitet werden. Dieser Leitfaden ist Teil unseres Dokumentations-Tools 2026: Markdown, LaTeX, PDF & Druckworkflows Hubs.
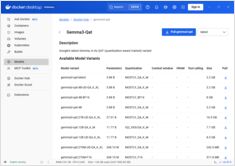
Schnellreferenz für Docker Model Runner-Befehle
Docker Model Runner (DMR) ist Docks offizielle Lösung zur lokalen Ausführung von KI-Modellen, eingeführt im April 2025. Dieses Cheat Sheet bietet eine schnelle Referenz für alle wesentlichen Befehle, Konfigurationen und Best Practices.
Vergleichen Sie Docker Model Runner und Ollama für lokale LLM
Große Sprachmodelle (LLMs) lokal ausführen wird zunehmend beliebt, um den Schutz der Privatsphäre, den Kostenkontroll und die Offline-Fähigkeiten zu gewährleisten. Der Markt hat sich im April 2025 deutlich verändert, als Docker Docker Model Runner (DMR) eingeführt hat, seine offizielle Lösung zur Bereitstellung von KI-Modellen.
ASICs und maßgeschneiderte Silizium-Chips erhöhen Geschwindigkeit und Effizienz der LLM-Inferenz
Die Zukunft der KI dreht sich nicht nur um intelligenter werdende Modelle. Sie bezieht sich auch auf Silizium-Verarbeitung, die genau dazu passt, wie diese Modelle tatsächlich bereitgestellt werden. Spezialisierte Hardware für LLM-Inferenz folgt dabei einem Weg, der an den Übergang des Bitcoin-Mining von GPUs zu speziell dafür entwickelten ASICs erinnert – allerdings mit strengeren Einschränkungen, da sich Modelle und Präzisionsverfahren ständig weiterentwickeln.
Verfügbarkeit, reale Einzelhandelspreise in sechs Ländern und Vergleich mit dem Mac Studio.
NVIDIA DGX Spark ist real, ist am 15. Oktober 2025 im Verkauf und richtet sich an CUDA-Entwickler, die lokale LLM-Arbeit mit einem integrierten NVIDIA AI-Stack benötigen. Der US-Empfehlungspreis beträgt 3.999 USD; der Einzelhandelspreis in GB/DE/JP ist aufgrund von Mehrwertsteuer und Vertriebswegen höher. Öffentliche Etikettenpreise in AUD/KRW sind noch nicht weitgehend verfügbar.
Vergleich von Geschwindigkeit, Parametern und Leistung dieser beiden Modelle
Hier ist ein Vergleich zwischen Qwen3:30b und GPT-OSS:20b, der sich auf die Befolgung von Anweisungen sowie Leistungsparameter, Spezifikationen und Geschwindigkeit konzentriert.
+ Konkrete Beispiele mit dem Einsatz von Think-LLMs
In diesem Beitrag untersuchen wir zwei Möglichkeiten, Ihre Python-Anwendung mit Ollama zu verbinden: 1. Über die HTTP REST API; 2. Über die offizielle Ollama Python-Bibliothek.
Nicht sehr nett.
Ollama’s GPT-OSS-Modelle haben wiederkehrende Probleme bei der Verarbeitung strukturierter Ausgaben, insbesondere wenn sie mit Frameworks wie LangChain, OpenAI SDK, vllm und anderen verwendet werden.
Slight unterschiedliche APIs erfordern einen speziellen Ansatz.
Hier ist ein detaillierter Vergleich der Unterstützung für strukturierte Ausgabe (das Zurückgeben zuverlässiger JSON-Daten) bei populären LLM-Anbietern.
Mehrere Möglichkeiten, strukturierte Ausgaben von Ollama zu erhalten
Große Sprachmodelle (LLMs) sind leistungsfähig, aber in der Produktion wollen wir selten freie Textabsätze. Stattdessen wünschen wir uns vorhersehbare Daten: Attribute, Fakten oder strukturierte Objekte, die wir in eine App einfließen lassen können. Dafür gibt es Strukturierte Ausgabe von LLMs.