
LLMs mit strukturierten Ausgaben einschränken: Ollama, Qwen3 und Python oder Go
Mehrere Möglichkeiten, strukturierte Ausgaben von Ollama zu erhalten
Große Sprachmodelle (LLMs) sind leistungsfähig, aber in der Produktion wollen wir selten freie Textabsätze. Stattdessen wünschen wir uns vorhersehbare Daten: Attribute, Fakten oder strukturierte Objekte, die wir in eine App einfließen lassen können. Dafür gibt es Strukturierte Ausgabe von LLMs.
Schema-Einhaltung reduziert die Häufigkeit, mit der schlechte Logits zu ungültigem JSON werden, aber Temperatur und Strafen sind nach wie vor relevant für Wiederholungsstürme; siehe Agentische Inferenzparameter für Qwen und Gemma wenn Sie format-Einschränkungen mit Agenten kombinieren.
Die Service-Schicht benötigt weiterhin Parse-Normalisieren-Validieren-Logik—siehe Strukturierte LLM-Ausgabe-Validierung in Python, die Stand hält—weil Ollama und Clients sich auf exakte Strings einigen können müssen, selbst wenn format festgelegt ist.
Vor einiger Zeit hat Ollama die Unterstützung für strukturierte Ausgabe eingeführt (Ankündigung), wodurch es möglich wird, die Antworten eines Modells so einzuschränken, dass sie einem JSON-Schema entsprechen. Dies eröffnet konsistente Datenextraktions-Pipelines für Aufgaben wie die Katalogisierung von LLM-Funktionen, das Benchmarken von Modellen oder die Automatisierung der Systemintegration.
In diesem Beitrag behandeln wir:
- Was strukturierte Ausgabe ist und warum sie wichtig ist
- Ein einfacher Weg, strukturierte Ausgabe von LLMs zu erhalten
- Wie die neue Funktion von Ollama funktioniert
- Beispiele für die Extraktion von LLM-Fähigkeiten:
Was ist strukturierte Ausgabe?
Normalerweise generieren LLMs freien Text:
„Modell X unterstützt Reasoning mit Chain-of-Thought, hat ein Kontextfenster von 200K und spricht Englisch, Chinesisch und Spanisch.“
Das ist lesbar, aber schwierig zu parsen.
Stattdessen verlangen wir mit strukturiertem Output ein strenges Schema:
{
  "name": "Model X",
  "supports_thinking": true,
  "max_context_tokens": 200000,
  "languages": ["English", "Chinese", "Spanish"]
}
Dieses JSON ist leicht zu validieren, in einer Datenbank zu speichern oder an eine UI zu übergeben.
Einfacher Weg, strukturierte Ausgabe von LLMs zu erhalten
LLMs verstehen manchmal, was das Schema ist, und wir können das LLM bitten, die Ausgabe in JSON mit einem bestimmten Schema zurückzugeben. Das Modell Qwen3 von Alibaba ist für Reasoning und strukturierte Antworten optimiert. Man kann es explizist anweisen, in JSON zu antworten.
Beispiel 1: Verwenden von Qwen3 mit ollama in Python, Anforderung von JSON mit Schema
import json
import ollama

prompt = """
You are a structured data extractor.
Return JSON only.
Text: "Elon Musk is 53 and lives in Austin."
Schema: { "name": string, "age": int, "city": string }
"""

response = ollama.chat(model="qwen3", messages=[{"role": "user", "content": prompt}])
output = response['message']['content']

# Parse JSON
try:
    data = json.loads(output)
    print(data)
except Exception as e:
    print("Error parsing JSON:", e)
Ausgabe:
{"name": "Elon Musk", "age": 53, "city": "Austin"}
Erzwingen der Schema-Validierung mit Pydantic
Um fehlerhafte Ausgaben zu vermeiden, können Sie gegen ein Pydantic-Schema in Python validieren.
from pydantic import BaseModel

class Person(BaseModel):
    name: str
    age: int
    city: str

# Suppose 'output' is the JSON string from Qwen3
data = Person.model_validate_json(output)
print(data.name, data.age, data.city)
Dies stellt sicher, dass die Ausgabe der erwarteten Struktur entspricht.
Ollamas strukturierte Ausgabe
Mit Ollama können Sie nun ein Schema über den format-Parameter übergeben. Das Modell ist dann darauf eingeschränkt, nur in JSON zu antworten, das dem Schema entspricht (Dokumentation).
In Python definieren Sie Ihr Schema typischerweise mit Pydantic und lassen Ollama dies als JSON-Schema verwenden.
Beispiel 2: Extrahieren von LLM-Funktionsmetadaten
Angenommen, Sie haben ein Textsnippets, das die Fähigkeiten eines LLMs beschreibt:
„Qwen3 hat starke multilinguale Unterstützung (Englisch, Chinesisch, Französisch, Spanisch, Arabisch). Es erlaubt Reasoning-Schritte (Chain-of-Thought). Das Kontextfenster beträgt 128K Tokens.“
Sie wollen strukturierte Daten:
from pydantic import BaseModel
from typing import List
from ollama import chat

class LLMFeatures(BaseModel):
    name: str
    supports_thinking: bool
    max_context_tokens: int
    languages: List[str]

prompt = """
Analyze the following description and return the model’s features in JSON only.
Model description:
'Qwen3 has strong multilingual support (English, Chinese, French, Spanish, Arabic).
It allows reasoning steps (chain-of-thought).
The context window is 128K tokens.'
"""

resp = chat(
    model="qwen3",
    messages=[{"role": "user", "content": prompt}],
    format=LLMFeatures.model_json_schema(),
    options={"temperature": 0},
)

print(resp.message.content)
Mögliche Ausgabe:
{
  "name": "Qwen3",
  "supports_thinking": true,
  "max_context_tokens": 128000,
  "languages": ["English", "Chinese", "French", "Spanish", "Arabic"]
}
Beispiel 3: Mehrere Modelle vergleichen
Geben Sie Beschreibungen mehrerer Modelle ein und extrahieren Sie sie in strukturierte Form:
from typing import List

class ModelComparison(BaseModel):
    models: List[LLMFeatures]

prompt = """
Extract features of each model into JSON.

1. Llama 3.1 supports reasoning. Context window is 128K. Languages: English only.
2. GPT-4 Turbo supports reasoning. Context window is 128K. Languages: English, Japanese.
3. Qwen3 supports reasoning. Context window is 128K. Languages: English, Chinese, French, Spanish, Arabic.
"""

resp = chat(
    model="qwen3",
    messages=[{"role": "user", "content": prompt}],
    format=ModelComparison.model_json_schema(),
    options={"temperature": 0},
)

print(resp.message.content)
Ausgabe:
{
  "models": [
    {
      "name": "Llama 3.1",
      "supports_thinking": true,
      "max_context_tokens": 128000,
      "languages": ["English"]
    },
    {
      "name": "GPT-4 Turbo",
      "supports_thinking": true,
      "max_context_tokens": 128000,
      "languages": ["English", "Japanese"]
    },
    {
      "name": "Qwen3",
      "supports_thinking": true,
      "max_context_tokens": 128000,
      "languages": ["English", "Chinese", "French", "Spanish", "Arabic"]
    }
  ]
}
Damit wird es trivial, Modelle nach ihren Funktionen zu benchmarken, zu visualisieren oder zu filtern.
Beispiel 4: Lücken automatisch erkennen
Sie können sogar null-Werte zulassen, wenn ein Feld fehlt:
from typing import Optional

class FlexibleLLMFeatures(BaseModel):
    name: str
    supports_thinking: Optional[bool]
    max_context_tokens: Optional[int]
    languages: Optional[List[str]]
Dies stellt sicher, dass Ihr Schema auch dann gültig bleibt, wenn einige Informationen unbekannt sind.
Vorteile, Tücken & Best Practices
Die Verwendung von strukturiertem Output über Ollama (oder jedes System, das dies unterstützt) bietet viele Vorteile — hat aber auch einige Tücken.
Vorteile
- Stärkere Garantien: Das Modell wird gebeten, einem JSON-Schema zu entsprechen, statt frei formatiertem Text.
- Leichteres Parsen: Sie können direkt
json.loadsaufrufen oder mit Pydantic / Zod validieren, anstatt Regex oder Heuristiken zu verwenden. - Schema-basierte Evolution: Sie können Ihr Schema versionieren, Felder hinzufügen (mit Standardwerten) und die Abwärtskompatibilität aufrechterhalten.
- Interoperabilität: Nachgelagerte Systeme erwarten strukturierte Daten.
- Determinismus (besser bei niedriger Temperatur): Wenn die Temperatur niedrig ist (z. B. 0), wird das Modell eher rigide beim Schema bleiben. In Ollamas Dokumentation wird dies empfohlen.
Tücken & Fallstricke
- Schema-Mismatch: Das Modell könnte sich immer noch ablenken—z. B. eine erforderliche Eigenschaft verfehlen, Schlüssel neu anordnen oder zusätzliche Felder einfügen. Sie benötigen Validierung.
- Komplexe Schemata: Sehr tiefe oder rekursive JSON-Schemata könnten das Modell verwirren oder zu Fehlern führen.
- Mehrdeutigkeit im Prompt: Wenn Ihr Prompt vage ist, könnte das Modell Felder oder Einheiten falsch raten.
- Inkonsistenz zwischen Modellen: Einige Modelle könnten besser oder schlechter darin sein, strukturierte Einschränkungen zu respektieren.
- Token-Limits: Das Schema selbst fügt Kosten für Tokens im Prompt oder API-Call hinzu.
Best Practices & Tipps (aus Ollamas Blog + Erfahrung)
- Verwenden Sie Pydantic (Python) oder Zod (JavaScript), um Ihre Schemata zu definieren und JSON-Schemata automatisch zu generieren. Dies vermeidet manuelle Fehler.
- Schließen Sie immer Anweisungen wie „nur in JSON antworten“ oder „keine Kommentare oder zusätzlichen Text einfügen“ in Ihren Prompt ein.
- Verwenden Sie temperature = 0 (oder sehr niedrig), um Zufälligkeit zu minimieren und die Schemata-Dienstreue zu maximieren. Ollama empfiehlt Determinismus.
- Validieren Sie und fassen Sie ggf. auf (z. B. Retry oder Aufräumen), wenn das Parsen von JSON fehlschlägt oder die Schema-Validierung fehlschlägt.
- Beginnen Sie mit einem einfacheren Schema und erweitern Sie es schrittweise. Überkomplexifizieren Sie anfangs nicht.
- Nehmen Sie hilfreiche, aber eingeschränkte Fehleranweisungen auf: z. B. Wenn das Modell ein erforderliches Feld nicht ausfüllen kann, antworte mit
nullstatt es zu verschweigen (wenn Ihr Schema dies zulässt).
Go-Beispiel 1: Extrahieren von LLM-Funktionen
Hier ist ein einfaches Go-Programm, das Qwen3 nach strukturiertem Output über die Funktionen eines LLMs fragt.
package main

import (
	"context"
	"encoding/json"
	"fmt"
	"log"

	"github.com/ollama/ollama/api"
)

type LLMFeatures struct {
	Name             string   `json:"name"`
	SupportsThinking bool     `json:"supports_thinking"`
	MaxContextTokens int      `json:"max_context_tokens"`
	Languages        []string `json:"languages"`
}

func main() {
	client, err := api.ClientFromEnvironment()
	if err != nil {
		log.Fatal(err)
	}

	prompt := `
  Analyze the following description and return the model’s features in JSON only.
  Description:
  "Qwen3 has strong multilingual support (English, Chinese, French, Spanish, Arabic).
  It allows reasoning steps (chain-of-thought).
  The context window is 128K tokens."
  `

	// Define the JSON schema for structured output
	formatSchema := map[string]any{
		"type": "object",
		"properties": map[string]any{
			"name": map[string]string{
				"type": "string",
			},
			"supports_thinking": map[string]string{
				"type": "boolean",
			},
			"max_context_tokens": map[string]string{
				"type": "integer",
			},
			"languages": map[string]any{
				"type": "array",
				"items": map[string]string{
					"type": "string",
				},
			},
		},
		"required": []string{"name", "supports_thinking", "max_context_tokens", "languages"},
	}

	// Convert schema to JSON
	formatJSON, err := json.Marshal(formatSchema)
	if err != nil {
		log.Fatal("Failed to marshal format schema:", err)
	}

	req := &api.GenerateRequest{
		Model:   "qwen3:8b",
		Prompt:  prompt,
		Format:  formatJSON,
		Options: map[string]any{"temperature": 0},
	}

	var features LLMFeatures
	var rawResponse string
	err = client.Generate(context.Background(), req, func(response api.GenerateResponse) error {
		// Accumulate content as it streams
		rawResponse += response.Response

		// Only parse when the response is complete
		if response.Done {
			if err := json.Unmarshal([]byte(rawResponse), &features); err != nil {
				return fmt.Errorf("JSON parse error: %v", err)
			}
		}
		return nil
	})
	if err != nil {
		log.Fatal(err)
	}

	fmt.Printf("Parsed struct: %+v\n", features)
}
Um dieses Go-Beispielprogramm zu kompilieren und auszuführen—angenommen, wir haben diese main.go-Datei in einem Ordner ollama-struct,
müssen wir in diesem Ordner ausführen:
# initialise module
go mod init ollama-struct
# pull all the dependencise
go mod tidy
# build & execute
go build -o ollama-struct main.go
./ollama-struct
Beispiel-Ausgabe
Parsed struct: {Name:Qwen3 SupportsThinking:true MaxContextTokens:128000 Languages:[English Chinese French Spanish Arabic]}
Go-Beispiel 2: Mehrere Modelle vergleichen
Sie können dies erweitern, um eine Liste von Modellen für den Vergleich zu extrahieren.
  type ModelComparison struct {
		Models []LLMFeatures `json:"models"`
	}

	prompt = `
	Extract features from the following model descriptions and return as JSON:

	1. PaLM 2: This model has limited reasoning capabilities and focuses on basic language understanding. It supports a context window of 8,000 tokens. It primarily supports English language only.
	2. LLaMA 2: This model has moderate reasoning abilities and can handle some logical tasks. It can process up to 4,000 tokens in its context. It supports English, Spanish, and Italian languages.
	3. Codex: This model has strong reasoning capabilities specifically for programming and code analysis. It has a context window of 16,000 tokens. It supports English, Python, JavaScript, and Java languages.

	Return a JSON object with a "models" array containing all models.
	`

	// Define the JSON schema for model comparison
	comparisonSchema := map[string]any{
		"type": "object",
		"properties": map[string]any{
			"models": map[string]any{
				"type": "array",
				"items": map[string]any{
					"type": "object",
					"properties": map[string]any{
						"name": map[string]string{
							"type": "string",
						},
						"supports_thinking": map[string]string{
							"type": "boolean",
						},
						"max_context_tokens": map[string]string{
							"type": "integer",
						},
						"languages": map[string]any{
							"type": "array",
							"items": map[string]string{
								"type": "string",
							},
						},
					},
					"required": []string{"name", "supports_thinking", "max_context_tokens", "languages"},
				},
			},
		},
		"required": []string{"models"},
	}

	// Convert schema to JSON
	comparisonFormatJSON, err := json.Marshal(comparisonSchema)
	if err != nil {
		log.Fatal("Failed to marshal comparison schema:", err)
	}

	req = &api.GenerateRequest{
		Model:   "qwen3:8b",
		Prompt:  prompt,
		Format:  comparisonFormatJSON,
		Options: map[string]any{"temperature": 0},
	}

	var comp ModelComparison
	var comparisonResponse string
	err = client.Generate(context.Background(), req, func(response api.GenerateResponse) error {
		// Accumulate content as it streams
		comparisonResponse += response.Response

		// Only parse when the response is complete
		if response.Done {
			if err := json.Unmarshal([]byte(comparisonResponse), &comp); err != nil {
				return fmt.Errorf("JSON parse error: %v", err)
			}
		}
		return nil
	})
	if err != nil {
		log.Fatal(err)
	}

	for _, m := range comp.Models {
		fmt.Printf("%s: Context=%d, Languages=%v\n", m.Name, m.MaxContextTokens, m.Languages)
	}
Beispiel-Ausgabe
PaLM 2: Context=8000, Languages=[English]
LLaMA 2: Context=4000, Languages=[English Spanish Italian]
Codex: Context=16000, Languages=[English Python JavaScript Java]
Übrigens funktioniert qwen3:4b bei diesen Beispielen gut, genauso wie qwen3:8b.
Best Practices für Go-Entwickler
- Temperatur auf 0 setzen für maximale Schemata-Dienstreue.
- Mit
json.Unmarshalvalidieren und auf eine Fallback-Lösung zurückgreifen, wenn das Parsen fehlschlägt. - Schemata einfach halten — tief verschachtelte oder rekursive JSON-Strukturen können Probleme verursachen.
- Optionale Felder zulassen (verwenden Sie
omitemptyin Go-Struktur-Tags), wenn fehlende Daten erwartet werden. - Retries hinzufügen, wenn das Modell gelegentlich ungültiges JSON ausgibt.
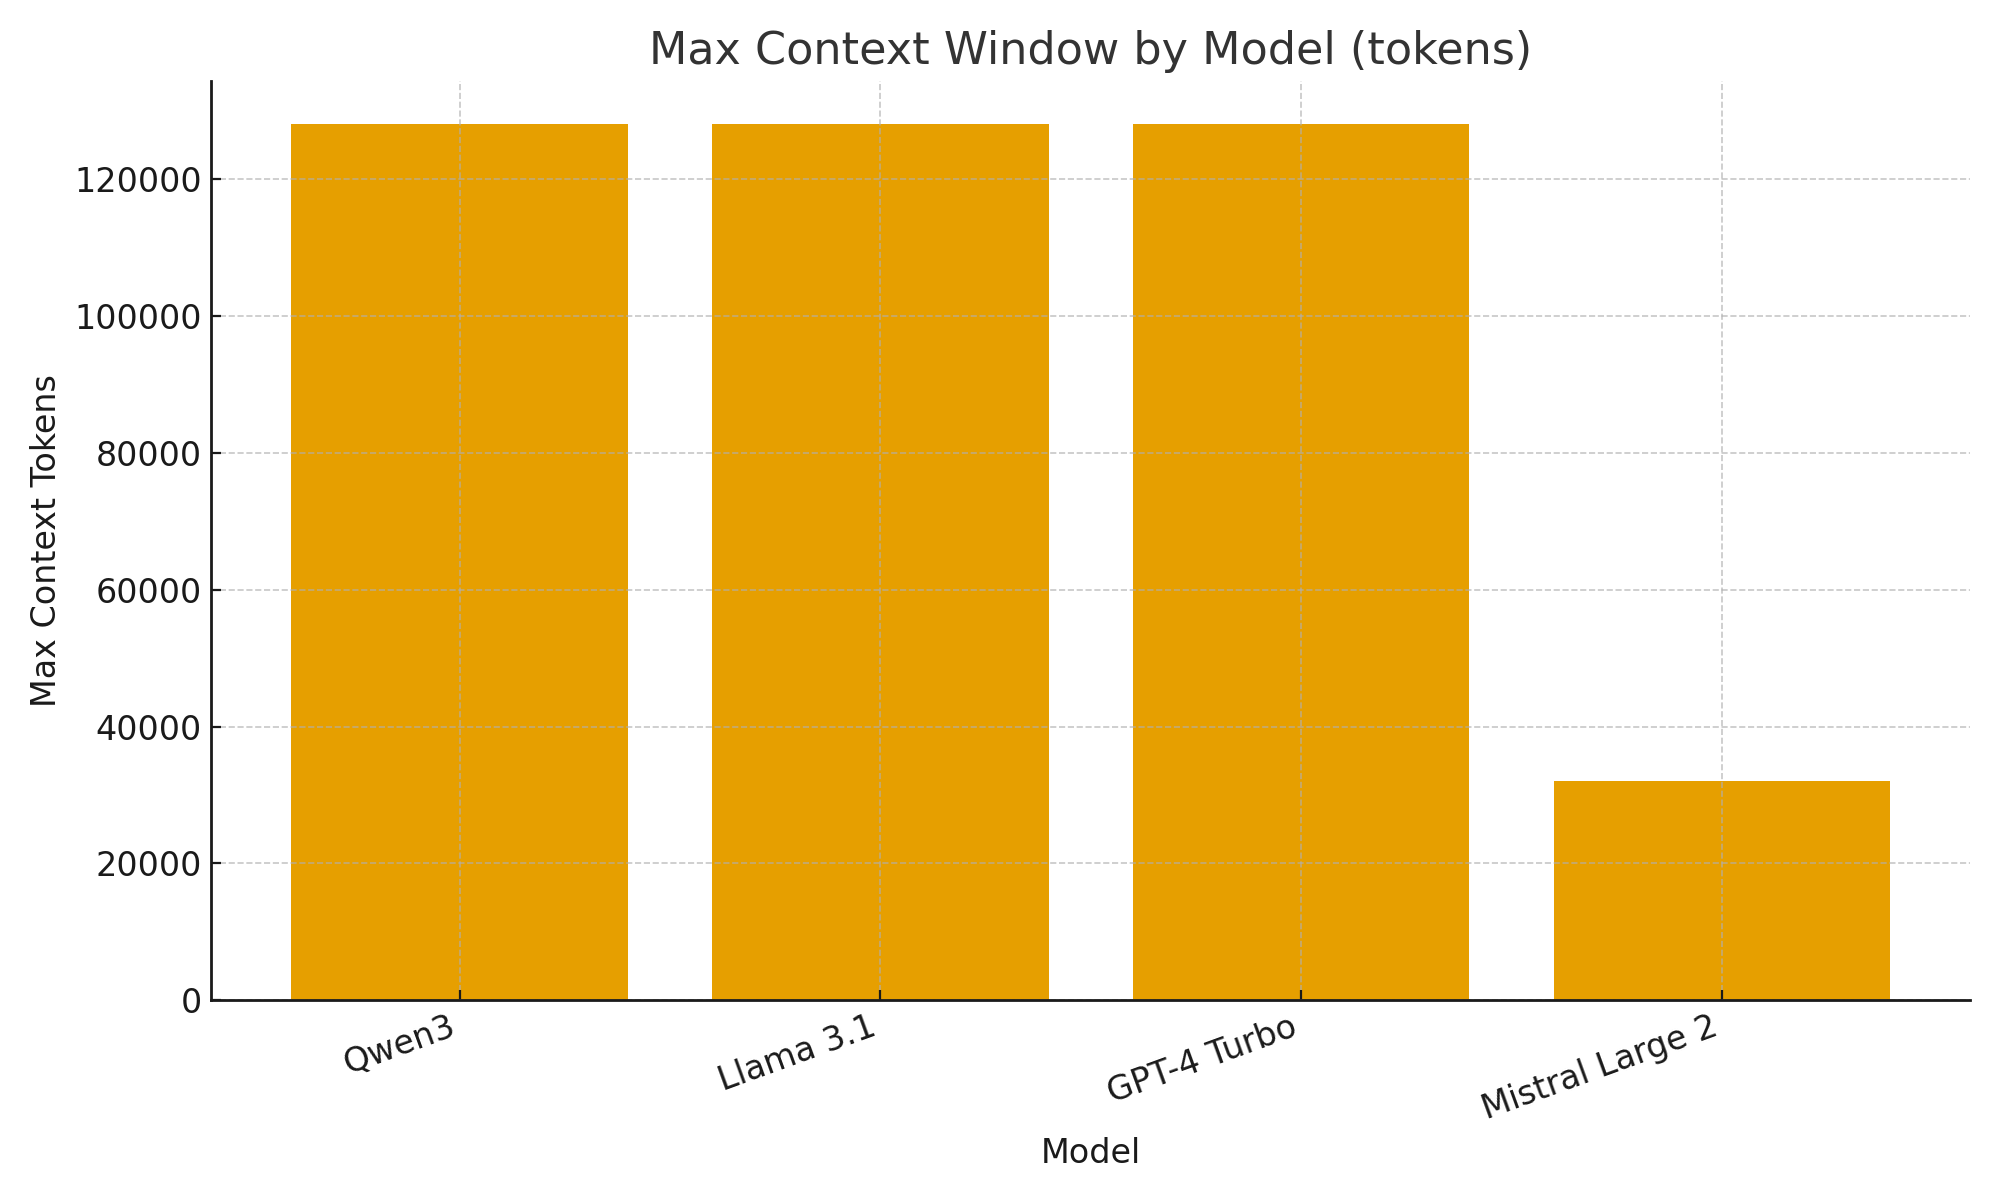
Komplettes Beispiel — Zeichnen eines Diagramms mit LLM-Spezifikationen (Schritt für Schritt: von strukturiertem JSON zu Vergleichstabellen)
- Definieren Sie ein Schema für die Daten, die Sie wünschen
Verwenden Sie Pydantic, damit Sie sowohl (a) ein JSON-Schema für Ollama generieren als auch (b) die Antwort des Modells validieren können.
from pydantic import BaseModel
from typing import List, Optional

class LLMFeatures(BaseModel):
    name: str
    supports_thinking: bool
    max_context_tokens: int
    languages: List[str]
- Bitten Sie Ollama, nur JSON in dieser Form zurückzugeben
Übergeben Sie das Schema über format= und senken Sie die Temperatur für Determinismus.
from ollama import chat

prompt = """
Extract features for each model. Return JSON only matching the schema.
1) Qwen3 supports chain-of-thought; 128K context; English, Chinese, French, Spanish, Arabic.
2) Llama 3.1 supports chain-of-thought; 128K context; English.
3) GPT-4 Turbo supports chain-of-thought; 128K context; English, Japanese.
"""

resp = chat(
    model="qwen3",
    messages=[{"role": "user", "content": prompt}],
    format={"type": "array", "items": LLMFeatures.model_json_schema()},
    options={"temperature": 0}
)

raw_json = resp.message.content  # JSON list of LLMFeatures
- Validieren & normalisieren
Validieren Sie immer, bevor Sie es in der Produktion verwenden.
from pydantic import TypeAdapter

adapter = TypeAdapter(list[LLMFeatures])
models = adapter.validate_json(raw_json)  # -> list[LLMFeatures]
- Eine Vergleichstabelle erstellen (pandas)
Wandeln Sie Ihre validierten Objekte in einen DataFrame um, den Sie sortieren/filtern und exportieren können.
import pandas as pd

df = pd.DataFrame([m.model_dump() for m in models])
df["languages_count"] = df["languages"].apply(len)
df["languages"] = df["languages"].apply(lambda xs: ", ".join(xs))

# Reorder columns for readability
df = df[["name", "supports_thinking", "max_context_tokens", "languages_count", "languages"]]

# Save as CSV for further use
df.to_csv("llm_feature_comparison.csv", index=False)
- (Optional) Schnelle Visualisierungen
Einfache Diagramme helfen Ihnen, Unterschiede zwischen Modellen schnell auf einen Blick zu sehen.
import matplotlib.pyplot as plt

plt.figure()
plt.bar(df["name"], df["max_context_tokens"])
plt.title("Max Context Window by Model (tokens)")
plt.xlabel("Model")
plt.ylabel("Max Context Tokens")
plt.xticks(rotation=20, ha="right")
plt.tight_layout()
plt.savefig("max_context_window.png")
TL;DR
Mit Ollamas neuer Unterstützung für strukturierte Ausgabe können Sie LLMs nicht nur als Chatbots, sondern als Datenextraktions-Engines behandeln.
Die obigen Beispiele zeigten, wie man strukturierte Metadaten über LLM-Funktionen wie Thinking-Unterstützung, Kontextfenstergröße und unterstützte Sprachen automatisch extrahiert — Aufgaben, die andernfalls ein empfindliches Parsen erfordern würden.
Ob Sie einen LLM-Modellkatalog, ein Evaluierungs-Dashboard oder einen KI-gestützten Forschungsassistenten bauen: Strukturierte Ausgaben machen die Integration reibungslos, zuverlässig und produktionsreif.
