Llm

Ollama-Enshittification – Die ersten Anzeichen

Ollama-Enshittification – Die ersten Anzeichen

Meine Sicht auf den aktuellen Entwicklungsstand von Ollama

Ollama ist schnell zu einem der beliebtesten Tools für den lokalen Betrieb von LLMs geworden. Sein einfaches CLI und das durchdachte Modell-Management haben es zu einer ersten Wahl für Entwickler gemacht, die mit KI-Modellen außerhalb der Cloud arbeiten möchten.

Chat-Oberflächen für lokale Ollama-Instanzen

Chat-Oberflächen für lokale Ollama-Instanzen

Schneller Überblick über die wichtigsten UIs für Ollama im Jahr 2025

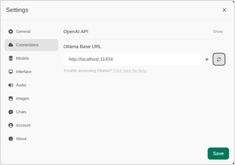
Locally gehostete Ollama ermöglicht es, große Sprachmodelle auf Ihrem eigenen Gerät auszuführen, aber die Verwendung über die Befehlszeile ist nicht benutzerfreundlich. Hier sind mehrere Open-Source-Projekte, die ChatGPT-ähnliche Schnittstellen bereitstellen, die mit einer lokalen Ollama verbunden sind.

Suche vs. Deep Search vs. Deep Research in 2026

Suche vs. Deep Search vs. Deep Research in 2026

Welcher KI-Forschungsmodus passt zu Ihrer Aufgabe?

  • Suche eignet sich am besten für die schnelle, unkomplizierte Informationssuche anhand von Schlüsselwörtern.
  • Deep Search exceliert darin, Kontext und Absicht zu verstehen, und liefert relevantere und umfassendere Ergebnisse für komplexe Abfragen.
Cloud-LLM-Anbieter

Cloud-LLM-Anbieter

Kurze Liste von LLM-Anbietern

Die Verwendung von LLMs ist nicht sehr teuer, es könnte kein Bedarf bestehen, neue, unglaublich leistungsstarke GPUs zu kaufen.
Hier ist eine Liste der LLM-Anbieter in der Cloud mit den LLMs, die sie hosten.

Test: Wie Ollama die Intel CPU Performance und Efficient Cores verwendet

Test: Wie Ollama die Intel CPU Performance und Efficient Cores verwendet

Ollama auf Intel CPU: Effiziente vs. Leistungscores

Ich habe eine Theorie, die ich testen möchte – wenn man alle Kerne eines Intel-Prozessors nutzt, würde das die Geschwindigkeit von LLMs erhöhen? Test: Wie Ollama die Leistung des Intel-Prozessors und der effizienten Kerne nutzt

Es nervt mich, dass das neue Gemma3-Modell mit 27 Bit (gemma3:27b, 17 GB auf Ollama) nicht in die 16 GB VRAM meines GPUs passt und teilweise auf dem CPU läuft.