Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.
Управляйте данными и моделями с помощью развернутых локально LLM
Хостинг больших языковых моделей (LLM) на собственных серверах обеспечивает контроль над данными, моделями и процессом инференса — это практический путь к суверенному искусственному интеллекту для команд, предприятий и целых стран.
Локальный запуск больших языковых моделей обеспечивает конфиденциальность, работу в автономном режиме и отсутствие затрат на API.
Данный бенчмарк точно показывает, чего можно ожидать от 14 популярных
LLM на Ollama на видеокарте RTX 4080.
Экосистема Go продолжает процветать с инновационными проектами, охватывающими инструменты ИИ, самоуправляемые приложения и инфраструктуру разработчиков. Этот обзор анализирует самые популярные репозитории Go на GitHub в этом месяце.
Самостоятельно развёрнутая альтернатива ChatGPT для локальных LLM
Open WebUI — это мощный, расширяемый и функционально насыщенный веб-интерфейс для самостоятельного хостинга, предназначенный для взаимодействия с большими языковыми моделями.
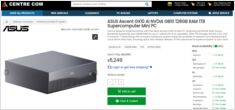
Актуальные цены в австралийских долларах от местных розничных продавцов уже доступны.
Компьютер
NVIDIA DGX Spark
(GB10 Grace Blackwell)
поступил в продажу в Австралии
у крупных розничных продавцов компьютеров с наличием на местных складах.
Если вы следите за
мировым ценообразованием и доступностью DGX Spark,
то вам будет интересно узнать, что в Австралии цены варьируются от 6 249 до 7 999 австралийских долларов в зависимости от конфигурации накопителей и конкретного продавца.
При работе с большими языковыми моделями (LLM) в производственной среде получение структурированных и типобезопасных выходных данных имеет критическое значение.
Два популярных фреймворка — BAML и Instructor — предлагают разные подходы к решению этой задачи.
Размышления об использовании больших языковых моделей для саморазмещаемого Cognee
Выбор лучшей LLM для Cognee требует баланса между качеством построения графов, уровнями галлюцинаций и ограничениями оборудования. Cognee лучше всего работает с крупными моделями с низким уровнем галлюцинаций (32B+) через Ollama, но средние варианты подходят для более легких настроек.
Создайте ИИ-агенты для поиска с помощью Python и Ollama
Библиотека Ollama на Python теперь поддерживает нативные возможности веб-поиска Ollama. Всего несколько строк кода позволяют дополнить ваши локальные LLM актуальной информацией из интернета, что снижает количество галлюцинаций и повышает точность ответов.
Веб-поисковый API Ollama позволяет дополнять локальные LLM актуальной информацией из интернета. В этом руководстве показано, как реализовать возможности веб-поиска на Go, от простых вызовов API до полнофункциональных поисковых агентов.
Сравнение лучших инструментов для локального развёртывания LLM в 2026 году. Зрелость API, поддержка аппаратного обеспечения, вызов инструментов и реальные сценарии использования.
Локальное запуск LLM-моделей сейчас становится практичным решением для разработчиков, стартапов и даже корпоративных команд.
Но выбор правильного инструмента — Ollama, vLLM, LM Studio, LocalAI или других — зависит от ваших целей:
Развертывание корпоративного ИИ на бюджетном оборудовании с использованием открытых моделей.
Демократизация искусственного интеллекта уже здесь.
С появлением открытых LLM, таких как Llama, Mistral и Qwen, которые теперь не уступают проприетарным моделям, команды могут создавать мощную инфраструктуру ИИ на потребительском оборудовании — значительно сокращая расходы при сохранении полного контроля над конфиденциальностью данных и развертыванием.
Я выкопал некоторые интересные тесты производительности GPT-OSS 120b, работающего на Ollama на трех разных платформах: NVIDIA DGX Spark, Mac Studio и RTX 4080. Модель GPT-OSS 120b из библиотеки Ollama весит 65ГБ, что означает, что она не помещается в 16ГБ видеопамяти RTX 4080 (или более новой RTX 5080).
Сравните Docker Model Runner и Ollama для локальных LLM
Запуск больших языковых моделей (LLM) локально
стал все более популярным из-за приватности, контроля затрат и возможностей офлайн-работы.
Ландшафт значительно изменился в апреле 2025 года, когда Docker представил Docker Model Runner (DMR), свое официальное решение для развертывания моделей ИИ.