

Vane(Perplexica 2.0) Ollama 및 llama.cpp를 활용한 빠른 시작
로컬 LLM을 활용한 자체 호스팅 AI 검색
Vane은 “인용과 함께 하는 AI 검색” 분야에서 가장 실용적인 선택지 중 하나입니다. 이는 라이브 웹 검색과 로컬 또는 클라우드 LLM을 결합하는 자체 호스팅형 답변 엔진으로, 전체 스택을 사용자의 통제 아래에 두는 것이 특징입니다.
LLM 실험을 처음 시작했을 당시, 관련 UI는 활발하게 개발 중이었으며 현재는 그 중 일부가 매우 우수합니다.
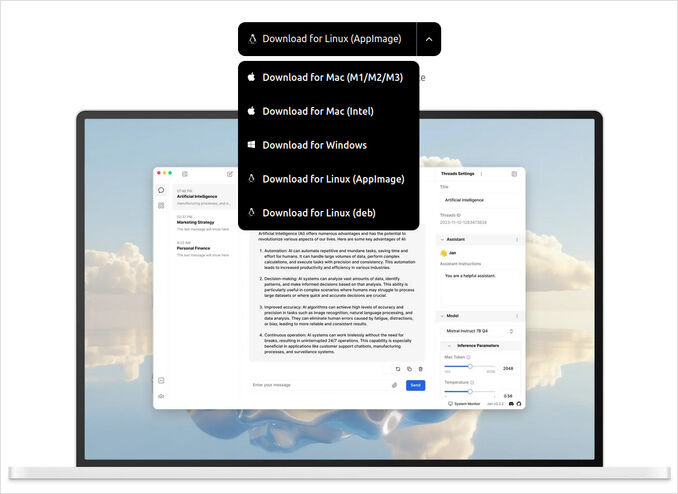
다크, 라이트, 투명 테마를 지원합니다.
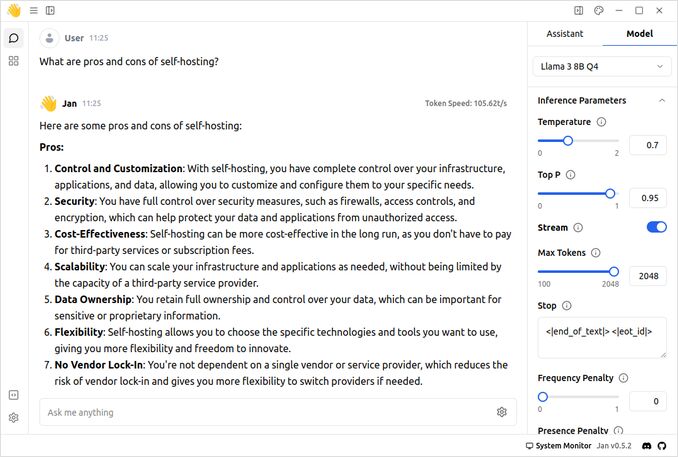
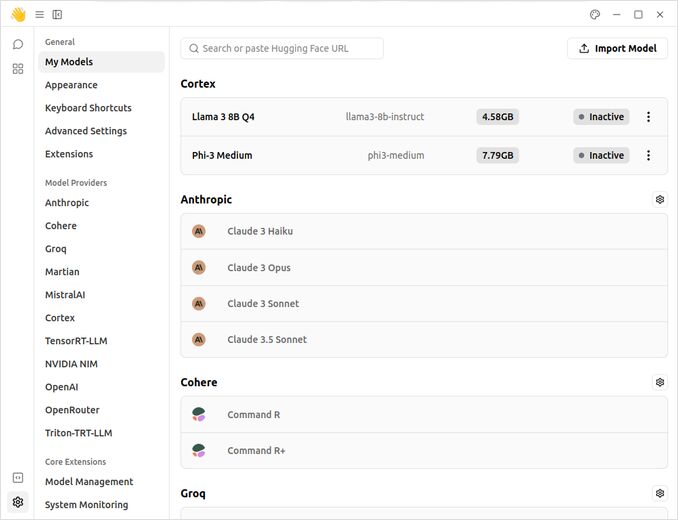
Anthropic, Cohere, OpenAI, NvidiaNIM, MistralAI 등 기존 백엔드 여러 개에 연결할 수 있으며, 자체적으로 모델을 호스팅할 수도 있습니다 - 아래 스크린샷의 Cortex 섹션을 참고하세요. Jan이 Llama3 8b q4와 Phi3 medium (q4)를 다운로드하여 로컬에서 호스팅하는 모습입니다.
장점 (호감스러웠던 점):
단점:
매우 유명한 것입니다
또 다른 매우 다재다능한 도구입니다
LLM Studio는 제가 가장 좋아하는 LLM UI는 아니지만, huggingface 모델에 대한 접근성이 더 좋습니다.
네, 그것도 사용자 인터페이스입니다. 다만 커맨드라인 기반입니다.
llama3.1 LLM을 실행하려면:
ollama run llama3.1
완료 후, ollama 커맨드라인에서 종료하려면 다음 명령을 보내세요:
/bye
아직 설치하지 않았다면 cUrl을 설치하세요
sudo apt-get install curl
ollama에 호스팅된 로컬 mistral nemo q8 llm을 호출하려면 프롬프트가 담긴 로컬 파일 p.json을 생성하세요:
{
  model: mistral-nemo:12b-instruct-2407-q8_0,
  prompt: What is post-modernism?,
  stream: false
}
그리고 이제 bash 터미널에서 실행합니다
curl -X POST http://localhost:11434/api/generate -d @p.json > p-result.json
결과는 p-result.json 파일에 저장됩니다
결과만 출력하려면:
curl -X POST http://localhost:11434/api/generate -d @p.json
아래는 테스트하지는 않았지만, LLM UI에 대한 꽤 포괄적인 목록입니다:
로컬 LLM을 활용한 자체 호스팅 AI 검색
Vane은 “인용과 함께 하는 AI 검색” 분야에서 가장 실용적인 선택지 중 하나입니다. 이는 라이브 웹 검색과 로컬 또는 클라우드 LLM을 결합하는 자체 호스팅형 답변 엔진으로, 전체 스택을 사용자의 통제 아래에 두는 것이 특징입니다.
로컬 LLM용 셀프호스트드 ChatGPT 대안
Open WebUI는 대형 언어 모델(LLM)과 상호작용하기 위한 강력하고 확장 가능하며 기능적인 셀프 호스팅 웹 인터페이스입니다.
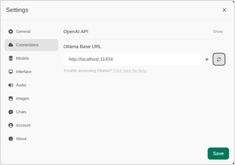
2025년 Ollama의 가장 주목받는 UI에 대한 간략한 개요
로컬에서 호스팅된 Ollama는 자신의 기계에서 대규모 언어 모델을 실행할 수 있게 해주지만, 명령줄을 통해 사용하는 것은 사용자 친화적이지 않습니다.
다음은 로컬 Ollama에 연결되는 **ChatGPT 스타일 인터페이스**를 제공하는 여러 오픈소스 프로젝트입니다.
두 개의 자체 호스팅 AI 검색 엔진 비교
아름다운 음식은 눈으로도 즐길 수 있는 즐거움입니다. 하지만 이번 포스팅에서는 두 가지 AI 기반 검색 시스템인 Farfalle 와 Perplexica 를 비교해 보겠습니다.
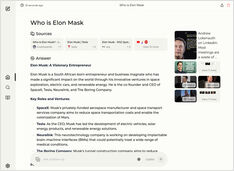
로컬에서 코파일럿 스타일 서비스를 실행하시나요? 간단합니다!
정말 흥미진진합니다!
코파일럿 (Copilot) 이나 perplexity.ai 에 접속하여 전 세계에 당신의 의도를 알릴 필요 없이, 이제 자신의 PC 나 노트북에서 유사한 서비스를 직접 호스팅할 수 있습니다!
시스템, 인프라, AI 엔지니어링에 관한 새 글을 받아보세요.