
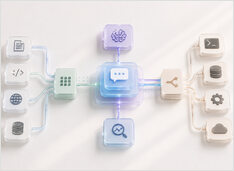
AIアシスタントのアーキテクチャ:LLM、メモリ、ツール、ルーティング、可観測性
本格的なアシスタントは実際にどのように構築されているのか
本番環境向けのAIアシスタントは「プロンプト付きのLLM」ではありません。それは意図を受け取り、状態を保持し、いつ取得したり実行したりするかを決定し、障害のデバッグに必要なランタイムの詳細を公開するシステムです。
本格的なアシスタントは実際にどのように構築されているのか
本番環境向けのAIアシスタントは「プロンプト付きのLLM」ではありません。それは意図を受け取り、状態を保持し、いつ取得したり実行したりするかを決定し、障害のデバッグに必要なランタイムの詳細を公開するシステムです。
AIは知識管理の目的を変えず、手法を変革する。
AIは知識管理を置き換えるものではありません。むしろ、個人およびチームにとって知識管理の形そのものを変革しています。
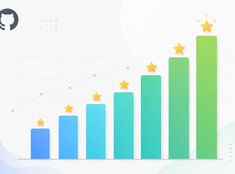
スター数、トークン数、ダウンロード数――どれが本当に優位か?
オープンソースの AI エージェントフレームワークが、GitHub 上で人気が爆発しています。 セルフホスト型 AI システム エコシステムの核心に位置する 2 プロジェクト——OpenClaw と Hermes Agent——は、他のどのプロジェクトよりも大きく差を広げており、残りの競合プロジェクトは遠く離れた 3 位争いを行っています。
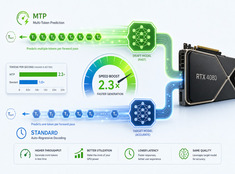
RTX 4080におけるMTPと標準デコーディングの実ベンチマーク比較
Qwen 3.6 27B と 35B において、RTX 4080(16 GB VRAM)上で投機的デコーディング(マルチトークン予測、MTP)のパフォーマンスをテストしました。
llama-serverを停止せずにVRAMを解放する方法
llama.cpp ラーターモード は、llama-server における数年間で最も有用な変更の一つです。これにより、ローカルLLM運用者は、Ollamaで期待されるようなモデル管理体験に近いものをようやく手に入れることができました。同時に、llama-server を使い続ける価値がある生のパフォーマンスと低レベルの制御も維持されています。
AIシステム向けの構造化された知識
前提はシンプルです。コンパイルされた知識は、取得された断片的な情報よりも再利用性が高いというものです。 RAG(検索強化生成)は、LLM(大規模言語モデル)に外部知識へのアクセスをどのように与えるかという直接的な問いに対するデフォルトの答えとなりました。
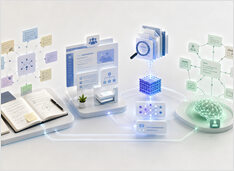
現代の知識システムの地図
PKM、RAG、ウィキ、AIメモリシステム、そして今実用化が進むAI支援ワークフローは、しばしば同じ問題を解決するかのように論じられます。 しかし、実際にはそうではありません。 これらはすべて知識を扱いますが、動作するレイヤーは異なります。
「雰囲気」に頼る解析をやめ、契約を検証せよ。
ほとんどのLLM「構造化出力」チュートリアルは、本気度にかけるものです。 それらは、JSONを丁寧な口調でリクエストし、モデルが適切に動作することを祈る方法を教えます。 それでは検証ではありません。 それは単に括弧で囲まれた楽観主義にすぎません。
エージェント型LLMのチューニングに関する参照資料
このページは、エージェント型LLM推論チューニングの実用的なリファレンス(temperature、top_p、top_k、ペナルティ、およびマルチステップやツール多用なワークフローにおけるそれらの相互作用)です。
より広範なLLMパフォーマンスエンジニアリングハブと併せて参照し、明確なLLMホスティングとサービングの概要と組み合わせることで、モデルがリソース不足に陥った際にはスループットとスケジューリングが依然として支配的ですが、不安定なサンプリングはGPUが処理を終える前にリトライと出力トークンを消費してしまうことがわかります。
このページでは以下をまとめます:
現在、以下に焦点を当てています:
スマートフォンからHermesと会話する
スマートフォンからテキストでヘルメスエージェントとチャットすることはすでに可能でしょう。 今、あなたはエージェントと直接会話し、音声で返信を受け取りたいと考えています。 これは通常、正しい選択です。特にHermesを永続的な自己ホスト型アシスタントとして使用している場合には顕著です。 小さな画面で長いプロンプトをタイプするのは、時間がかかり、誤りも生じやすいものです。
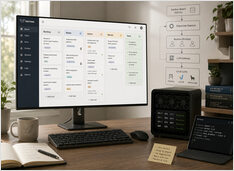
セルフホスト型LLMのHermesカンバンの負荷を制御する。
Hermes Agentには、Kanbanスタイルのボードと、一度に多くのタスクがディスパッチされるとセルフホスト型LLMを飽和状態にしてしまう可能性のあるHermes Gatewayが同梱されています。
著者:Hermes。高速に読み込まれ、安定して動作するスキル。
Hermes Agentは、繰り返し可能なワークフローを教えるデフォルトの方法としてスキルを採用しています。公式ドキュメントでは、スキルはオープンなagentskills.io仕様に準拠したオンデマンド型ナレッジ文書と説明されており、**プログレッシブ・ディスクロージャー(段階的開示)**によってモデルがまず小さなインデックスを見て、タスクが実際に必要としたときにのみ完全な指示を取得する仕組みになっています。
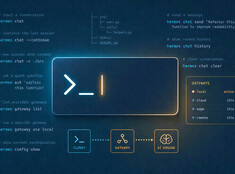
セルフホストされたHermes Agent用シェルおよびTUIコマンド。
Nous Research が提供する Hermes Agent は、モデル非依存型でツール利用可能なアシスタントであり、ローカルまたは VPS で実行し、シェル、全画面表示の TUI、メッセージングゲートウェイのいずれからでも利用できます。
NemoClawでOpenClawを安全に実行
大多数のAIエージェントスタックは、セキュリティをデモ後の修正事項として扱っています。 NemoClawは対極の前提から始まり、隔離、ポリシー、ルーティングを初期設定(Day-Zero defaults)として採用しています。
キャプチャポリシーは、リコールと同等の重要さを帯びつつある。
2026年9月更新: Mnemosyne と Memori を追加、Honcho と Hindsight の設定を拡張し、元のインフラストラクチャテーブルの yanıでキャプチャポリシー比較表を追加しました。
現代のAIアシスタントは、タブを閉じても何も覚えていない状態が続きますが、これはコンテキストウィンドウを超えて何かが永続化されないためです。エージェントメモリプロバイダーとは、セッション間で事実や要約を保持するサービスまたはライブラリです。多くの場合、プラグインとして組み込まれることで、フレームワークをスリムに保ちながらメモリをスケーリングできます。
単一のチャットスレッドを超えた永続的なナレッジ。
このセクションでは、AIシステムの永続的な知識と記憶に関するガイドをまとめています。アシスタントが事実、設定、抽出された文脈を、プロンプトにすべてのトークンを詰め込むことなく、セッション間で維持する方法についてです。ここでは、記憶とはGPUのRAMやモデルの重みではなく、意図的な保持(ユーザーに関する事実、要約、プラグインバックエンドのストアなど)を指します。