
OpenClawの興亡 — 崩壊のタイムラインと真の背景
OpenClawは急速に台頭し、その後、さらに急速に姿を消した。
OpenClawは製品として失敗したわけではありません。単に「燃料」を失っただけです。
OpenClawは急速に台頭し、その後、さらに急速に姿を消した。
OpenClawは製品として失敗したわけではありません。単に「燃料」を失っただけです。
再起動せずにLLMを配信・切り替え可能。
長らく、llama.cpp には致命的な制限がありました。
それは、1プロセスにつき1つのモデルしか提供できず、モデルを切り替えるには再起動が必要だった点です。
本番環境で耐えるClaude Skillsの構築
ほとんどのチームは、Claude Skillsの使い方を2つのいずれかの誤った方法で運用しています。SKILL.mdを単なるゴミ箱のように使っているか、巨大なプロンプトの切り貼りから抜け出せずにいるかのどちらかです。
本格的なワークロード向け「Profile-first」Hermes設定
公式にはHermes Agentとして文書化されているHermes AIアシスタントは、単なるチャットラッパーとしては位置づけられていません。
保持すべきスキルと、スキップしてよいスキル
OpenClawには2つの拡張ストーリーがあり、それらは混同されやすいものです。
プラグインはランタイムを拡張します。スキルはエージェントの振る舞いを拡張します。
まずはプラグイン。スキルの名称を簡潔に。
この記事は、チャネル、モデルプロバイダー、ツール、音声、メモリ、メディア、Web 検索、その他ランタイムの表面機能などを追加するネイティブゲートウェイパッケージであるOpenClaw プラグインについて解説します。
実際のOpenClawシステムはどのように構成されているのか
OpenClawのデモではシンプルに見えます。 しかし、本番環境では、それは一つのシステムへと変貌します。
Claudeのサブスクリプションはエージェントの稼働に使用されなくなりました
エージェント実験の波を後押ししていた静かな抜け穴は、今、閉じられました。
ローカルLLMによるセルフホステッドAI検索
Vaneは、「引用付きAI検索」分野でより実用志向の選択肢の一つです。ライブなWeb検索とローカルまたはクラウドのLLMを組み合わせつつ、スタック全体を自分自身の管理下におくセルフホスト型の回答エンジンです。
ローカルモデルバックエンドに対応したエージェンティックコーディング
Claude Codeは、マーケティングが上手な自動補完ツールではありません。これはエージェント型コーディングツールです。コードベースを読み取り、ファイルを編集し、コマンドを実行し、開発ツールと統合します。
開発者向け Hermes Agent インストールとクイックスタート
Hermes Agentは、ローカルマシンまたは低コストのVPS上で動作する、セルフホスト型かつモデル非依存のAIアシスタントです。ターミナルおよびメッセージングインターフェースを通じて機能し、繰り返し実行されるタスクを再利用可能なスキルに変換することにより、時間の経過とともに改善していきます。
TGI をインストールし、迅速にデプロイ、さらに高速にデバッグ。
Text Generation Inference (TGI) は、非常に特有の雰囲気を持っています。 推論の分野で最も新しい子供ではありませんが、すでに本番環境でのトラブルを学び、その教訓をデフォルト設定に焼き付けているのが TGI です。
llama.cppの16 GB VRAMにおけるトークン速度(テーブル)。
ここでは、16GBのVRAMを備えたGPUで動作する複数のLLM(大規模言語モデル)の速度を比較し、セルフホスティングに最適なモデルを選びます。
これらのLLMは、llama.cpp上で19K、32K、64Kトークンのコンテキストウィンドウで実行しました。
スタイライズされたGPUとVRAMブロック、およびベンチマーク風のチャート
この記事では、速度という観点から、可能な限り高いパフォーマンスを引き出そうとした試みを記録しています。
| モデル | サイズ | 19K VRAM | 19K GPU/CPU | 19K T/s | 32K VRAM | 32K 負荷 | 32K T/s | 64K VRAM | 64K 負荷 | 64K: T/s |
|---|---|---|---|---|---|---|---|---|---|---|
| Qwen3.6-35B-A3B-UD-IQ3_XXS | 13.2 | 13.8GB | 96%/100% | 147.5 | 14.0GB | 96%/101% | 149.1 | 14.7GB | 96%/101% | 145.8 |
| Qwen3.6-35B-A3B-UD-IQ4_XS | 17.7 | 14.3GB | 62%/266% | 95.0 | 14.9GB | 58%/279% | 92.3 | 14.9GB | 57%/293% | 86.4 |
| Qwen3.5-35B-A3B-UD-IQ3_S | 13.6 | 14.3GB | 93%/100% | 136.4 | 14.6GB | 93%/100% | 138.5 | 14.9GB | 88%/115% | 136.8 |
| Qwen3.5-27B-IQ3_XXS-bartowsky | 11.3 | 12.8 | 98/100 | 44.9 | 13.5 | 98/100 | 44.9 | 14.5 | 45/415 | 23.6 |
| Qwen3.5-27B-UD-IQ3_XXS | 11.5 | 12.9 | 98/100 | 45.3 | 13.7 | 98/100 | 45.1 | 14.7 | 45/410 | 22.7 |
| Qwen3.5-27B-IQ4_XS.gguf | 15.0 | 14.6 | 49/406 | 20.5 | 14.7 | 37/465 | 17.4 | 14.7 | 23/533 | 13.3 |
| Qwen3.5-122B-A10B-UD-IQ3_XXS | 44.7 | 14.7 | 30/470 | 22.3 | 14.7 | 30/480 | 21.8 | 14.7 | 28/490 | 21.5 |
| Qwen3.5-122B-A10B-UD-IQ3_S | 46.5 | 14.7 | 25/516 | 19.4 | 14.7 | 24/516 | 19.5 | 14.7 | 24/516 | 19.6 |
| Mistral-Small-4-119B UD-IQ3_XXS | 42.8 | 14.8 | 28/585 | 30.4 | 14.7 | 27/574 | 28.5 | 14.9 | 20/590 | 31.5 |
| Qwen3-Coder-Next-UD-IQ4_XS | 38.4 | 14.6 | 32/460 | 41.1 | 14.7 | 29/440 | 41.3 | 14.8 | 32/460 | 38.3 |
| Nemotron Super 120b IQ3_XXS | 56.2 | 15.0 | 26/517 | 17.5 | 14.6 | 26/531 | 17.4 | 14.6 | 26/535 | 17.6 |
| gemma-4-26B-A4B-it-UD-IQ4_XS | 13.4 | 14.7 | 95/100 | 121.7 | 14.9 | 95/115 | 114.9 | 14.9 | 75/190 | 96.1 |
| gemma-4-31B-it-UD-IQ3_XXS | 11.8 | 14.8 | 68/287 | 29.2 | 14.8 | 41/480 | 18.4 | 14.8 | 18/634 | 8.1 |
| GLM-4.7-Flash-IQ4_XS | 16.3 | 15.0 | 66/240 | 91.8 | 14.9 | 62/262 | 86.1 | 14.9 | 53/313 | 72.5 |
| GLM-4.7-Flash-REAP-23B IQ4_XS | 12.6 | 13.7 | 92/100 | 122.0 | 14.4 | 95/102 | 123.2 | 14.9 | 71/196 | 97.1 |
19K、32K、64Kはコンテキストサイズを指します。
GPU および永続性を備えた Compose ファーストの Ollama サーバー。
Ollama は、メタル(物理マシン)上で非常に良好に動作します。それをサービスとして扱うと、さらに興味深くなります。安定したエンドポイント、固定されたバージョン、永続的なストレージ、そして GPU が利用可能か不可かの明確な状態が確保されます。
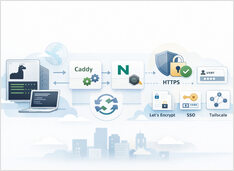
ストリーミング応答を破綻させずに HTTPS で Ollama を利用する。
リバースプロキシの背後で Ollama を実行することは、HTTPS、オプションのアクセス制御、予測可能なストリーミング動作を実現する最も簡単な方法です。
SGLang を使ってオープンモデルを高速に提供。
SGLang は、大規模言語モデルおよびマルチモーダルモデル向けの高パフォーマンスなサービングフレームワークであり、単一の GPU から分散クラスターに至るまで、低レイテンシかつ高スループットの推論を提供するために設計されています。