
Qwen 3.6 27B e 35B MTP rispetto a Standard su GPU da 16GB
MTP vs decodifica standard su RTX 4080 — benchmark reali
Ho testato le prestazioni del decodifica speculativa (Multi-Token Prediction, MTP) con Qwen 3.6 27B e 35B su una RTX 4080 con 16 GB di VRAM.
Per una panoramica più ampia delle velocità dei token e dei compromessi sulla VRAM tra diversi modelli sulla stessa hardware, consulta i benchmark LLM su GPU da 16 GB di VRAM con llama.cpp.
Cos’è l’MTP (Multi-Token Prediction)
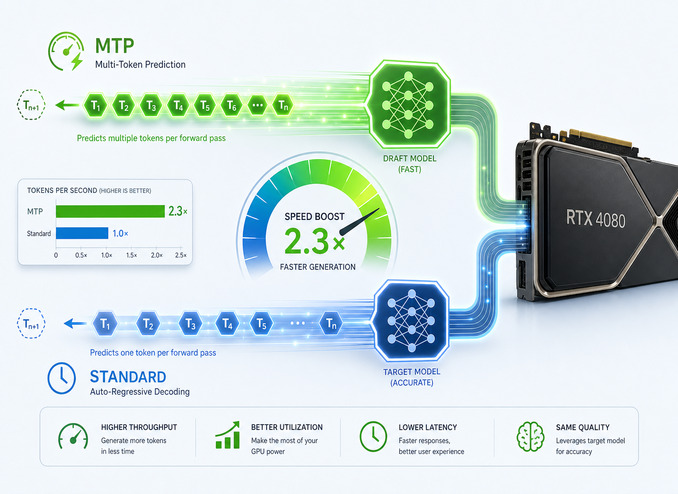
Il Multi-Token Prediction è una forma di decodifica speculativa integrata direttamente in determinati checkpoint dei modelli. Invece di prevedere un token per passaggio in avanti, il modello incorpora ulteriori “teste MTP” che propongono diversi token futuri in un singolo passaggio — per poi verificarli in parallelo. Se le ipotesi vengono accettate, il throughput effettivo aumenta senza alterare la qualità dell’output.
La famiglia Qwen 3.6 è fornita sia con file GGUF standard che con varianti abilitate per MTP. In llama.cpp, l’MTP viene attivato tramite:
--spec-type draft-mtp --spec-draft-n-max 3
--spec-draft-n-max è il parametro chiave per la configurazione. Stabilisce quanti token speculativi la testa MTP propone a ogni passo. Valori più elevati offrono un potenziale aumento di velocità ma comportano un costo aggiuntivo in termini di VRAM per i buffer di bozza — un vincolo concreto su schede da 16 GB.
Cosa e come ho testato
Ho testato il comportamento dei due modelli Qwen 3.6 con MTP abilitato rispetto alla decodifica standard su una GPU con 16 GB di VRAM (RTX 4080).
Per far rientrare i pesi del modello e la cache KV nella VRAM, ho utilizzato varianti fortemente quantizzate:
Qwen3.6-27B-UD-IQ3_XXSeQwen3.6-27B-UD-IQ3_XXS-MTPQwen3.6-35B-A3B-UD-IQ3_SeQwen3.6-35B-A3B-UD-IQ3_S-MTP
Per ogni esecuzione vengono monitorati due budget di contesto:
- Avg Ctx (Contesto Medio) — la dimensione del contesto in cui llama.cpp occupa circa 14,8 GB di VRAM, lasciando alle altre applicazioni (Xorg, GNOME Shell, Cursor) un comodo buffer di circa 500 MB.
- Max Ctx (Contesto Massimo) — il contesto più grande che llama.cpp poteva allocare, considerando che le stesse applicazioni desktop occupano già circa 500 MB di VRAM.
Un motivo chiave per mantenere il contesto medio a un obiettivo pratico è che Hermes Agent — che utilizzo come assistente AI principale connesso a llama.cpp su questa macchina — richiede almeno 64 K di contesto in modo predefinito e rifiuterà i modelli con una finestra inferiore all’avvio. I modelli al di sotto di questa soglia non possono mantenere una memoria di lavoro sufficiente per flussi di lavoro di chiamata a strumenti in più fasi. Per llama.cpp ciò significa passare --ctx-size 65536 o superiore. Qualsiasi configurazione MTP che comprime il contesto medio utilizzabile significativamente sotto i 64 K è quindi inadatta per i carichi di lavoro giornalieri di Hermes, ed è per questo che i numeri di Avg Ctx nelle tabelle seguenti sono quelli più rilevanti per il processo decisionale.
Sono stati testati entrambi i livelli di quantizzazione della cache KV: q8 (qualità superiore, più VRAM) e q5 (meno VRAM, contesto più lungo). Si tenga presente che il passaggio da q8 a q5 per la cache KV può causare un calo di qualità percettibile — nei miei test, il deterioramento era significativo enough da rendere q5 inadatto per i miei carichi di lavoro. I numeri di velocità e contesto per q5 sono inclusi per completezza, ma dovresti testare la qualità delle risposte sui tuoi stessi task prima di impegnarti su di essa.
Qwen 3.6 27B MTP vs Standard
Cache KV q8
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Standard (IQ3_XXS) | |
|---|---|---|---|---|---|
| Prompt Speed | 148 t/s | 151 t/s | 148 t/s | 147 t/s | 200 t/s |
| Gen Speed | 65 t/s | 75 t/s | 73 t/s | 75 t/s | 45 t/s |
| Avg Ctx | 40 K | 40 K | 40 K | 30 K | 80 K |
| Max Ctx | 60 K | 60 K | 60 K | 50 K | 100 K |
Con cache KV q8, l’MTP con --spec-draft-n-max 2 offre una generazione circa il 67 % più veloce (75 contro 45 t/s) al costo di dimezzare la finestra di contesto media da 80 K a 40 K. La velocità di ingestione dei prompt scende da 200 a circa 150 t/s perché l’MTP richiede trasferimenti da dispositivo a host durante la fase di prefill.
Cache KV q5
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Standard (IQ3_XXS) | |
|---|---|---|---|---|---|
| Prompt Speed | 145 t/s | 144 t/s | 141 t/s | 139 t/s | 191 t/s |
| Gen Speed | 57 t/s | 62 t/s | 67 t/s | 66 t/s | 41 t/s |
| Avg Ctx | 70 K | 60 K | 60 K | 50 K | 130 K |
| Max Ctx | 100 K | 100 K | 90 K | 80 K | 160 K |
Passando alla cache KV q5 si recuperano contesti significativi: --spec-draft-n-max 1 offre un contesto medio di 70 K a 57 t/s — un accelerazione della generazione del 39 % rispetto alla decodifica standard mantenendo comunque la finestra di contesto a una dimensione utile. Con --spec-draft-n-max 3 il contesto scende a 60 K ma la generazione raggiunge 67 t/s (+63 %).
Conclusione per Qwen 3.6 27B
L’MTP è genuinamente utile per il modello denso da 27B. Il punto di equilibrio su 16 GB di VRAM è:
- KV q8 +
--spec-draft-n-max 2— la velocità grezza migliore (75 t/s), contesto ridotto a 40–60 K - KV q5 +
--spec-draft-n-max 1— il miglior equilibrio tra velocità e contesto (57 t/s, contesto medio 70 K)
Qwen 3.6 35B MTP vs Standard
Il modello da 35B è un’architettura Mixture-of-Experts (MoE) (35B-A3B significa 35B parametri totali, circa 3B attivi per token). I modelli MoE di solito traggono maggior beneficio dall’MTP perché il routing sparsa mantiene la testa MTP computazionalmente economica rispetto a un passaggio in avanti completo.
Cache KV q8
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Standard (IQ3_S) | |
|---|---|---|---|---|---|
| Prompt Speed | 277 t/s | 277 t/s | 265 t/s | 275 t/s | 368 t/s |
| Gen Speed | 186 t/s | 189 t/s | 180 t/s | 171 t/s | 146 t/s |
| Avg Ctx | 15 K | 10 K | — | — | 80 K |
| Max Ctx | 80 K | 70 K | 60 K | 50 K | 150 K |
L’architettura MoE offre una velocità grezza di generazione impressionante con l’MTP (+27 % a max 1, +29 % a max 2 rispetto agli standard 146 t/s). Ma il problema pratico è il contesto medio. Con cache KV q8, anche --spec-draft-n-max 1 offre solo 15 K di contesto medio — a malapena sufficiente per task modesti. Profondità di bozza superiori non hanno affatto un contesto medio praticabile su una scheda da 16 GB.
Questa è la questione centrale dei costi in termini di VRAM per l’MTP su hardware consumer: i buffer di bozza aggiuntivi intaccano direttamente il budget di VRAM rimanente e il modello 35B-A3B con cache KV q8 lascia pochissimo margine.
Cache KV q5
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Standard (IQ3_S) | |
|---|---|---|---|---|---|
| Prompt Speed | 264 t/s | 266 t/s | 270 t/s | 264 t/s | 343 t/s |
| Gen Speed | 151 t/s | 147 t/s | 137 t/s | 131 t/s | 122 t/s |
| Avg Ctx | 10 K | — | — | — | 120 K |
| Max Ctx | 120 K | 110 K | 110 K | 80 K | 200 K |
La cache KV q5 migliora solo marginalmente la situazione del contesto medio. --spec-draft-n-max 1 offre 10 K di contesto medio a 151 t/s. La decodifica standard a q5 offre 122 t/s con un contesto medio di 120 K.
Conclusione per Qwen 3.6 35B
Su una GPU da 16 GB, il modello MoE da 35B con MTP affronta un muro invalicabile: il contesto utilizzabile medio collassa a 10–15 K token, rendendolo impraticabile per carichi di lavoro reali. La decodifica standard a 122–146 t/s con un contesto di 80–120 K è significativamente più utile.
Se si dispone di 24 GB o più di VRAM, la combinazione 35B + MTP diventa molto più interessante — il problema della finestra di contesto scompare e si mantiene il beneficio di velocità.
Scegliere il valore corretto di --spec-draft-n-max
La domanda su quanti token speculativi proporre per ogni passo (--spec-draft-n-max) non ha una singola risposta corretta — dipende sia dall’architettura del modello che dalla VRAM disponibile:
- Per 27B denso su 16 GB:
--spec-draft-n-max 2con KV q8 è il più veloce,--spec-draft-n-max 1con KV q5 è il più favorevole al contesto. - Per 35B MoE su 16 GB:
--spec-draft-n-max 1è l’unica opzione che mantiene un contesto utilizzabile, e anche in quel caso solo marginalmente. - Valori più elevati (
3,4) aumentano la pressione sulla VRAM senza guadagni di velocità proporzionali — a max 4 si sta spendendo circa la stessa VRAM in eccesso di max 2 ma la velocità di generazione non tiene il passo.
Come abilitare l’MTP in llama.cpp
Assicurati di utilizzare un file GGUF abilitato per MTP (il nome del file contiene MTP). Se sei nuovo ai flag di llama.cpp, la Guida rapida a llama.cpp con CLI e Server copre tutti i fondamenti. Quindi avvia llama-server o llama-cli con:
llama-server \
  --model Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf \
  --ctx-size 40000 \
  -ngl 99 --flash-attn on \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --spec-type draft-mtp \
  --spec-draft-n-max 2
Per la cache KV q5, sostituisci q8_0 con q5_1 o q5_0 e aggiusta --ctx-size verso l’alto:
llama-server \
  --model Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf \
  --ctx-size 80000 \
  -ngl 99 --flash-attn on \
  --cache-type-k q5_1 --cache-type-v q5_1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 1
L’MTP viene attivato automaticamente non appena llama.cpp individua le teste MTP nel file GGUF e --spec-type draft-mtp è impostato.
Quindi Qwen3.6-27B-UD-IQ3_XXS.gguf standard non funzionerà in modalità MTP, servirà Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf.
Ma Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf può funzionare sia in modalità di decodifica speculativa che in quella autoregressiva.
Conclusione
Su una GPU da 16 GB (RTX 4080), con queste quantizzazioni, l’MTP di llama.cpp è una netta vittoria per Qwen 3.6 27B e un risultato negativo netto per Qwen 3.6 35B nell’uso pratico:
Qwen 3.6 27B (IQ3_XXS) — l’MTP vale la pena:
- KV q8 + MTP max 2 → generazione circa il 67 % più veloce, contesto 40–60 K (contro 80–100 K senza MTP)
- KV q5 + MTP max 1 → generazione circa il 39 % più veloce, contesto 70–100 K (contro 130–160 K senza MTP)
- Buon equilibrio tra velocità ed efficienza della VRAM con
--spec-draft-n-max 2
Qwen 3.6 35B (IQ3_S) — l’MTP non è pratico a 16 GB:
- La velocità di generazione è del 27–29 % più alta ma il contesto medio collassa a 10–15 K con q8 e 10 K con q5
- La decodifica standard a 122–146 t/s con un contesto di 80–120 K è più utile per i task reali
- La situazione migliora significativamente con 24 GB o più di VRAM
Sulla carta, la cache KV q5 è la risposta ovvia per massimizzare la finestra di contesto mantenendo i guadagni di velocità dell’MTP — ma nella pratica, il calo di qualità passando da q8 a q5 può essere significativo. Testa q5 sui tuoi propri task prima di adottarlo; per i miei carichi di lavoro il deterioramento era inaccettabile e q8 con un budget di contesto più stretto rimane il compromesso migliore.
Per una visione più ampia delle opzioni di hosting LLM e dei compromessi infrastrutturali, consulta il pilastro Hosting LLM nel 2026 e Prestazioni LLM nel 2026. Dove questa classe da 27B si colloca sullo spettro di dimensioni e costi del 2026, e perché una build attuale Qwen3.8-27B Q4 richiede una scheda da 24 GB mentre le misurazioni sopra restano su 16 GB, è in Il Confine Efficiente dei Modelli Aperti nel 2026. Se stai tarando le impostazioni del sampler di Qwen 3.6 insieme all’MTP, il Riferimento sui Parametri di Inferenza Agentic LLM per Qwen 3.6 e Gemma 4 è un compagno utile.
