
PDFから画像を抽出するにはpopplerを使用します。
PDFファイルから画像を抽出する必要があるとき
PDFファイルから画像を保存する必要がある場合、スクリーンショットを撮ったり、PDFを画面にレンダリングしたりすることなく、画像を抽出する必要があります。pdfimagesはそのような状況で役立ちます。本ガイドは、2026年のドキュメンテーションツール: Markdown、LaTeX、PDF、および印刷ワークフロー ハブの一部です。
PDFファイルから画像を抽出する必要があるとき
PDFファイルから画像を保存する必要がある場合、スクリーンショットを撮ったり、PDFを画面にレンダリングしたりすることなく、画像を抽出する必要があります。pdfimagesはそのような状況で役立ちます。本ガイドは、2026年のドキュメンテーションツール: Markdown、LaTeX、PDF、および印刷ワークフロー ハブの一部です。
Visual Studio Code チートシートはこちらです
JWT トークンの内容を素早く確認します
コマンドラインから JWT トークンを直接デコードして印刷するための効果的な方法をいくつか紹介します:JWT トークンのデコードと印刷
Windows、Linux、MacでBase64をエンコードおよびデコードする。
このチートシートでは、Windows、Linux、macOS 上で certutil、PowerShell、base64 を使用して Base64 でエンコードおよびデコードする方法、そしてシステムによって異なるフラグを紹介します。
たまに、PDFにページを追加する必要があります...
または、PDFから画像とテキストを抽出したい別の日もあります。このガイドは、2026年のドキュメントツール: Markdown、LaTeX、PDFおよび印刷ワークフロー ハブの一部です。
MM* ツールのフルセットは EOL となっています...
私はMMDetection (mmengine, mdet, mmcv)をかなり使い、
今ではそのゲームから出てしまったようです。
残念です。私はそのモデルズーが好きでした。
時折、Hugoベースのウェブサイトにフォームの送信機能を追加する必要があります。
毎月の第2金曜日ではなくても、それでも…
Linux サービスとして任意の実行ファイルを実行する
以下は、Linuxで任意の実行可能ファイルをサービスとして実行する方法に関する指示です。Systemdを使用して任意の実行可能ファイルをサービスとして実行する方法。
2つのdeepseek-r1モデルを2つのベースモデルと比較する
DeepSeekの 1世代目の推論モデルで、OpenAI-o1と同等の性能を備えています。 これは、LlamaおよびQwenに基づいてDeepSeek-R1から蒸留された6つの密結合モデルです。

ここでは、このエラーを修正する方法について説明します。
以前、バックエンドを含むFlutterプロジェクトをAWS Amplifyにデプロイする方法について説明しました。FlutterプロジェクトをバックエンドとともにAWS Amplifyにデプロイ。
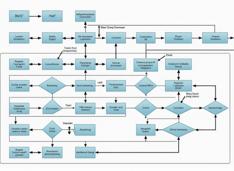
一部のPOSSEの概念と例
SearXNGに関するいくつかの詳細
SearXNG は、Searx からフォークされた無料のオープンソース連合メタ検索エンジンです。 github 上の SearXNG プロジェクト は、すでに15,000以上のスターを獲得しています。
ここでは選択肢がほとんどないようです...
紙ベースの計画が最適な選択肢となるとき
紙ベースの計画、日記の書き方、メモの取り方は、特定のタスクを完了するのに役立ち、すべてのことに満足感を与えることができます。
Pythonプログラムを単一ファイルに組み合わせる
PyInstallerを使用して、Linux、Windows、Macで動作するスタンドアロンの実行ファイルとしてPythonのプログラムをパッケージ化できます。
最も効率的ではありませんが、使用可能です。
実装例
ここでは、AWS SAMでのラムダ関数を使用したペアの実装に必要な手順をリストします:
システム、インフラ、AIエンジニアリングの新記事をお届けします。