Llm

O que vem depois dos LLMs? Mamba, Difusão e Modelos de Mundo

O que vem depois dos LLMs? Mamba, Difusão e Modelos de Mundo

O que vem depois dos LLMs? A era pós-transformer.

O hype em IA segue um ritmo: aproximadamente a cada três anos, a arquitetura em que todos estão apostando é substituída por algo mais novo. A próxima mudança já está se formando nos laboratórios de pesquisa.
Revisão do Agente de Codificação Pi: CLI de IA Minimalista e Hackeável

Revisão do Agente de Codificação Pi: CLI de IA Minimalista e Hackeável

Um pequeno agente de programação que espera que você o molde.

O Pi Coding Agent é um harness de codificação minimalista e de código aberto para terminal que é fornecido com quatro ferramentas padrão e deixa a maior parte do comportamento para extensões, habilidades e o seu próprio fluxo de trabalho.

Gravidade de Dados: O Custo Real da IA Prioritária em APIs

Gravidade de Dados: O Custo Real da IA Prioritária em APIs

Por que seu stack de IA fica mais grudento a cada mês.

Cada chamada de API parece uma transação simples — até que uma quantidade suficiente delas se acumule, de modo que seus dados de ajuste fino, seus conjuntos de avaliação e seus esquemas de ferramentas fiquem moldados em torno de um único fornecedor, e a troca deixe de ser apenas uma mudança de roteamento.

Do Ollama ao vLLM: quando migrar seu servidor local de LLM

Do Ollama ao vLLM: quando migrar seu servidor local de LLM

Quando migrar do Ollama para o vLLM

Ollama é uma das formas mais simples de executar um modelo de linguagem local, mas a conveniência pode mascarar o momento em que um experimento local se torna um serviço de inferência compartilhado que necessita de melhor agendamento e observabilidade.

Mantendo Especificações, Testes e Código Sincronizados no Desenvolvimento de IA

Mantendo Especificações, Testes e Código Sincronizados no Desenvolvimento de IA

Evite que agentes de IA se desviem das especificações, testes e código.

Agentes de codificação com IA entregam funcionalidades rapidamente, mas especificações, testes e código se afastam silenciosamente uns dos outros. Este guia aborda um modelo de rastreabilidade, mapeamento de especificação para teste e de especificação para código, e as verificações de CI que detectam esse desvio antes de um merge.

GPUs para IA em 2026: NVIDIA, AMD e Intel Comparadas

GPUs para IA em 2026: NVIDIA, AMD e Intel Comparadas

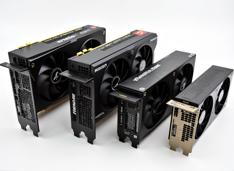
Comparação de GPUs de IA entre três fornecedores

O cenário do hardware de IA mudou significativamente em 2026, com NVIDIA, AMD e Intel competindo por desenvolvedores que necessitam de GPUs capazes de executar modelos de linguagem grandes (LLMs) e cargas de trabalho de inferência de IA localmente.

Decodificação Especulativa: Inferência de LLMs 20-50% Mais Rápida

Decodificação Especulativa: Inferência de LLMs 20-50% Mais Rápida

Inferência de LLM mais rápida sem perda de qualidade – um guia prático

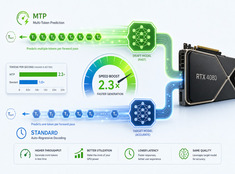
Um modelo de 70B gera um token por passagem de frente, e cada passagem recarrega os pesos da VRAM, calcula a atenção através do contexto e sincroniza a memória. Entre os tokens, a GPU fica ociosa enquanto aguarda que as dependências sequenciais sejam resolvidas.