
Qwen 3.6 27B e 35B MTP vs Padrão em GPU de 16GB
MTP vs. decodificação padrão na RTX 4080 — benchmarks reais
Testei o desempenho da decodificação especulativa (Previsão de Múltiplos Tokens, MTP) no Qwen 3.6 27B e 35B em uma RTX 4080 com 16 GB de VRAM.
Para uma visão mais ampla das velocidades de tokens e dos compromissos de VRAM em mais modelos no mesmo hardware, veja Benchmarks de LLMs com VRAM de 16 GB usando llama.cpp.
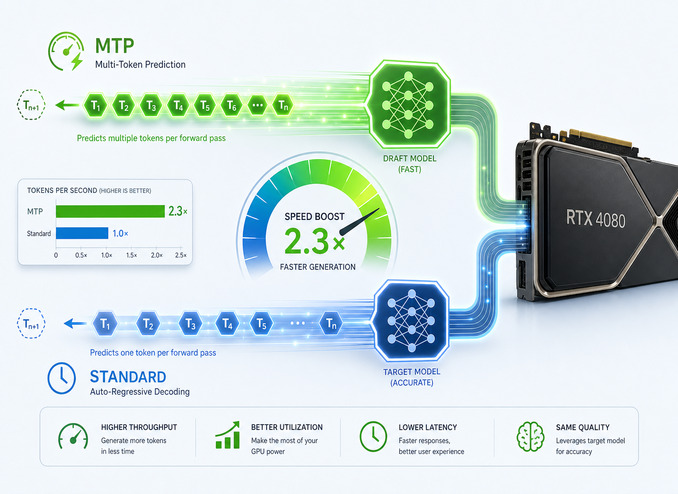
O que é MTP (Previsão de Múltiplos Tokens)
A Previsão de Múltiplos Tokens é uma forma de decodificação especulativa integrada diretamente em certos checkpoints de modelos. Em vez de prever um token por passagem de frente, o modelo possui cabeças “MTP” adicionais que propõem vários tokens futuros em uma única etapa — e então os verifica em paralelo. Se as previsões forem aceitas, a taxa de transferência efetiva aumenta sem alterar a qualidade da saída.
A família Qwen 3.6 oferece tanto arquivos GGUF padrão quanto variantes habilitadas para MTP. No llama.cpp, o MTP é ativado através de:
--spec-type draft-mtp --spec-draft-n-max 3
--spec-draft-n-max é o principal parâmetro de ajuste. Ele define quantos tokens especulativos a cabeça MTP propõe em cada etapa. Valores mais altos proporcionam um potencial aumento de velocidade, mas custam VRAM extra para os buffers de rascunho — uma restrição real em placas de 16 GB.
O que e como testei
Testei como os dois modelos Qwen 3.6 se comportam com MTP habilitado versus decodificação padrão em uma GPU com 16 GB de VRAM (RTX 4080).
Para caber os pesos do modelo e o cache KV na VRAM, usei variantes fortemente quantizadas:
Qwen3.6-27B-UD-IQ3_XXSeQwen3.6-27B-UD-IQ3_XXS-MTPQwen3.6-35B-A3B-UD-IQ3_SeQwen3.6-35B-A3B-UD-IQ3_S-MTP
Dois orçamentos de contexto são rastreados por execução:
- Ctx Médio — o tamanho do contexto no qual o llama.cpp ocupa ~14,8 GB de VRAM, deixando outros aplicativos (Xorg, GNOME Shell, Cursor) com uma reserva confortável de ~500 MB.
- Ctx Máx — o maior contexto que o llama.cpp poderia alocar, dado que os mesmos aplicativos da área de trabalho já ocupam ~500 MB de VRAM.
Um motivo importante para manter o contexto médio em uma meta prática é que o Hermes Agent — que uso como assistente de IA principal conectado ao llama.cpp neste computador — exige pelo menos 64 K de contexto por padrão e rejeitará modelos com uma janela menor na inicialização. Modelos abaixo desse limiar não conseguem manter memória de trabalho suficiente para fluxos de trabalho de chamadas de ferramentas em múltiplas etapas. Para o llama.cpp, isso significa passar --ctx-size 65536 ou maior. Qualquer configuração de MTP que comprima o contexto utilizável médio significativamente abaixo de 64 K é, portanto, inadequada para as cargas de trabalho diárias do Hermes, motivo pelo qual os números de Ctx Médio nas tabelas abaixo são os mais relevantes para a tomada de decisão.
Ambos os níveis de quantização do cache KV foram testados: q8 (qualidade superior, mais VRAM) e q5 (menos VRAM, contexto mais longo). Esteja ciente de que a mudança do cache KV q8 para q5 pode causar uma queda de qualidade perceptível — nos meus testes, a degradação foi significativa o suficiente para tornar o q5 inadequado para as minhas cargas de trabalho. Os números de velocidade e contexto para q5 estão incluídos para completude, mas você deve testar a qualidade da resposta nas suas próprias tarefas antes de se comprometer com isso.
Qwen 3.6 27B MTP vs Padrão
Cache KV q8
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Padrão (IQ3_XXS) | |
|---|---|---|---|---|---|
| Velocidade de Prompt | 148 t/s | 151 t/s | 148 t/s | 147 t/s | 200 t/s |
| Velocidade de Geração | 65 t/s | 75 t/s | 73 t/s | 75 t/s | 45 t/s |
| Ctx Médio | 40 K | 40 K | 40 K | 30 K | 80 K |
| Ctx Máx | 60 K | 60 K | 60 K | 50 K | 100 K |
Com cache KV q8, o MTP com --spec-draft-n-max 2 entrega ~67 % de geração mais rápida (75 vs 45 t/s) ao custo de reduzir pela metade a janela de contexto média de 80 K para 40 K. A velocidade de ingestão do prompt diminui de 200 para ~150 t/s porque o MTP requer transferências de dispositivo para host durante a fase de pré-preenchimento.
Cache KV q5
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Padrão (IQ3_XXS) | |
|---|---|---|---|---|---|
| Velocidade de Prompt | 145 t/s | 144 t/s | 141 t/s | 139 t/s | 191 t/s |
| Velocidade de Geração | 57 t/s | 62 t/s | 67 t/s | 66 t/s | 41 t/s |
| Ctx Médio | 70 K | 60 K | 60 K | 50 K | 130 K |
| Ctx Máx | 100 K | 100 K | 90 K | 80 K | 160 K |
Mudar para o cache KV q5 recupera um contexto significativo: --spec-draft-n-max 1 fornece 70 K de contexto médio a 57 t/s — uma aceleração de 39 % na geração em relação à decodificação padrão, mantendo a janela de contexto em um tamanho útil. Com --spec-draft-n-max 3, o contexto cai para 60 K, mas a geração atinge 67 t/s (+63 %).
Conclusão para Qwen 3.6 27B
O MTP é genuinamente útil para o modelo denso de 27B. O ponto ideal em 16 GB de VRAM é:
- KV q8 +
--spec-draft-n-max 2— melhor velocidade bruta (75 t/s), contexto reduzido para 40–60 K - KV q5 +
--spec-draft-n-max 1— melhor equilíbrio entre velocidade e contexto (57 t/s, 70 K de contexto médio)
Qwen 3.6 35B MTP vs Padrão
O modelo de 35B é uma arquitetura Mixture-of-Experts (MoE) (35B-A3B significa 35B de parâmetros totais, ~3B ativos por token). Modelos MoE geralmente se beneficiam mais do MTP porque o roteamento esparsos mantém a cabeça MTP computacionalmente barata em relação a uma passagem de frente completa.
Cache KV q8
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Padrão (IQ3_S) | |
|---|---|---|---|---|---|
| Velocidade de Prompt | 277 t/s | 277 t/s | 265 t/s | 275 t/s | 368 t/s |
| Velocidade de Geração | 186 t/s | 189 t/s | 180 t/s | 171 t/s | 146 t/s |
| Ctx Médio | 15 K | 10 K | — | — | 80 K |
| Ctx Máx | 80 K | 70 K | 60 K | 50 K | 150 K |
A arquitetura MoE entrega uma velocidade bruta de geração impressionante com MTP (+27 % no max 1, +29 % no max 2 em relação aos 146 t/s do padrão). Mas o problema prático é o contexto médio. Com cache KV q8, mesmo --spec-draft-n-max 1 fornece apenas 15 K de contexto médio — mal suficiente para tarefas modestas. Profundidades de rascunho mais altas não têm nenhum contexto médio viável em uma placa de 16 GB.
Esta é a questão central do custo de VRAM para o MTP em hardware de consumo: os buffers de rascunho extras consomem diretamente o orçamento de VRAM restante, e o modelo 35B-A3B com cache KV q8 deixa muito pouco espaço de folga.
Cache KV q5
| MTP max 1 | MTP max 2 | MTP max 3 | MTP max 4 | Padrão (IQ3_S) | |
|---|---|---|---|---|---|
| Velocidade de Prompt | 264 t/s | 266 t/s | 270 t/s | 264 t/s | 343 t/s |
| Velocidade de Geração | 151 t/s | 147 t/s | 137 t/s | 131 t/s | 122 t/s |
| Ctx Médio | 10 K | — | — | — | 120 K |
| Ctx Máx | 120 K | 110 K | 110 K | 80 K | 200 K |
O cache KV q5 apenas melhora marginalmente a situação do contexto médio. --spec-draft-n-max 1 fornece 10 K de contexto médio a 151 t/s. A decodificação padrão em q5 fornece 122 t/s com 120 K de contexto médio.
Conclusão para Qwen 3.6 35B
Em uma GPU de 16 GB, o modelo MoE de 35B com MTP enfrenta uma barreira rígida: o contexto utilizável médio colapsa para 10–15 K de tokens, tornando-o impraticável para cargas de trabalho reais. A decodificação padrão a 122–146 t/s com 80–120 K de contexto é significativamente mais útil.
Se você tiver 24 GB+ de VRAM, a combinação de 35B + MTP se torna muito mais atraente — o problema da janela de contexto desaparece e você mantém o benefício de velocidade.
Escolhendo o Valor Correto de --spec-draft-n-max
A questão de quantos tokens especulativos propor por etapa (--spec-draft-n-max) não tem uma única resposta certa — depende tanto da arquitetura do modelo quanto da VRAM disponível:
- Para 27B denso em 16 GB:
--spec-draft-n-max 2com KV q8 é o mais rápido,--spec-draft-n-max 1com KV q5 é o mais amigável ao contexto. - Para 35B MoE em 16 GB:
--spec-draft-n-max 1é a única opção que mantém qualquer contexto utilizável e, mesmo assim, apenas marginalmente. - Valores mais altos (
3,4) aumentam a pressão de VRAM sem ganhos de velocidade proporcionais — no max 4, você está gastando aproximadamente a mesma VRAM extra que no max 2, mas a velocidade de geração não acompanha.
Como Habilitar MTP no llama.cpp
Certifique-se de usar um GGUF habilitado para MTP (o nome do arquivo contém MTP). Se você é novo nas bandeiras do llama.cpp, o Início Rápido do llama.cpp com CLI e Servidor cobre todos os fundamentos. Em seguida, inicie o llama-server ou llama-cli com:
llama-server \
  --model Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf \
  --ctx-size 40000 \
  -ngl 99 --flash-attn on \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --spec-type draft-mtp \
  --spec-draft-n-max 2
Para cache KV q5, substitua q8_0 por q5_1 ou q5_0 e ajuste --ctx-size para cima:
llama-server \
  --model Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf \
  --ctx-size 80000 \
  -ngl 99 --flash-attn on \
  --cache-type-k q5_1 --cache-type-v q5_1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 1
O MTP é ativado automaticamente quando o llama.cpp vê as cabeças MTP no arquivo GGUF e --spec-type draft-mtp está definido.
Portanto, o Qwen3.6-27B-UD-IQ3_XXS.gguf padrão não funcionará no modo MTP; você precisará do Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf.
Mas o Qwen3.6-27B-UD-IQ3_XXS-MTP.gguf pode funcionar tanto no modo de decodificação especulativa quanto no autorregressivo.
Conclusão
Em uma GPU de 16 GB (RTX 4080), com essas quantizações, o MTP do llama.cpp é uma clara vitória para o Qwen 3.6 27B e um resultado líquido negativo para o Qwen 3.6 35B no uso prático:
Qwen 3.6 27B (IQ3_XXS) — MTP vale a pena:
- KV q8 + MTP max 2 → ~67 % de geração mais rápida, contexto 40–60 K (vs 80–100 K sem MTP)
- KV q5 + MTP max 1 → ~39 % de geração mais rápida, contexto 70–100 K (vs 130–160 K sem MTP)
- Bom equilíbrio entre velocidade e eficiência de VRAM em
--spec-draft-n-max 2
Qwen 3.6 35B (IQ3_S) — MTP não é prático em 16 GB:
- A velocidade de geração é 27–29 % maior, mas o contexto médio colapsa para 10–15 K em q8, 10 K em q5
- A decodificação padrão a 122–146 t/s com 80–120 K de contexto é mais útil para tarefas reais
- A situação melhora substancialmente em 24 GB+ de VRAM
No papel, o cache KV q5 é a resposta óbvia para maximizar a janela de contexto mantendo os ganhos de velocidade do MTP — mas, na prática, a queda de qualidade ao passar de q8 para q5 pode ser significativa. Teste o q5 nas suas próprias tarefas antes de adotá-lo; para as minhas cargas de trabalho, a degradação foi inaceitável, e o q8 com um orçamento de contexto mais apertado permanece sendo o melhor compromisso.
Para uma visão mais ampla das opções de serviço de LLM e dos compromissos de infraestrutura, veja o pilar Hospedagem de LLM em 2026 e Desempenho de LLM em 2026. Onde essa classe de 27B se posiciona no espectro de tamanho e custo de 2026, e por que um build atual de Qwen3.8-27B Q4 deseja um cartão de 24 GB enquanto as medições acima permanecem em 16 GB, está em A Fronteira Eficiente dos Modelos Abertos em 2026. Se você está ajustando as configurações do amostrador do Qwen 3.6 ao lado do MTP, a Referência de Parâmetros de Inferência Agêntica para Qwen 3.6 e Gemma 4 é um companheiro útil.
