
Ollama 新バージョン v0.12.1 におけるメモリ割り当てとモデルスケジューリング
オラマモデルのスケジューリングに関する自分のテスト
ここでは、新しいバージョンのOllamaがモデルに対してどのくらいのVRAMを割り当てているかについて、Ollama VRAM割り当てと以前のOllamaバージョンを比較しています。新しいバージョンは、以前のバージョンよりも劣っています。
オラマモデルのスケジューリングに関する自分のテスト
ここでは、新しいバージョンのOllamaがモデルに対してどのくらいのVRAMを割り当てているかについて、Ollama VRAM割り当てと以前のOllamaバージョンを比較しています。新しいバージョンは、以前のバージョンよりも劣っています。
Ollama開発の現状についての私の見解
Ollamaは、LLM(大規模言語モデル)をローカルで実行するための最も人気のあるツールの一つに急速に成長しました。 そのシンプルなCLIと、洗練されたモデル管理は、クラウド外でAIモデルを扱いたい開発者にとって、定番の選択肢となっています。
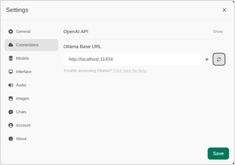
2025年のOllamaで最も注目されているUIの概要
ローカルにホストされた Ollama は、あなたのマシン上で大規模言語モデルを実行できるが、コマンドライン経由での使用はユーザーにとって使いにくい。
以下に、ローカルの Ollama に接続するための、いくつかのオープンソースプロジェクトが提供する ChatGPTスタイルのインターフェース がある。
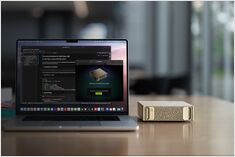
2025 年 7 月にもまもなく利用可能となるでしょう。
Nvidia 社がNVIDIA DGX Sparkの発売を控えています。これは Blackwell アーキテクチャを採用した小型 AI スーパーコンピュータで、128GB 以上の統一メモリと 1 PFLOPS の AI 性能を備えています。LLM を実行するに最適なデバイスです。

GOにおけるMCP仕様と実装に関する長文記事
ここに、モデルコンテキストプロトコル(MCP)の説明が示されています。MCPサーバーの実装方法の短いノート(GoでのMCPサーバーの実装)も含まれており、メッセージ構造やプロトコル仕様についても記載されています。
RAG を実装中ですか?Go のコードスニペットを紹介 - 2 部目
標準の Ollama には直接的なリランク API がないため、クエリ - ドキュメントペアのエンベッディングを生成してスコアリングを行うことで、Go 言語による Qwen3 Reranker を使ったリランキング を実装する必要があります。
Qwen3 8B、14Bおよび30B、Devstral 24B、Mistral Small 24B
このテストでは、Ollama上でホストされているさまざまなLLMがHugoページを英語からドイツ語に翻訳する方法を比較しています。英語からドイツ語への翻訳。
RAG の実装ですね。Golang 用のコードスニペットをいくつか紹介します。
この小さな Reranking Go コード例は、クエリと各候補ドキュメントの埋め込みを生成するために Ollama を呼び出し、 その後、コサイン類似度で降順にソートします。

Ollama で利用可能な新しい素晴らしい LLM
Qwen3 埋め込みモデルとreranker モデル は、Qwen ファミリー最新リリースであり、高度なテキスト埋め込み、検索、再ランク付けタスクに特じて設計されています。
LLMのために2枚目のGPUを追加する予定はありますか?
PCIeレーン数がLLMのパフォーマンスに与える影響? タスクによって異なります。トレーニングやマルチGPU推論では、パフォーマンスの低下が顕著です。
LLMでHTMLからテキストを抽出する...
Ollama モデルライブラリには、HTML コンテンツを Markdown に変換できるモデルが存在します。これはコンテンツ変換タスクに役立ちます。このガイドは、2026年のドキュメンテーションツール: Markdown、LaTeX、PDFおよび印刷ワークフロー ハブの一部です。
「あなたのタスクには、どのAIリサーチモードが適していますか?」
Cursor AI vs GitHub Copilot vs Cline AI vs…
ここでは、AI支援コーディングツールやAIコーディングアシスタントとその優れた点についていくつか紹介します。
LLMプロバイダーの短いリスト
LLMを使用することは非常に高価ではありません。新しい高性能なGPUを購入する必要がないかもしれません。LLMプロバイダーの一覧は、クラウド上のLLMプロバイダー で確認できます。それぞれが提供しているLLMについても記載されています。
インテルCPUにおけるOllamaの効率的なコアとパフォーマンスコアの比較
私はある仮説をテストしたいと思っています。すなわち、「インテルCPUのすべてのコアを活用することで、LLMの速度が向上するか?」というものです。このテストについては、ALL cores on Intel CPU would raise the speed of LLMs?をご覧ください。
新しいgemma3 27bitモデル(gemma3:27b、ollama上では17GB)が私のGPUの16GB VRAMに収まらず、部分的にCPU上での実行に頼っているという点が気になります。
AIは大量の電力を必要とする...
現代の混乱の最中、私は AI タスクに適した 異なるグラボの仕様を比較 しています (ディープラーニング, オブジェクト検出 および LLM)。 ただし、これらはすべて非常に高価です。