
vLLM クイックスタート:高パフォーマンスなLLMサービング - 2026年版
2026年のvLLMのインストール、サービング、およびチューニング
vLLMは、UC BerkeleyのSky Computing Labが開発した、大規模言語モデル(LLM)向けの高スループットでメモリ効率の良い推論・サービングエンジンです。
2026年のvLLMのインストール、サービング、およびチューニング
vLLMは、UC BerkeleyのSky Computing Labが開発した、大規模言語モデル(LLM)向けの高スループットでメモリ効率の良い推論・サービングエンジンです。
オーストラリアの小売業者から、リアルなオーストラリアドルでの価格を今すぐ。
NVIDIA DGX Spark (GB10 Grace Blackwell) は、主要な PC 小売店に国内在庫があり、オーストラリアで入手可能 となっています。 世界的な DGX Spark の価格と入手性 を追いかけていただいている方なら、オーストラリアでの価格帯はストレージ構成や小売店によって 6,249 オーストラリアドルから 7,999 オーストラリアドル であることが、ご関心をお持ちいただけるでしょう。
AI生成コンテンツの検出に関する技術ガイド
AI生成コンテンツの増加により、新たな課題が生じています。それは、本物の人の書き方と「AIスロップ」(https://www.glukhov.org/ja/post/2025/12/ai-slop-detection/ “AIスロップ”)を区別することです。AIスロップとは、低品質で大量生産された合成テキストのことです。
ローカルLLMを使用してCogneeをテストする - 実際の結果
CogneeはPythonフレームワークで、LLMを使用してドキュメントから知識グラフを構築します。 しかし、これはセルフホストされたモデルと互換性がありますか?
BAMLとInstructorによる型安全なLLM出力
プロダクション環境で大規模言語モデル(LLM)を扱う際、構造化され、型安全性のある出力を得ることが極めて重要です。 この問題の解決策として、2つの人気フレームワーク—BAMLとInstructor—がそれぞれ異なるアプローチを採用しています。
LLMを自社でホストするCogneeについての考察
Best LLM for Cognee を選ぶ際には、グラフ構築の質、幻覚率、ハードウェアの制約のバランスが求められます。
Cognee は、Ollama を介して 32B 以上の低幻覚モデルで優れた性能を発揮しますが、軽量な設定では中規模のオプションも使用可能です。
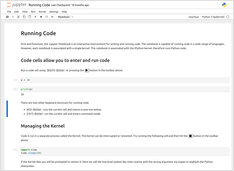
必須のショートカットとマジックコマンド
Jupyter Notebookの生産性を飛躍的に向上させるために、データサイエンスおよび開発体験を変革するための必須のショートカット、マジックコマンド、ワークフローのヒントをご活用ください。

PythonとOllamaでAI検索エージェントを構築する
OllamaのPythonライブラリには、今やネイティブのOllama ウェブ検索機能が搭載されました。わずか数行のコードで、ウェブからのリアルタイム情報をローカルのLLMに追加することで、ハルシネーション(幻覚)を減らし、精度を向上させることができます。
RAG スタックに適したベクター DB を選択しましょう
適切な ベクトルストア を選択することは、RAG アプリケーションのパフォーマンス、コスト、スケーラビビリティを決定づけます。この包括的な比較では、2024-2025 年における最も人気のあるオプションを取り上げています。
GoとOllamaでAI検索エージェントを構築する
OllamaのWeb検索APIにより、ローカルLLMにリアルタイムのWeb情報を付加できます。このガイドでは、シンプルなAPI呼び出しからフル機能の検索エージェントまで、GoでのWeb検索機能の実装方法を示します。
AI 需要による供給圧迫で、メモリ価格が 163〜619% 急騰
2025 年後半、メモリ市場は前例のない価格変動に直面しており、すべてのセグメントにおいて RAM 価格の高騰 が顕著です。
2026年の優れたローカルLLMホスティングツールを比較します。APIの成熟度、ハードウェアサポート、ツールコール機能、そして実用例です。
ローカルでLLM(大規模言語モデル)を動かすことは、現在、開発者、スタートアップ、さらにはエンタープライズのチームにとって現実的な選択肢となっています。 しかし、適切なツールの選択——Ollama、vLLM、LM Studio、LocalAI、あるいはそれ以外のツール——は、あなたの目標によって異なります。
Goマイクロサービスで堅牢なAI/MLパイプラインを構築する
AIおよびMLワークロードがますます複雑化するにつれて、堅牢なオーケストレーションシステムの必要性が高まっています。 Goのシンプルさ、パフォーマンス、並行処理能力は、モデル自体がPythonで記述されていても、MLパイプラインのオーケストレーション層の構築に理想的な選択肢となります。
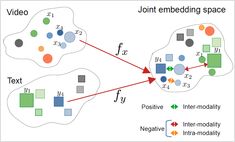
テキスト、画像、音声を共有された埋め込み空間に統一する
クロスモーダル埋め込みは、人工知能において画期的な進展をもたらし、統一された表現空間内で異なるデータタイプ間の理解と推論を可能にします。
オープンモデルを活用して、予算内のハードウェアでエンタープライズAIをデプロイする
AI の民主化はここにやってきました。 Llama、Mistral、Qwen などのオープンソース大規模言語モデル(LLM)が現在、プロプライエタリなモデルと競合するレベルに達しており、チームは 消費级ハードウェアを使用した AI インフラストラクチャ を構築することで、コストを削減しながらもデータプライバシーとデプロイの完全な制御を維持することが可能になりました。
LongRAG、Self-RAG、GraphRAG - 次世代の技術
検索拡張生成(RAG) は、単純なベクター類似度検索を大きく超えた進化を遂げています。 LongRAG、Self-RAG、GraphRAGは、これらの機能の最先端を代表しています。