Prueba del modelo de lenguaje OpenCode: estadísticas de codificación y precisión
He probado cómo funciona OpenCode con varios LLM alojados localmente en Ollama y llama.cpp, y para comparar, he añadido algunos modelos gratuitos de OpenCode Zen.
Conozca a Sisyphus y su equipo de agentes especializados.
El mayor salto de capacidad en OpenCode proviene de los agentes especializados: la separación deliberada de la orquestación, la planificación, la ejecución y la investigación.
OpenHands es una plataforma de código abierto e agnóstica a modelos para agentes de desarrollo de software impulsados por IA.
Permite que un agente se comporte más como un compañero de codificación que como una simple herramienta de autocompletado.
Ejecuta APIs compatibles con OpenAI de forma autohospedada con LocalAI en minutos.
LocalAI es un servidor de inferencia autohospedado y local-first diseñado para comportarse como una API de OpenAI de reemplazo directo para ejecutar cargas de trabajo de IA en tu propio hardware (portátil, estación de trabajo o servidor local).
llama.cpp es un motor de inferencia en C/C++ para modelos GGUF: llama-cli para chat interactivo, llama-completion para prompts guiados por guion, y llama-server para una API HTTP compatible con OpenAI.
La Inteligencia Artificial está transformando la forma en que el software se escribe, revisa, despliega y mantiene. Desde asistentes de código basados en IA hasta automatización GitOps y flujos de trabajo de DevOps, los desarrolladores ahora confían en herramientas con IA en todo el ciclo de vida del software.
OpenCode es un agente de codificación con IA de código abierto que puedes ejecutar en la terminal (TUI + CLI) con superficies opcionales de escritorio e IDE. Este es el Inicio rápido de OpenCode: instalación, verificación, conexión de un modelo/proveedor y ejecución de flujos de trabajo reales (CLI + API).
La inferencia de LLM parece ser “solo otra API” hasta que se producen picos de latencia, las colas se saturan y tus GPUs se mantienen al 95% de uso de memoria sin una explicación obvia.
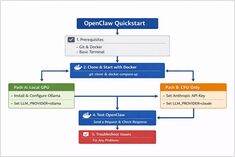
OpenClaw es un asistente de IA autoalojado diseñado para ejecutarse con entornos de ejecución de LLM locales como Ollama o con modelos basados en la nube como Claude Sonnet.
Construye flujos de trabajo en Go con el SDK de Temporal
Temporal es un motor de flujos de trabajo de código abierto y nivel empresarial que permite a los desarrolladores crear aplicaciones de flujo de trabajo duraderas, escalables y tolerantes a fallos, utilizando lenguajes de programación familiares como Go.
Estrategia de observabilidad integral para la inferencia de LLM y aplicaciones de LLM
Los sistemas de LLM fallan de maneras que la monitorización de APIs tradicional no puede detectar: las colas se llenan en silencio, la memoria de la GPU se satura mucho antes de que la CPU parezca estar ocupada, y la latencia se dispara en la capa de agrupamiento (batching) en lugar de en la capa de aplicación.
Métricas, paneles, registros y alertas para sistemas en producción: Prometheus, Grafana, Kubernetes y cargas de trabajo de IA.
Observabilidad es la base de los sistemas de producción confiables.
Sin métricas, paneles de control y alertas, los clústeres de Kubernetes se desvían, las cargas de trabajo de IA fallan en silencio y las regresiones de latencia pasan desapercibidas hasta que los usuarios se quejan.
De RAG básico a producción: fragmentación, búsqueda vectorial, reordenamiento y evaluación en una sola guía.
Production-focused guide to building RAG systems: chunking, vector stores, hybrid retrieval, reranking, evaluation, and when to choose RAG over fine-tuning.
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.
A performance engineering hub for running LLMs efficiently: runtime behavior, bottlenecks, benchmarks, and the real constraints that shape throughput and latency.