LLM Performance

KV Cache en GPUs de 16 GB: Cómo hacer que el contexto largo realmente quepa

KV Cache en GPUs de 16 GB: Cómo hacer que el contexto largo realmente quepa

Por qué el contexto de 128K falla con 16 GB

Un modelo puede publicitar una ventana de contexto de 128K y aun así fallar en 40K tokens en una GPU de 16 GB. El límite de la arquitectura nunca prometió que los pesos, la caché KV, los búferes de cálculo y el compositor del escritorio cabrían en tu tarjeta al mismo tiempo.

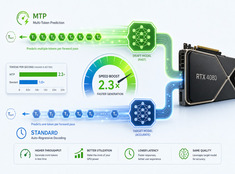
Decodificación especulativa: inferencia de LLM 20-50 % más rápida

Decodificación especulativa: inferencia de LLM 20-50 % más rápida

Inferencia más rápida de LLM sin pérdida de calidad: una guía práctica

Un modelo de 70B genera un token por pasada hacia adelante (forward pass), y cada pasada recarga los pesos desde la VRAM, calcula la atención a través del contexto y sincroniza la memoria. Entre tokens, la GPU se queda inactiva mientras espera a que se resuelvan las dependencias secuenciales.

BAML vs Instructor: Salidas estructuradas de LLM

BAML vs Instructor: Salidas estructuradas de LLM

Salidas de LLMs con verificación de tipos mediante BAML e Instructor

Al trabajar con modelos de lenguaje grandes (LLM) en producción, obtener salidas estructuradas y seguras en cuanto a tipos es fundamental. Dos marcos de trabajo populares, BAML e Instructor, adoptan enfoques diferentes para resolver este problema.

Los ASICs de LLM y los chips especializados para inferencia (por qué son importantes)

Los ASICs de LLM y los chips especializados para inferencia (por qué son importantes)

Los ASIC y los circuitos de silicio personalizados aumentan la velocidad y la eficiencia de la inferencia de LLM.

El futuro de la IA no se trata solo de modelos más inteligentes, sino de modelos capaces de razonar. También se trata del silicio que se adapta a la forma en que esos modelos se sirven realmente. El hardware especializado para la inferencia de LLM sigue un camino reminiscente de la transición de la minería de Bitcoin de las GPU a las ASIC diseñadas a medida, solo que con restricciones más duras porque los modelos y las recetas de precisión continúan evolucionando.