Ai

Cómo migrar de OpenClaw a Hermes Agent de forma segura

Cómo migrar de OpenClaw a Hermes Agent de forma segura

Un cambio seguro más allá de la importación de una sola línea

Migrar un asistente de IA no es lo mismo que copiar la configuración de una aplicación. La parte difícil consiste en preservar la identidad, la memoria, el comportamiento de las herramientas, las tareas programadas y el acceso a los mensajes, evitando que dos pasarelas actúen como el mismo bot.

Habilidades de agentes vs servidores MCP: marco de decisión

Habilidades de agentes vs servidores MCP: marco de decisión

¿Habilidad, servidor MCP o ambos?

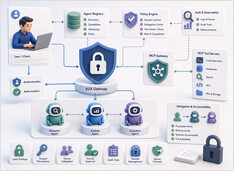
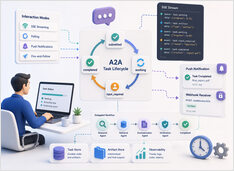
Las habilidades de agentes y los servidores MCP suelen presentarse como formas competidoras de extender un agente de IA. Esa interpretación es incorrecta: una habilidad enseña al agente cómo trabajar, mientras que un servidor MCP le otorga acceso controlado a capacidades en vivo.

Gravedad de los datos: el verdadero coste de la IA API-first

Gravedad de los datos: el verdadero coste de la IA API-first

Por qué su stack de IA se vuelve más dependiente cada mes.

Cada llamada a la API parece una transacción sencilla, hasta que se acumulan lo suficiente como para que tus datos de ajuste fino, tus entornos de evaluación y tus esquemas de herramientas se adapten a un solo proveedor, momento en el cual cambiar deja de ser un ajuste de enrutamiento.

Subagentes de Claude Code: configuración, configuración y cuándo usarlos

Subagentes de Claude Code: configuración, configuración y cuándo usarlos

Delega el trabajo ruidoso y mantén tu contexto limpio.

La mayoría de las sesiones de Claude Code se vuelven lentas y desordenadas por la misma razón: cada búsqueda exploratoria con grep, cada volcado de registros y cada “déjame revisar un archivo más” permanece en la conversación principal para siempre.

De Ollama a vLLM: cuándo migrar tu servidor local de LLM

De Ollama a vLLM: cuándo migrar tu servidor local de LLM

Cuándo migrar de Ollama a vLLM

Ollama es una de las formas más sencillas de ejecutar un modelo de lenguaje local, pero la comodidad puede ocultar el momento en que un experimento local se convierte en un servicio de inferencia compartido que necesita una mejor planificación y observabilidad.

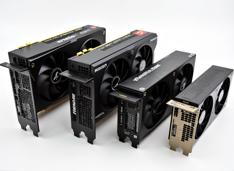
GPU para IA en 2026: NVIDIA, AMD e Intel comparadas

GPU para IA en 2026: NVIDIA, AMD e Intel comparadas

Comparativa de GPUs de IA entre tres proveedores

El panorama del hardware para IA ha cambiado significativamente en 2026, con NVIDIA, AMD e Intel compitiendo por los desarrolladores que necesitan GPUs capaces de ejecutar modelos de lenguaje grandes (LLM) locales y cargas de trabajo de inferencia de IA.

Decodificación especulativa: inferencia de LLM 20-50 % más rápida

Decodificación especulativa: inferencia de LLM 20-50 % más rápida

Inferencia más rápida de LLM sin pérdida de calidad: una guía práctica

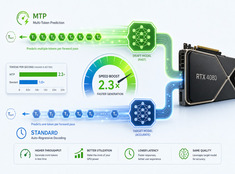
Un modelo de 70B genera un token por pasada hacia adelante (forward pass), y cada pasada recarga los pesos desde la VRAM, calcula la atención a través del contexto y sincroniza la memoria. Entre tokens, la GPU se queda inactiva mientras espera a que se resuelvan las dependencias secuenciales.