Plugins de SEO para WordPress: de Yoast a la IA local
Los complementos de SEO para WordPress añaden metadatos, mapas del sitio, esquema (schema) y la capa de IA sobre el núcleo de WordPress, y en 2026 esa capa incluye complementos que ejecutan inferencia en tu propio hardware.
SEO de código abierto más allá de los complementos de WordPress
El SEO autoalojado ahora abarca rastreadores, paneles de Search Console, seguidores de posicionamiento, servidores MCP y IA local. Esta guía compara las principales plataformas de código abierto y qué funciones funcionan sin APIs de SEO de pago.
Agentes autoalojados que investigan más allá de la búsqueda
Deep Research se ha convertido en su propia categoría de software, y no es simplemente un modelo apuntado a una caja de búsqueda. Este artículo compara doce sistemas autoalojados y las arquitecturas de investigación detrás de ellos.
Ollama y llama.cpp a menudo se comparan como si fueran motores de inferencia rivales. La elección real es entre un servicio de modelos gestionado y un conjunto de herramientas que operas directamente.
ROCm y Vulkan aceleran tanto las GPU de AMD para el alojamiento local de LLM, pero no son intercambiables. La elección correcta depende del motor, la GPU y la carga de trabajo.
Un modelo puede publicitar una ventana de contexto de 128K y aun así fallar en 40K tokens en una GPU de 16 GB. El límite de la arquitectura nunca prometió que los pesos, la caché KV, los búferes de cálculo y el compositor del escritorio cabrían en tu tarjeta al mismo tiempo.
«Por qué tu pila de IA se vuelve más pegajosa cada mes.»
Cada llamada a una API se siente como una transacción simple… hasta que se acumulan tantas que tus datos de afinamiento, tus arneses de evaluación y tus esquemas de herramientas quedan moldeados en torno a un solo proveedor, y cambiar deja de ser un simple cambio de ruteo.
Ollama es una de las formas más sencillas de ejecutar un modelo de lenguaje local, pero la comodidad puede ocultar el momento en que un experimento local se convierte en un servicio de inferencia compartido que necesita una mejor planificación y observabilidad.
Vane es una de las entradas más pragmáticas en el espacio de “búsqueda de IA con citas”: un motor de respuestas autoalojado que combina la recuperación en tiempo real de la web con LLMs locales o en la nube, manteniendo toda la pila bajo tu control.
Ollama funciona mejor cuando se trata como un demonio local: la CLI y sus aplicaciones se comunican con una API HTTP de bucle local, y el resto de la red nunca descubre su existencia.
Servidor de Ollama con enfoque en composición, GPU y persistencia.
Ollama funciona muy bien en hardware sin intermediarios (bare metal). Se vuelve aún más interesante cuando lo tratas como un servicio: un punto de conexión estable, versiones fijas, almacenamiento persistente y una GPU que está disponible o no está.
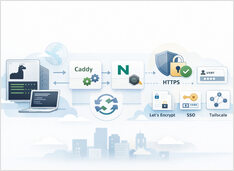
HTTPS con Ollama sin interrumpir las respuestas en streaming.
Ejecutar Ollama detrás de un proxy inverso es la forma más sencilla de obtener HTTPS, control de acceso opcional y un comportamiento de transmisión predecible.
Incrustaciones RAG: Python, Ollama y las APIs de OpenAI.
Si estás trabajando en generación aumentada con recuperación (RAG), esta sección explica los incrustados de texto (text embeddings) en términos sencillos: qué son, cómo se integran en la búsqueda y la recuperación, y cómo llamar a dos configuraciones locales comunes desde Python usando Ollama o una API HTTP compatible con OpenAI (como la que exponen muchos servidores basados en llama.cpp).
Prueba del modelo de lenguaje OpenCode: estadísticas de codificación y precisión
He probado cómo funciona OpenCode con varios LLM alojados localmente en Ollama y llama.cpp, y para comparar, he añadido algunos modelos gratuitos de OpenCode Zen.
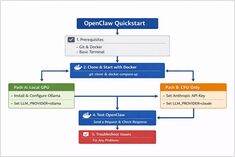
OpenClaw es un asistente de IA autoalojado diseñado para ejecutarse con entornos de ejecución de LLM locales como Ollama o con modelos basados en la nube como Claude Sonnet.
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.