Selfhosting

Comparativa de plugins SEO para WordPress: de Yoast a la IA local

Comparativa de plugins SEO para WordPress: de Yoast a la IA local

Plugins de SEO para WordPress: de Yoast a la IA local

Los complementos de SEO para WordPress añaden metadatos, mapas del sitio, esquema (schema) y la capa de IA sobre el núcleo de WordPress, y en 2026 esa capa incluye complementos que ejecutan inferencia en tu propio hardware.

Herramientas y plataformas de SEO autoalojadas: guía de código abierto

Herramientas y plataformas de SEO autoalojadas: guía de código abierto

SEO de código abierto más allá de los complementos de WordPress

El SEO autoalojado ahora abarca rastreadores, paneles de Search Console, seguidores de posicionamiento, servidores MCP y IA local. Esta guía compara las principales plataformas de código abierto y qué funciones funcionan sin APIs de SEO de pago.

Bucles de memoria autorreforzantes en agentes de IA: causas y soluciones

Bucles de memoria autorreforzantes en agentes de IA: causas y soluciones

«Cuando las conclusiones recordadas se convierten en nueva evidencia».

La memoria persistente convierte a un agente de una herramienta que requiere explicaciones constantes en uno que transporta el contexto hacia adelante, pero abre un modo de fallo que el chat sin estado evita: una interpretación puede convertirse en memoria, ser recuperada como hecho y justificar una versión más fuerte de sí misma.

Mnemosyne para Hermes Agent: guía de inicio rápido de memoria local

Mnemosyne para Hermes Agent: guía de inicio rápido de memoria local

Memoria local de Hermes con escrituras controladas.

Mnemosyne es un proveedor de memoria local-first para Hermes Agent, que almacena memoria de trabajo, hechos estructurados, datos temporales e historial episódico en SQLite local: sin servicios alojados, sin llamadas de red obligatorias y con un control de escritura inusualmente granular.

Cómo migrar de OpenClaw a Hermes Agent de forma segura

Cómo migrar de OpenClaw a Hermes Agent de forma segura

Un cambio seguro más allá de la importación de una sola línea

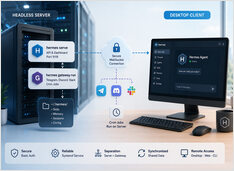
Migrar un asistente de IA no es lo mismo que copiar la configuración de una aplicación. La parte difícil consiste en preservar la identidad, la memoria, el comportamiento de las herramientas, las tareas programadas y el acceso a los mensajes, evitando que dos pasarelas actúen como el mismo bot.

KV Cache en GPUs de 16 GB: Cómo hacer que el contexto largo realmente quepa

KV Cache en GPUs de 16 GB: Cómo hacer que el contexto largo realmente quepa

Por qué el contexto de 128K falla con 16 GB

Un modelo puede publicitar una ventana de contexto de 128K y aun así fallar en 40K tokens en una GPU de 16 GB. El límite de la arquitectura nunca prometió que los pesos, la caché KV, los búferes de cálculo y el compositor del escritorio cabrían en tu tarjeta al mismo tiempo.

Gravedad de los datos: el verdadero costo de la IA con enfoque en la API

Gravedad de los datos: el verdadero costo de la IA con enfoque en la API

«Por qué tu pila de IA se vuelve más pegajosa cada mes.»

Cada llamada a una API se siente como una transacción simple… hasta que se acumulan tantas que tus datos de afinamiento, tus arneses de evaluación y tus esquemas de herramientas quedan moldeados en torno a un solo proveedor, y cambiar deja de ser un simple cambio de ruteo.

GPU para IA en 2026: NVIDIA, AMD e Intel comparadas

GPU para IA en 2026: NVIDIA, AMD e Intel comparadas

Comparativa de GPUs de IA entre tres proveedores

El panorama del hardware para IA ha cambiado significativamente en 2026, con NVIDIA, AMD e Intel compitiendo por los desarrolladores que necesitan GPUs capaces de ejecutar modelos de lenguaje grandes (LLM) locales y cargas de trabajo de inferencia de IA.