
Contexto jerárquico: una jerarquía del conocimiento para agentes de IA
Jerarquía de conocimiento de cinco capas para la memoria del agente.
Un agente con un único archivo de memoria plana no olvida las cosas; su problema es que no puede dejar de recordar información sobre la que no se le ha preguntado. La solución es un contexto estratificado, donde cada capa de conocimiento entra a través de un disparador diferente.
El modo de fallo no es el olvido, sino lo contrario. En un almacén único, todos los hechos residen en el mismo lugar, entran en el contexto de la misma manera y, por lo tanto, están disponibles de la misma manera: siempre. Pregunta al agente sobre un correo de un cliente y este narra la configuración del router mientras redacta la respuesta; pídele que solucione un problema en un servicio y menciona la tarifa de patrocinio cotizada el mes pasado. La pila de memoria es un monolito: cualquier cambio en un área de interés afecta a todas las demás, y el radio de impacto de cada consulta es todo el corpus.
El consejo estándar es conductual: enseñar al agente qué es relevante para el tema actual. Eso es el equivalente en software de escribir “por favor, tenga cuidado” en una portante de carga — el agente puede ser instruido y, en su mayoría, será complaciente, hasta el día en que no lo sea. La alternativa estructural es el conocimiento que no puede entrar en una conversación a menos que la actividad que lo necesite ya esté ocurriendo. Este artículo define esa estructura como una jerarquía de conocimiento de cinco capas — qué es cada capa, qué dispara su inyección, qué pertenece a ella y dónde falla — y la aplica a una configuración concreta de múltiples dominios: un perfil general, uno para un homelab, uno para asuntos personales, uno para el trabajo y uno para la educación.
Nombrando la jerarquía
No existe un único término estándar de la industria, por lo que la definición aquí es explícita. Una jerarquía de conocimiento es un arreglo estratificado de lo que el agente sabe, donde cada estrato difiere en tres propiedades: cómo entra en el contexto del modelo, qué tan grande se le permite ser y cuánto tiempo se espera que siga siendo correcto. En el nivel de arquitectura del conocimiento, los paradigmas vecinos — PKM, RAG, wikis y sistemas de memoria — se comparan en PKM vs RAG vs Wiki vs Sistemas de Memoria, y los contratos de tiempo de ejecución que los asistentes de IA implementan realmente se mapean en Sistemas de Memoria en Asistentes de IA. Ambos se encuentran dentro del clúster de Gestión del Conocimiento, que cubre los fundamentos, métodos y herramientas de los sistemas de conocimiento humano. Este artículo añade la clasificación basada en disparadores y el límite de perfil que hacen que la colocación sea aplicable.
Dos linajes explican la forma de la jerarquía.
El primero es la jerarquía de memoria de la CPU. Un procesador no almacena cada byte que podría necesitar en algún momento en el mismo registro. Tiene caché L1 — pequeño, siempre residente, accedido sin toma de decisiones —, L2, memoria principal y disco, donde cada capa es más grande, más lenta de alcanzar y se accede solo cuando las capas superiores no tienen la respuesta. La regla de diseño no es “mantener todo rápido”. Es la mayor parte de los datos rara vez importa; paga el costo de acceso solo cuando sí importa. Un agente con un único archivo de memoria plana es una CPU con todo amontonado en el L1: el archivo de registros es enorme, por lo que todo es visible, incluidos los bytes que la instrucción actual no solicitó. MemGPT hizo el mismo movimiento para los agentes, modelando la memoria como niveles con un movimiento explícito entre almacenes rápidos y lentos.
El segundo es la clasificación cognitiva de la memoria, que divide el conocimiento en memoria procedimental (cómo hacer las cosas), memoria semántica (hechos sobre el mundo) y memoria episódica (qué sucedió, cuándo, con quién). La clasificación importa porque los modos de fallo difieren según el tipo: el conocimiento procedimental que envejece es un error en tu flujo de trabajo, el conocimiento semántico que envejece es un hecho erróneo, y el conocimiento episódico que se filtra es un incidente de privacidad. Una jerarquía organizada por tipo de contenido, y no por ubicación, te dice qué fallos son peligrosos.
El eje organizativo para este artículo no es ninguno de los dos anteriores. Clasifica el conocimiento según qué causa que entre en el contexto. El disparador de inyección es el mecanismo, y el mecanismo es lo que realmente puedes hacer cumplir. Un sistema de agentes ofrece exactamente cuatro disparadores:
- Siempre. Inyectado en cada turno, incondicionalmente.
- Disparador de tarea. Cargado cuando la actividad actual coincide con una condición declarada.
- Recuerdo semántico. Superficial cuando el mensaje actual es similar a algo almacenado.
- Referencia explícita. Recuperado porque una tarea nombra el archivo o la consulta.
Cada capa de la jerarquía está definida por qué disparador la alimenta. Ese es todo el diseño, y el resto de este artículo es una elaboración de una sola tabla.
Las cinco capas
| Capa | Qué es | Disparador de inyección | Portador típico | Disciplina de tamaño | Falla como |
|---|---|---|---|---|---|
| 0 — Identidad | Quién es el agente, cómo habla, qué no hará | Siempre | SOUL.md o equivalente | Pequeña; cambia raramente | Inflación — la identidad se convierte en un almacén de hechos |
| 1 — Memoria residente | Hechos duraderos que aplican a cada sesión | Siempre | MEMORY.md / USER.md o equivalentes | Presupuesto en caracteres; densa en punteros | Monolito — los hechos de dominio migran hacia dentro |
| 2 — Procedimental | Cómo hacer tareas recurrentes, más dónde reside su dato | Disparador de tarea | Skills (Habilidades) | Limitada por skill; procedimientos, no datos | Creep de datos — los skills se convierten en bases de datos |
| 3 — Referencia | El sistema de registro: tablas, configuraciones, contratos, manuales | Referencia explícita | Archivos, wiki | Ilimitada; indexable, versionada | Desactualización — nadie actualiza el registro |
| 4 — Memoria recuperada | Hechos episódicos y relacionales: decisiones, intercambios, cambios de estado | Recuerdo semántico | Un backend de memoria con recuperación (p. ej., una tienda de vectores/grafos) | Presupuesto por recuperación; puntuable por etiquetas | Fuga — el recuerdo superficiea el dominio equivocado |
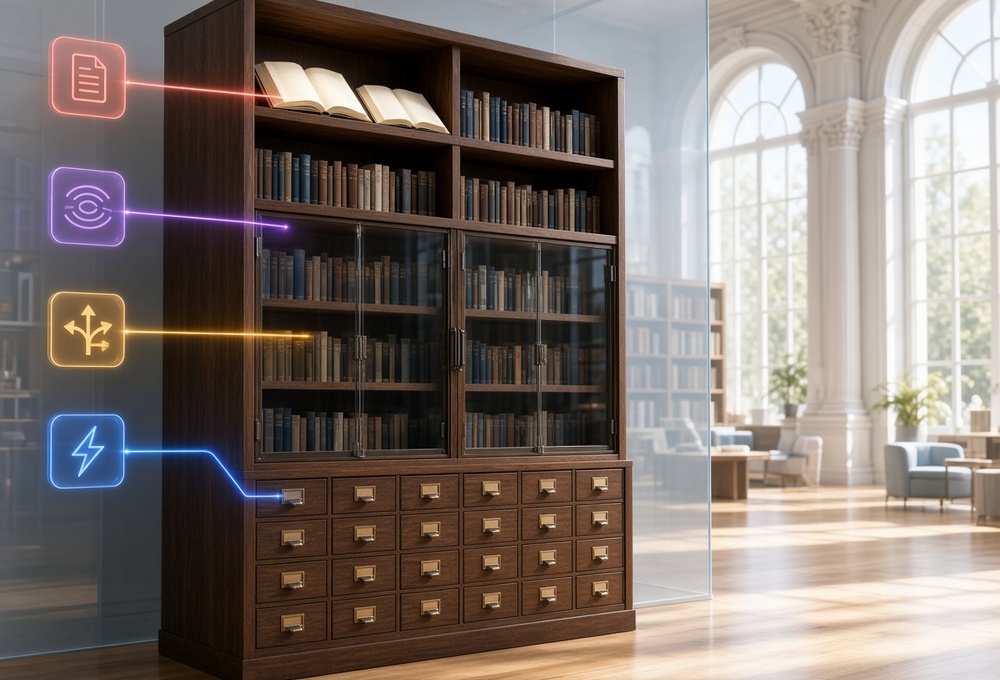
Lee la tabla a lo largo de la columna de disparadores, no en diagonal. La capa 0 y la capa 1 son el caché L1: pagan por su privilegio de residencia permanente siendo diminutas. La capa 2 es el caché de instrucciones: se extrae según una condición de rama, la tarea que coincide con el disparador del skill. La capa 3 es el disco: puede ser enorme porque nada entra en el contexto hasta que un paso de una tarea lee explícitamente un archivo nombrado. La capa 4 es la engorrosa — es la memoria principal, accedida por similitud, que es el único disparador de la lista que no involucra una decisión tomada por ti o por la tarea. La similitud es una puerta probabilística, y esa es la razón por la que necesita los controles externos más estrictos, que la sección de perfiles proporciona. La imagen del gabinete al inicio de este artículo codifica la misma idea: cuanto más arriba está un nivel, más libremente su contenido entra en una conversación, y la partición de cristal marca dónde termina la estantería de un dominio.
Capa 0: identidad
SOUL.md, o lo que tu agente llame a su prompt de sistema. Su trabajo es definir quién, no qué: tono, valores, límites de rechazo y política de memoria. La política de memoria pertenece aquí porque es la única instrucción que debe estar en vigor antes de que cualquier memoria sea consultada. Un archivo de identidad que comienza a listar nombres de servidores, nombres de clientes o tarifas ya ha fallado — se ha convertido en contenido de la capa 1 llevando la insignia de la capa 0, y ahora se mete en cada conversación, incluyendo las en las que no debe aparecer.
Capa 1: memoria residente
Los archivos de memoria persistente: notas generales y el perfil del usuario. Dos reglas gobiernan esta capa, y son las reglas que separan una jerarquía funcional de una pila.
Primera, punteros, no hechos. Si un hecho sirve solo a un dominio, no pertenece aquí. La entrada correcta no es el hecho en sí, sino un señalamiento:
Infra facts: wiki/infra/ + memory bank 'homelab'.
Clients and contracts: wiki/business/clients/ + bank 'business'.
El señalamiento es neutral respecto al dominio, por lo que es seguro llevarlo a todas partes. El hecho al que apunta se carga solo por la actividad que nombró el destino.
Segunda, un presupuesto estricto, aplicado. Si el almacén no tiene un límite de caracteres, se llena, y el llenado siempre es con el tema más reciente discutido — por lo que una semana de infraestructura desaloja o rodea discretamente el contexto general con infraestructura. Un presupuesto que está casi lleno fuerza el triaje, y el triaje es el único mecanismo que mantiene esta capa honesta. La implementación de Hermes es un ejemplo funcional: MEMORY.md limitado a 2.200 caracteres y USER.md a 1.375, inyectado como un bloque congelado al inicio de la sesión, está documentado en Sistema de Memoria del Agente Hermes.
Capa 2: conocimiento procedimental
Los skills son la forma en que el agente codifica cómo: el procedimiento, las trampas y — críticamente para este artículo — los punteros hacia las capas más profundas. Un skill para administración de homelab nombra qué directorio de la wiki guarda el inventario y qué banco de memoria recuperar. Un skill para trabajo con clientes nombra el almacén de contratos y el banco de negocios. La descripción del skill es su disparador: es la condición de rama que decide si el procedimiento, y por lo tanto sus punteros, entra en el contexto en absoluto.
Esta es la capa que hace que la jerarquía funcione operativamente, porque es la costura entre “qué actividad está ocurriendo” y “qué dato esa actividad puede ver”. Una tarea sobre un correo de un cliente carga el skill de cliente; el skill de cliente nombra el banco de negocios y el directorio de contratos; el banco de homelab y el directorio de infraestructura simplemente nunca son referenciados desde una ruta que la tarea recorriera.
El modo de fallo es el creep de datos: pegar la lista real de clientes o la tabla real de IPs en el cuerpo del skill. Entonces los datos siempre se cargan cuando se carga el procedimiento, y el disparador del procedimiento se ha convertido en el límite de exposición de los datos. Los skills llevan el camino hacia los datos, y nada más sensible.
Capa 3: datos de referencia
La wiki, el árbol de notas, el sistema de registro. Esta es la capa con las pocas restricciones y las pocas sorpresas, porque es la única capa con una ruta de acceso determinista: algo entra en el contexto solo porque un paso de una tarea leyó explícitamente ese archivo. Tablas, inventarios, contratos, manuales de operaciones, estadísticas — el tipo de cosas que mantendrías en una base de datos o un sistema de gestión de configuración. Cuando el corpus es mantenido por un LLM, se aplica el patrón de la Wiki de LLM: la síntesis ocurre en el momento de ingestión, y el resultado se almacena como páginas estructuradas y vinculadas.
La razón por la que los datos de referencia pertenecen aquí y no en la capa 4 es que la calidad de la recuperación es la herramienta equivocada para tablas. El recuerdo semántico es excelente para “qué confirmó el cliente X sobre el plazo” y terrible para “cuál es el puerto del servicio en el host Y” — este último tiene exactamente una fila correcta, y un reordenador que devuelve los tres párrafos más cercanos es una responsabilidad. La búsqueda determinista gana para datos de referencia; la similitud gana para episodios. Manténgalos separados, y el patrón de acceso de cada capa coincide con la forma de su contenido.
El modo de fallo es la desactualización, que es un problema de mantenimiento, no de arquitectura: el registro se desvía de la realidad y el agente, haciendo todo bien, trabaja desde una tabla errónea. La mitigación es la misma que cualquier sistema de registro necesita — un escritor por archivo, registros de cambios y un ciclo de auditoría — más las prácticas de detección de desviación y verificación de contradicciones cubiertas en Mantenimiento de Wikis de LLM: Desviación, Contradicciones y Revisión.
Capa 4: memoria recuperada
Un backend de memoria con recuperación automática por turno: la memoria episódica y relacional del agente. Decisiones y sus fechas, “el cliente X confirmó Y”, “probamos Z y no funcionó”. Aquí es donde reside la parte dinámica y autoorganizable del sistema — y donde la historia de seguridad se pone interesante, porque el recuerdo semántico es una puerta probabilística y las puertas probabilísticas fugan.
“Consulta de facturación para el cliente X” y “¿qué host ejecuta el servidor de facturación?” son cercanos en el espacio de incrustaciones. Cualquier banco único que contenga tanto los registros del cliente como el inventario de infraestructura, con una probabilidad no trivial, hará surgir lo segundo en lo primero. Puedes estrechar esto con etiquetas y restricciones de recuperación, y debes hacerlo — pero un filtro de etiquetas en un corpus mixto es una disciplina, no una estructura. La respuesta estructural es dejar de mezclar: un banco por dominio, de modo que el radio de fuga de un recuerdo sea, por construcción, un solo dominio. Elegir el propio backend — política de captura, dependencias, restricciones de autoalojamiento — es una comparación separada, cubierta en Comparación de Proveedores de Memoria de Agentes.
Dos detalles mecánicos importan cuando configuras esta capa. Las rutas de escritura y las rutas de lectura son controles separados: un banco puede estar incluido en la recuperación mientras está excluido de la retención, que es como construyes un perfil que lo lee todo y no escribe nada. Y cada banco debe llevar su propia misión de retención — una declaración corta de para qué existe ese banco. Un banco de negocios con la misión “correspondencia de clientes, términos de contrato, estado de negociación; nunca detalles de infraestructura” extraerá en consecuencia, porque la extracción es una llamada a un LLM que lee la misión. La guía de personalización de OpenAI trata la consolidación como la etapa más sensible y propensa a errores de un ciclo de vida de memoria — la misión de retención es el contrato que mantiene esa etapa honesta.
Perfiles: el límite que hace estructural la separación
Hasta aquí, la jerarquía separa el conocimiento por capa — necesario pero no suficiente. Las cinco capas anteriores son la anatomía de un solo agente. La pregunta con la que este artículo comenzó es sobre dominios: homelab, personal, trabajo, educación, y el contexto general que los abarca.
El mecanismo para la separación de dominios es el perfil — una instancia completa e independiente del agente: su propio archivo de identidad, su propia memoria residente, su propio directorio de skills, sus propios trabajos programados y, decisivamente, su propia conexión de bancos de memoria. Un perfil no es una etiqueta en una conversación; es un sistema separado que sucede en compartir una máquina. Cuando ejecutas agent -p homelab, obtienes un proceso cuya capa 0 a la capa 4 completa está acotada al dominio de homelab, y cuyo grupo de recuperación no puede contener el banco de negocios porque el banco de negocios no está en su configuración en absoluto.
Esta es la diferencia entre las dos respuestas al problema de fuga. “No divulgues infraestructura en conversaciones de negocios” es una instrucción de prompt — una probabilidad. “El grupo de recuperación del perfil de negocios no incluye el banco de infraestructura” es una configuración — una garantía. La jerarquía te dice qué va dónde; el límite del perfil es lo que hace que la colocación sea ineludible desde dentro de la conversación.
El ejemplo práctico, cinco dominios:
| común (por defecto) | homelab | personal | trabajo | educación | |
|---|---|---|---|---|---|
| Identidad (L0) | Base compartida + política de memoria | Base + marco “operador de infra” | Base + “privado, sin tono de negocios” | Base + “profesional, orientado a cliente” | Base + “docente, asume sin conocimiento previo” |
| Memoria residente (L1) | Solo punteros — hacia los cuatro hogares de dominio | Punteros de homelab, hechos de máquina | Punteros personales | Punteros de trabajo | Punteros de cursos |
| Skills (L2) | Skills de flujo de trabajo general | Skills de infra, skill de manual, skill de monitoreo | — | Skill de operaciones con cliente, skill de alcance | Skill de planificación de lecciones |
| Referencia (L3) | Índice compartido de la wiki | wiki/infra/ | wiki/personal/ | wiki/business/clients/ | wiki/education/ |
| Banco retenido (L4) | Ninguno (solo lectura) | banco: homelab | banco: personal | banco: business | banco: education |
| Bancos solo recuerdo (L4) | homelab, personal, business, education | — | — | — | — |
Dos celdas en esa tabla hacen el trabajo pesado.
La fila del banco del perfil común es “ninguno, solo lectura”. La conversación general es donde preguntas preguntas transversales, por lo que debería poder ver los hechos recuperados de cada dominio — pero no debe escribir en ninguno de ellos. El chismorreo en una sesión general es exactamente el material que no quieres que sea extraído a la memoria durable de un dominio, y la conexión de solo lectura elimina la elección del modelo por completo. Si la conexión del backend soporta listas de bancos solo recuerdo (separadas de los bancos de escritura), esto es una línea de configuración por banco de dominio; si no lo hace, el perfil común recuerda desde un banco general dedicado y aceptas una vista interdominio más débil.
Las filas de recuerdo de los perfiles de dominio están vacías. Cada perfil de dominio ve exactamente un banco. El perfil de homelab nunca recuperará un término de contrato de un cliente, no porque le dijeron que no, sino porque el término no está en el grupo que consulta. Esta es la separación bidireccional para la que todo el ejercicio es: funciona simétricamente por construcción, sin instrucción involucrada en ninguna dirección.
Siguen tres consecuencias operativas, y son la razón por la que el enfoque de perfil cuesta más que el enfoque de agente único pero vale la pena para cualquiera cuyos dominios sean genuinamente disjuntos.
- El disparador se convierte en la superficie. Si el trabajo de homelab ocurre en una terminal que lanzas con
-p homelab, y el trabajo con clientes ocurre en una cuenta de mensajería enrutada al perfil de trabajo, entonces qué sombrero llevas es una propiedad de cómo invocaste el agente, no una bandera que recuerdes enunciar. La desviación — ejecutar accidentalmente tareas de clientes en el contexto de homelab — se vuelve tan visible como ejecutar la shell equivocada. - El trabajo programado hereda el límite. Los trabajos cron y las sub-tareas delegadas se ejecutan dentro del perfil que los posee. Una verificación de infra nocturna programada en el perfil de homelab no puede desviar contenido de negocios al banco de homelab, porque nunca lo tiene.
- El sistema de archivos se comparte, y ese es el límite honesto. Los perfiles separan contexto, no acceso. La terminal de cada perfil puede leer los archivos de cada perfil; el límite protege conversaciones, no discos. Por lo tanto, las capas que contienen material genuinamente sensible necesitan su propia disciplina: credenciales en un archivo de entorno o un almacén de secretos en lugar de en texto plano de la wiki, la wiki fuera de cualquier repositorio público, y permisos por directorio donde el SO ayude. Trata el límite del perfil como un firewall para el contexto — excelente en su trabajo — y no lo dejes ser confundido con uno para los datos.
Bootstrap desde una pila plana
La jerarquía se alcanza usualmente desde abajo: un agente que comenzó con un archivo de memoria y ahora mantiene todo en él. El orden de migración importa, porque cada paso solo es barato una vez que el anterior está hecho.
Primero, divide el grupo de recuperación. Crear un banco de memoria por dominio es un cambio de configuración, no una reescritura de contenido — y es el paso con la mayor apalancamiento, porque la fuga de recuerdo se detiene el día que los bancos se dividen. El contenido puede migrar después; el límite no debería esperar por ello.
Segundo, presupuesta la capa 1. Establece un límite de caracteres en los archivos residentes, luego audita lo que ya está en ellos contra el límite. Los hechos específicos de dominio se convierten en punteros hacia dónde vivirán; lo que permanece es lo que genuinamente aplica a cada sesión.
Tercero, dale un destino a los hechos degradados. Un directorio de wiki por dominio, con la disciplina de un solo escritor y registro de cambios, recibe lo que la capa 1 libera. Los skills recogen los punteros hacia él al final, porque un skill que nombra un directorio que aún no existe es peor que ningún skill.
Dónde se pudre la jerarquía
La arquitectura es tan buena como su mantenimiento, y cada capa se pudre de una manera característica.
La capa 1 se llena primero. Es la capa con la ruta de escritura más conveniente (“recuerda esto simplemente”), por lo que es la primera en acumular hechos de dominio disfrazados. El presupuesto hace esto visible: cuando el almacén está al 90% lleno, audítalo en busca de entradas que deberían ser punteros. La solución es siempre el mismo movimiento — degradar hechos a la capa 3, promover el señalamiento.
La capa 2 avanza segundo. Los skills son donde los procedimientos y los datos quieren vivir juntos, porque “el procedimiento referencia los datos constantemente” se siente razonable en el momento de escritura. La verificación es mecánica: si el cuerpo de un skill contiene una tabla que es la fuente de verdad para algo, pertenece a la wiki, y el skill debería llevar una ruta.
La capa 4 se desvía en silencio. La memoria recuperada es orientada a agregar y autoexplicativa, por lo que los episodios desactualizados nunca son corregidos, solo sobrevividos. El preámbulo de recuperación (“estos recuerdos son contexto histórico, no hechos verificados”) es la mitigación estándar. La mitigación más limpia es la misma que usa la capa 3: cuando un episodio se convierte en un hecho durable (“el cliente firmó en esta fecha con estos términos”), se escribe en el sistema de registro, donde es visible y editable, y el banco mantiene solo la narrativa. Una variante más aguda de esta desviación — la inferencia propia del agente escrita de vuelta como evidencia — se desarrolla en Bucles de Memoria Auto-Reforzantes en Agentes de IA.
Los perfiles se multiplican. Cinco perfiles es manejable; quince es una flota. La disciplina es que un perfil nuevo aparece solo cuando aparece un nuevo dominio — no para un nuevo proyecto, una nueva herramienta o un nuevo estado de ánimo. La separación a nivel de proyecto es para lo que está la estructura de directorios de la capa de referencia; la separación a nivel de dominio es para lo que están los perfiles. Confundir los dos es como la gente termina con un zoológico de perfiles y ninguna historia de recuperación clara.
El resumen: una regla de colocación
Coloca cada pieza de conocimiento en la capa más superficial cuyo disparador coincida con su necesidad: hechos siempre necesarios en la memoria residente como punteros, procedimientos en skills, datos de referencia en archivos, episodios en un banco — y pon el banco de cada dominio detrás de un perfil que ningún otro dominio pueda recuperar. El agente entonces se comporta como un sistema bien diseñado: el conocimiento correcto está presente porque la actividad correcta lo solicitó, el conocimiento incorrecto está ausente porque nada en la conversación tenía una ruta hacia él, y la única cosa que podría forzarlos a juntarse es un cambio en la configuración — algo que haces deliberadamente, y por lo tanto puedes ver cuando ocurre.
La pila plana nunca fue un fallo de disciplina. Fue una arquitectura donde cada hecho comparte un disparador, y ese disparador es “siempre”. Rompe el disparador, y las fugas dejan de ser una cuestión del juicio del modelo. Dejan de ser posibles.
Referencias
- PKM vs RAG vs Wiki vs Sistemas de Memoria — la comparación fundamental de almacenes de conocimiento personal, tuberías de recuperación y memoria de agentes
- Sistemas de Memoria en Asistentes de IA — la pila de memoria de tiempo de ejecución dentro de la cual se sienta esta jerarquía
- Recuperación vs Representación en Sistemas de Conocimiento — por qué la forma de tu almacén determina lo que puede responder
- Hub de Memoria en Sistemas de IA
