
OpenClaw: Aufstieg und Fall – Zeitplan und die wahren Gründe für den Zusammenbruch
OpenClaw stieg schnell auf. Dann verschwand er noch schneller.
OpenClaw ist als Produkt gescheitert. Es hat seinen Treibstoff verloren.
OpenClaw stieg schnell auf. Dann verschwand er noch schneller.
OpenClaw ist als Produkt gescheitert. Es hat seinen Treibstoff verloren.
LLMs bereitstellen und austauschen – ohne Neustart.
Eine lange Zeit litt llama.cpp unter einem augenfälligen Mangel:
Sie konnten pro Prozess nur ein Modell bereitstellen, und ein Wechsel erforderte einen Neustart.
Vergleich von PKM-Tools, -Methoden und selbst gehosteten Wikis.
Persönliches Wissensmanagement umfasst Obsidian, Logseq, DokuWiki, Zettelkasten und PARA – die richtige Wahl hängt davon ab, ob Sie einen lokalen Notizgraphen, ein selbst gehostetes Wiki oder einen Outliner-gesteuerten Workflow bevorzugen.
Profil-basierte Hermes-Konfigurationen für anspruchsvolle Workloads
Der Hermes KI-Assistent, offiziell dokumentiert als Hermes Agent, wird nicht als einfacher Chat-Wrapper positioniert.
Die Fähigkeiten, die es wert sind, behalten zu werden, und die, die man überspringen sollte
OpenClaw verfügt über zwei Erweiterungskonzepte, die leicht verwechselt werden können.
Plugins erweitern die Laufzeitumgebung. Skills erweitern das Verhalten des Agents.
Plugins zuerst. Eine kurze Übersicht der Fähigkeiten.
Dieser Artikel handelt von OpenClaw-Plugins — nativen Gateway-Paketen, die Kanäle, Modellanbieter, Tools, Sprachfunktionen, Speicher, Medien, Websuche und andere Laufzeitschnittstellen hinzufügen.
Wie reale OpenClaw-Systeme tatsächlich strukturiert sind
OpenClaw wirkt in Demos einfach. In der Produktion wird es zu einem System.

Selbst gehostete KI-Suche mit lokalen LLMs
Vane ist einer der pragmatischeren Vertreter im Bereich „KI-Suche mit Quellenangaben": eine selbst gehostete Antwort-Engine, die die Live-Webrecherche mit lokalen oder Cloud-LLMs kombiniert, während der gesamte Stack unter Ihrer Kontrolle bleibt.
Hermes-Agent: Installation und Schnellstart für Entwickler
Hermes Agent ist ein selbst gehosteter, modellagnostischer KI-Assistent, der auf einem lokalen Rechner oder einem kostengünstigen VPS läuft, über Terminal- und Messaging-Schnittstellen bedient wird und mit der Zeit intelligenter wird, indem er wiederkehrende Aufgaben in wiederverwendbare Fähigkeiten umwandelt.
Installiere TGI, schieß schnell ab, debugge noch schneller.
Text Generation Inference (TGI) hat eine sehr spezifische Energie. Es ist nicht das neueste Kind auf der Inferenz-Straße, aber es ist dasjenige, das bereits gelernt hat, wie Produktion funktioniert –
Dienen Sie Open-Modelle schnell mit SGLang.
SGLang ist ein leistungsfähiges Bereitstellungsframework für große Sprachmodelle und multimodale Modelle, das entwickelt wurde, um Inferenz mit geringer Latenz und hohem Durchsatz von einzelnen GPUs bis hin zu verteilten Clustern zu ermöglichen.
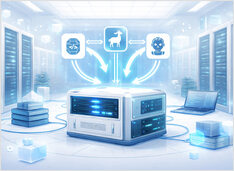
Lokale LLMs per Hot-Swap austauschen, ohne die Clients anzupassen.
Bald jonglierst du mit vLLM, llama.cpp und weiteren – jeder Stack auf seinem eigenen Port. Alles, was downstream liegt, erwartet weiterhin eine einzige /v1-Basis-URL; andernfalls musst du ständig Ports, Profile und Einmalskripte umstellen. llama-swap ist die /v1-Proxy-Schicht vor diesen Stacks.
Die meisten lokalen KI-Setups beginnen mit einem Modell und einer Laufzeitumgebung.
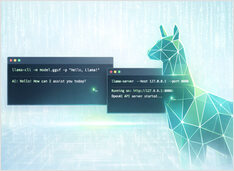
GGUF-Modelle mit der CLI und dem Server ausführen
llama.cpp ist eine C/C++-Inferenz-Engine für GGUF-Modelle: llama-cli für interaktive Chats, llama-completion für skriptgesteuerte Prompts und llama-server für eine OpenAI-kompatible HTTP-API.
OpenClaw KI-Assistenten-Leitfaden
Die meisten lokalen KI-Setups beginnen auf die gleiche Weise: ein Modell, eine Laufzeitumgebung und eine Chat-Schnittstelle.
Vergleichen Sie headless CMS - Funktionen, Leistung & Anwendungsfälle
Die Wahl der richtigen headless CMS kann über den Erfolg Ihrer Content-Management-Strategie entscheiden. Lassen Sie uns drei Open-Source-Lösungen vergleichen, die den Aufbau von contentgetriebenen Anwendungen beeinflussen.