
Progettazione di sistemi multi-modello: quando un singolo modello non è sufficiente
Scegli il pattern più semplice che funziona.
I sistemi a modello singolo sono semplici. I sistemi multi-modello sono potenti. La sfida non è scegliere i modelli: è progettare l’architettura che li orchestra.
Un sistema multi-modello non si tratta di avere più modelli. Si tratta di avere il modello giusto per il compito giusto al momento giusto.
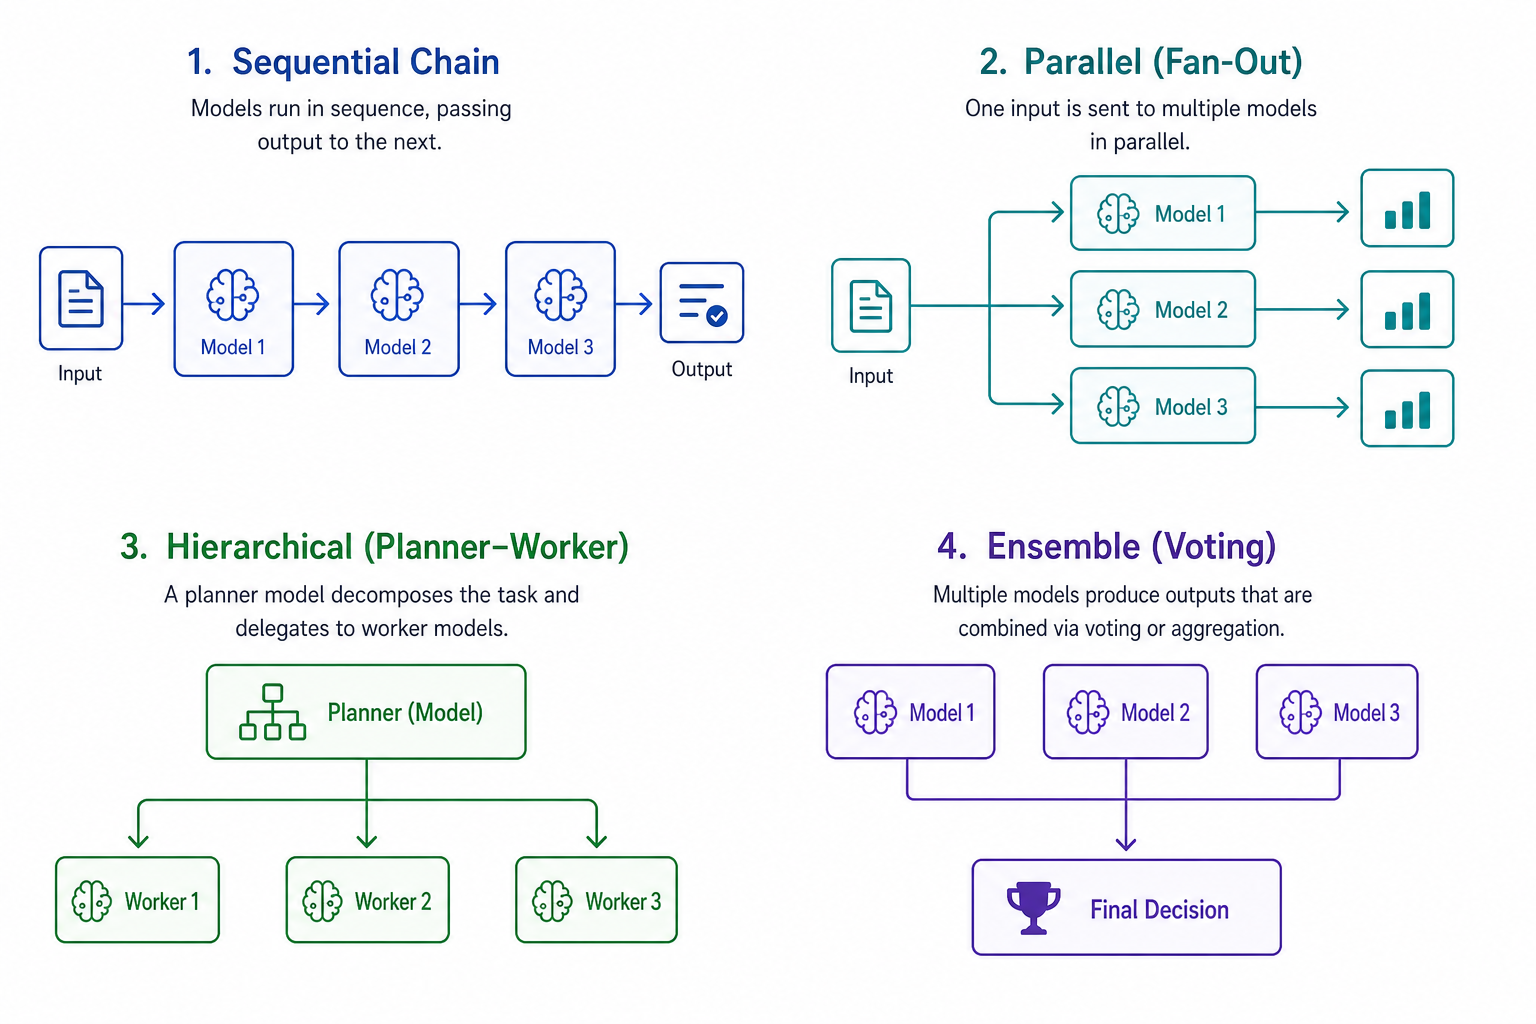
Modelli di architettura
Cinque modelli coprono la maggior parte dei casi d’uso:
| Modello | Complessità | Quando usarlo | Compromesso |
|---|---|---|---|
| Modello Singolo | Minima | Prototipazione, compiti semplici | Capacità limitata |
| Sequenziale | Bassa | Flussi di lavoro multistep | Latenza più elevata |
| Parallelo | Media | Compiti indipendenti | Costo più elevato |
| Gerarchico | Alta | Ragionamento complesso | Orchestrazione complessa |
| Ensemble | Massima | Decisioni critiche | Costo massimo |
Scegli il più semplice che funziona. La complessità è reale e si accumula.
Architettura sequenziale
Elabora i compiti attraverso una catena di modelli, ciascuno specializzato in un passaggio.
Modello 1: Pipeline
Modello Pipeline — l’output di ogni modello alimenta il successivo:
class ModelPipeline:
    def __init__(self):
        self.models = [
            {"model": "qwen3-1.7b", "task": "classify"},
            {"model": "qwen3-8b", "task": "extract"},
            {"model": "qwen3-32b", "task": "reason"},
        ]

    def process(self, input: str) -> str:
        current = input
        for model_config in self.models:
            current = self.call_model(
                model_config["model"],
                self.create_prompt(model_config["task"], current)
            )
        return current
La latenza si somma. Tre modelli in sequenza significano tre volte la latenza. Usa questo modello solo se ogni passaggio richiede effettivamente un modello diverso.
Modello 2: Router
Modello Router — classifica il compito e instrada verso lo specialista:
class ModelRouter:
    def __init__(self):
        self.classifier = "qwen3-1.7b"
        self.specialists = {
            "code": "qwen2.5-coder-7b",
            "math": "qwen3-32b",
            "creative": "claude-sonnet-4",
            "general": "qwen3-8b",
        }

    def route(self, prompt: str) -> str:
        task_type = self.classify(prompt)
        model = self.specialists.get(task_type, self.specialists["general"])
        return self.call_model(model, prompt)
Il classificatore è il punto debole. Se classifica male, instradi verso il modello sbagliato e perdi in qualità. Usa un classificatore abbastanza buono: anche uno piccolo funziona se le categorie sono chiare.
Architettura parallela
Elabora compiti indipendenti simultaneamente.
Modello 1: Fan-Out
Fan-out — esegui lo stesso prompt attraverso più modelli:
import asyncio

class ModelFanOut:
    def __init__(self):
        self.models = [
            "qwen3-8b",
            "qwen3-32b",
            "claude-sonnet-4",
        ]

    async def process(self, prompt: str) -> list[str]:
        tasks = [self.call_model(model, prompt) for model in self.models]
        return await asyncio.gather(*tasks)
Utile per confronti, test A/B o quando si vuole scegliere l’output migliore. Costoso, ma il guadagno in qualità vale la pena per decisioni critiche.
Modello 2: Voting
Voting — combina gli output tramite consenso:
class ModelVoting:
    def __init__(self):
        self.models = [
            "qwen3-8b",
            "qwen3-32b",
            "claude-sonnet-4",
        ]

    def vote(self, prompt: str) -> str:
        responses = [self.call_model(model, prompt) for model in self.models]
        from collections import Counter
        votes = Counter(responses)
        return votes.most_common(1)[0][0]
Il voto a maggioranza funziona per la classificazione. Per i compiti di generazione, è più difficile: serve somiglianza semantica, non corrispondenze esatte.
Architettura gerarchica
Usa modelli a diversi livelli di astrazione.
Modello 1: Planner-Executor
Planner-Executor — un modello forte pianifica, modelli più piccoli eseguono:
class PlannerExecutor:
    def __init__(self):
        self.planner = "qwen3-32b"
        self.executors = {
            "code": "qwen2.5-coder-7b",
            "search": "qwen3-8b",
            "math": "qwen3-8b",
        }

    def process(self, task: str) -> str:
        plan = self.call_model(self.planner, f"Plan: {task}")
        results = []
        for step in self.parse_plan(plan):
            executor = self.executors.get(step["type"], "qwen3-8b")
            result = self.call_model(executor, step["prompt"])
            results.append(result)
        return self.call_model(self.planner, f"Synthesize: {results}")
Il planner fa il lavoro pesante. Gli executor gestiscono compiti specifici. Questo modello funziona bene quando il passaggio di pianificazione è costoso ma i passaggi di esecuzione sono economici.
Modello 2: Supervisor-Worker
Supervisor-Worker — un supervisore delega e revisiona:
class SupervisorWorker:
    def __init__(self):
        self.supervisor = "qwen3-32b"
        self.workers = ["qwen3-8b", "qwen2.5-coder-7b"]

    def process(self, task: str) -> str:
        assignments = self.call_model(self.supervisor, f"Assign: {task}")
        results = []
        for assignment in self.parse_assignments(assignments):
            result = self.call_model(
                assignment["worker"], assignment["task"]
            )
            results.append(result)
        return self.call_model(self.supervisor, f"Review: {results}")
Il supervisore è il collo di bottiglia. Pianifica, delega e revisiona. Assicurati che sia abbastanza veloce, altrimenti l’intero sistema rallenta.
Architettura Ensemble
Combina più modelli per decisioni critiche.
Modello 1: Weighted Ensemble
Weighted Ensemble — punteggi l’output di ogni modello e scegli il più alto:
class WeightedEnsemble:
    def __init__(self):
        self.models = {
            "qwen3-32b": 0.5,
            "claude-sonnet-4": 0.3,
            "qwen3-8b": 0.2,
        }

    def decide(self, prompt: str) -> str:
        responses = {
            model: self.call_model(model, prompt)
            for model in self.models
        }
        scores = {}
        for model, response in responses.items():
            score = self.evaluate(response) * self.models[model]
            scores[response] = scores.get(response, 0) + score
        return max(scores, key=scores.get)
I pesi riflettono la tua fiducia in ogni modello. Regolisti in base alle prestazioni reali, non ai benchmark.
Modello 2: Consensus Ensemble
Consensus Ensemble — richiedi l’accordo ed escalala se non c’è:
class ConsensusEnsemble:
    def __init__(self, threshold: float = 0.7):
        self.threshold = threshold
        self.models = [
            "qwen3-32b",
            "claude-sonnet-4",
            "qwen3-8b",
        ]

    def decide(self, prompt: str) -> str:
        responses = [
            self.call_model(model, prompt)
            for model in self.models
        ]
        from collections import Counter
        votes = Counter(responses)
        max_votes = max(votes.values())

        if max_votes / len(self.models) >= self.threshold:
            return votes.most_common(1)[0][0]

        return self.call_model("qwen3-32b", prompt)
La soglia controlla quanto è rigoroso il consenso. 0.7 significa due terzi di accordo. Abbassala per decisioni più rapide, alzasla per maggiore sicurezza.
Quando i sistemi multi-modello hanno senso
I sistemi multi-modello hanno senso quando hai carichi di lavoro misti, hai bisogno di alta qualità per decisioni critiche o stai ottimizzando per costo o latenza.
Non hanno senso quando tutti i compiti hanno complessità simile, stai facendo prototipazione o la semplicità conta più dell’ottimizzazione.
La regola pratica: parti con un modello. Aggiungine altri solo quando raggiungi un vincolo reale — costo, latenza o qualità. Non progettare complessità prima di averne bisogno.
Compromessi
| Modello | Costo | Latenza | Qualità | Complessità |
|---|---|---|---|---|
| Modello Singolo | Minimo | Minima | Variabile | Minima |
| Sequenziale | Medio | Alta | Alta | Media |
| Parallelo | Alto | Bassa | Alta | Media |
| Gerarchico | Alto | Alta | Massima | Alta |
| Ensemble | Massimo | Media | Massima | Massima |
Ogni modello comporta un compromesso. Scegli quello che corrisponde ai tuoi vincoli.
Correlati
- Strategie di instradamento dei modelli — instradamento basato sulle capacità, sensibile al costo, sensibile alla latenza
- Ottimizzazione dei costi per i sistemi LLM — budget di token, modelli di fallback, caching
- Guardrail LLM nella pratica — validazione dell’input, filtraggio dell’output, sicurezza
- LLM Decisionali: quando un modello dovrebbe decidere — e quando no — quali decisioni un modello può prendere in un’orchestrazione e come verificarle
- Architettura LLM — pilastro di progettazione dei sistemi: instradamento, costi, guardrail e orchestrazione
- Modelli di orchestrazione multi-agente — distinto dall’istradamento multi-modello: questo copre come più agenti autonomi si coordinano, non come i compiti vengono instradati tra i modelli
