
Model Routing: smetti di usare un unico modello per tutto
Il modello giusto per il compito giusto.
Eseguire un modello con 70 miliardi di parametri per riassumere un’e-mail di 200 parole è uno spreco. Utilizzare un modello da 3 miliardi di parametri per revisionare codice in produzione è irresponsabile. La maggior parte dei sistemi si colloca in un punto intermedio — ed è proprio qui che entra in gioco il model routing.
Esso allinea la complessità del task alla capacità del modello. I compromessi sono reali, ma anche i risparmi lo sono.
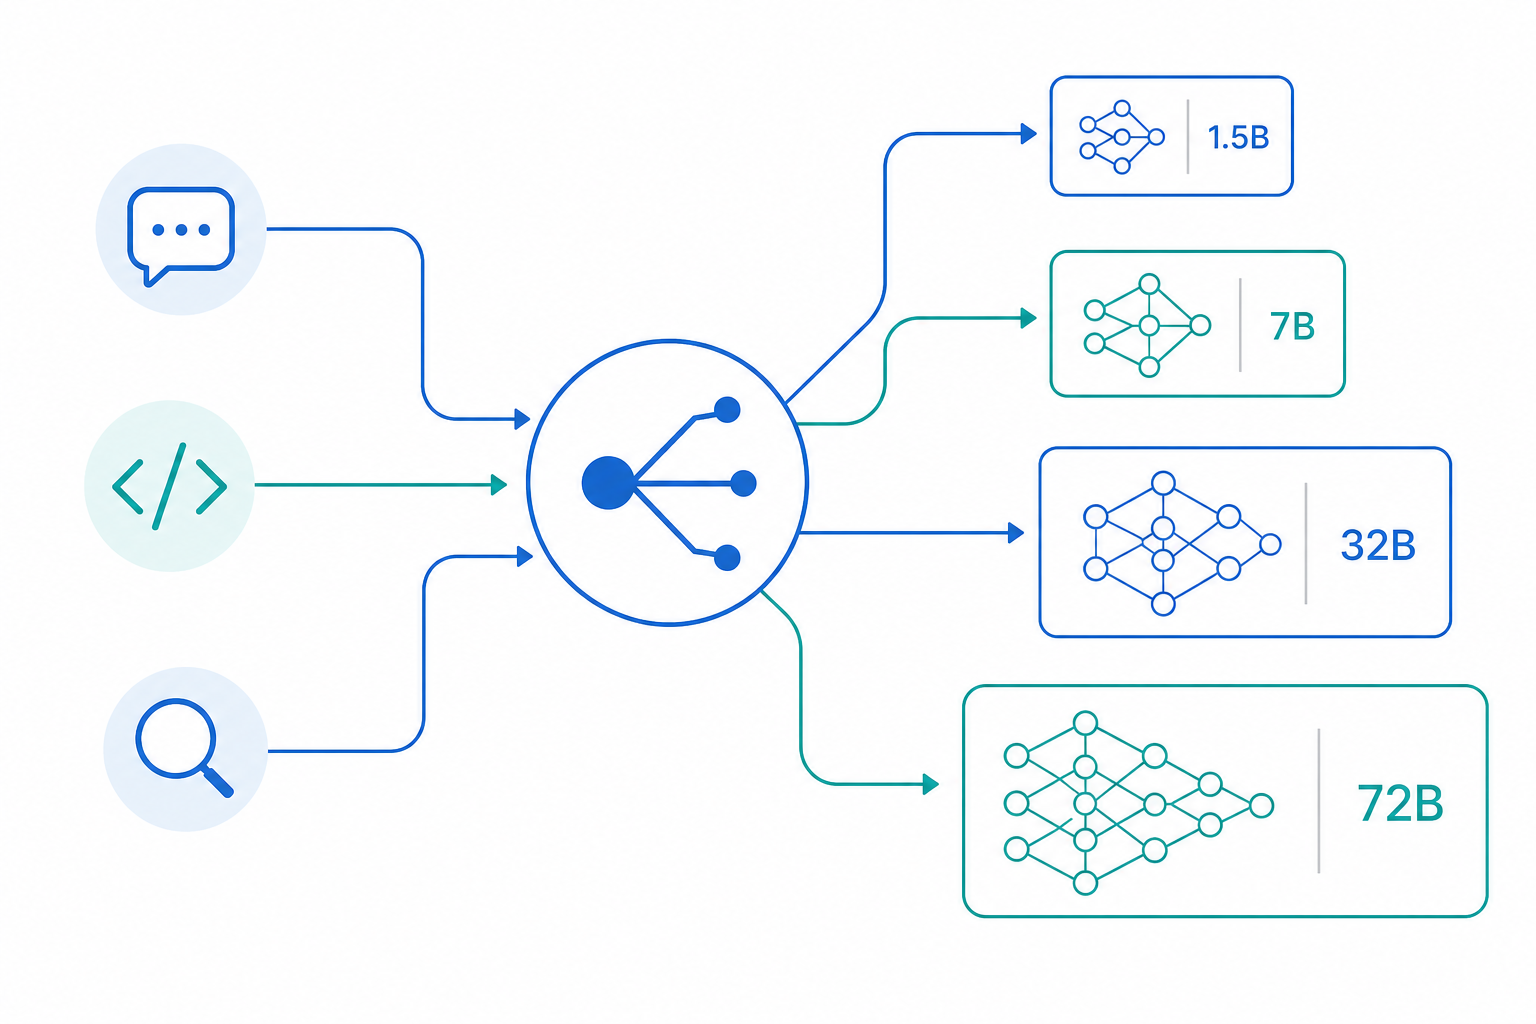
Il problema del routing
Di solito si inizia con un singolo modello e ci si resta. Questo funziona finché non si nota il costo, o la latenza, o entrambi. L’alternativa è costruire un router — qualcosa che decide quale modello gestisce quale richiesta.
Quattro strategie funzionano nella pratica:
- Basato sulle capacità — instradare in base a ciò che il modello sa fare
- Consapevole del costo — instradare in base a ciò che ci si dispone a spendere
- Consapevole della latenza — instradare in base a quanto rapidamente serve il risultato
- Ibrido — combinarli
Ognuna ottimizza qualcosa di diverso. Sceglierne una è di solito una decisione su cosa pesi di più.
Routing basato sulle capacità
L’approccio più semplice. Classificare il task e inviarlo al modello che lo gestisce al meglio.
| Task | Dimensione modello | Esempi |
|---|---|---|
| Classificazione, tagging | 1-3B | Qwen3-1.7B, Gemma-2-2B |
| Riassunti, estrazione | 3-7B | Qwen3-8B, Llama-3.1-8B |
| Generazione di codice | 7-14B | Qwen2.5-Coder-7B, DeepSeek-Coder-V2 |
| Ragionamento complesso | 14-32B | Qwen3-32B, Llama-3.1-70B |
| Scrittura creativa, analisi | 32B+ | Qwen2.5-72B, Claude, GPT-4 |
Se il task non ha bisogno del modello più grande, non usarlo. Un modello da 1,5 miliardi di parametri gestisce bene la classificazione del sentimento. Semplicemente non scriverà un saggio coerente.
L’implementazione è semplice:
ROUTING_RULES = {
    "classify": {"model": "qwen3-1.7B", "max_tokens": 100},
    "summarize": {"model": "qwen3-8B", "max_tokens": 500},
    "code_review": {"model": "qwen2.5-coder-7b", "max_tokens": 2000},
    "reason": {"model": "qwen3-32b", "max_tokens": 4000},
    "creative": {"model": "claude-sonnet-4", "max_tokens": 8000},
}

def route_request(task_type: str) -> dict:
    return ROUTING_RULES.get(task_type, ROUTING_RULES["reason"])
Il punto critico è la classificazione stessa. Se si sbaglia il tipo di task, si instrada al modello sbagliato. Ho visto sistemi classificare la revisione del codice come “riassunto” e perdere qualità silenziosamente.
Routing consapevole del costo
L’inferenza locale brilla qui. I modelli locali sono di fatto gratuiti dopo l’ammortamento dell’hardware. Una RTX 5080 si ripaga in circa sei mesi con un utilizzo API moderato.
| Modello | Input ($/M token) | Output ($/M token) | Costo locale/ora |
|---|---|---|---|
| GPT-4o | $2.50 | $10.00 | — |
| Claude Sonnet 4 | $3.00 | $15.00 | — |
| Qwen2.5-72B (API) | $0.50 | $2.00 | — |
| Qwen3-32B (locale) | $0.00 | $0.00 | ~$0.10 |
| Qwen3-8B (locale) | $0.00 | $0.00 | ~$0.05 |
Se si elaborano migliaia di richieste per sessione, anche $0.05 di elettricità battono $15/M token.
Il routing basato sul budget degrada gradualmente man mano che si spende:
class CostAwareRouter:
    def __init__(self, budget_per_session: float = 0.10):
        self.budget = budget_per_session
        self.spent = 0.0
        self.models = {
            "cheap": {"model": "qwen3-8B", "cost": 0.0},
            "medium": {"model": "qwen3-32b", "cost": 0.0},
            "expensive": {"model": "claude-sonnet-4", "cost": 0.000015},
        }

    def route(self, task: str) -> str:
        ratio = self.spent / self.budget
        if ratio < 0.5:
            return self.models["expensive"]["model"]
        elif ratio < 0.8:
            return self.models["medium"]["model"]
        return self.models["cheap"]["model"]
La qualità diminuisce man mano che si passa a modelli meno performanti. Si inizia con Claude, si passa a Qwen3-32B, poi a Qwen3-8B. Alla fine di una sessione lunga, l’output è visibilmente peggiore. Se questo sia un problema dipende da cosa si sta costruendo.
Inviare il traffico di routine a un modello locale, riservando l’API ai casi limite, ha anche un beneficio collaterale oltre al costo: impedisce di cadere in quel tipo di gravità dei dati in cui ogni fine-tuning e ogni harness di valutazione finisce per essere modellato attorno all’API di un singolo provider.
Routing consapevole della latenza
Gli strumenti interattivi necessitano di token rapidi. I job batch possono aspettare. La differenza è di solito un fattore cinque nella dimensione del modello.
| Caso d’uso | Primo token | Completo | Dimensione max modello |
|---|---|---|---|
| Chat in tempo reale | < 200ms | < 2s | < 7B |
| Strumenti interattivi | < 500ms | < 5s | < 14B |
| Elaborazione batch | < 1s | < 30s | Qualsiasi |
| Ricerca/analisi | < 2s | < 60s | Qualsiasi |
Quando si stanno streaming i token a un utente, è la latenza del primo token ciò che percepiscono. Un modello da 32 miliardi di parametri che impiega mezzo secondo per iniziare sembra lento rispetto a un modello da 1,5 miliardi di parametri che parte istantaneamente.
class LatencyAwareRouter:
    def __init__(self):
        self.model_latencies = {
            "qwen3-1.7b": {"first_token": 0.05, "complete": 0.5},
            "qwen3-8B": {"first_token": 0.15, "complete": 2.0},
            "qwen3-32b": {"first_token": 0.5, "complete": 10.0},
            "claude-sonnet-4": {"first_token": 0.3, "complete": 5.0},
        }

    def route(self, target_latency: float) -> str:
        for model, latencies in sorted(
            self.model_latencies.items(),
            key=lambda x: x[1]["complete"]
        ):
            if latencies["complete"] <= target_latency:
                return model
        return "qwen3-1.7b"
I numeri di latenza sono approssimativi — dipendono dall’hardware, dalla quantizzazione e dalla dimensione del batch. Misurare sul proprio setup.
Strategie di fallback
I modelli falliscono. Le API limitano la frequenza. I timeout accadono. Il pattern che funziona è una catena di fallback, ordinata dalla migliore alla più affidabile:
class FallbackRouter:
    def __init__(self):
        self.fallback_chain = [
            {"model": "claude-sonnet-4", "timeout": 30},
            {"model": "qwen2.5-72b", "timeout": 60},
            {"model": "qwen3-32b", "timeout": 120},
            {"model": "qwen3-8b", "timeout": 300},
        ]

    def route_with_fallback(self, prompt: str) -> str:
        for config in self.fallback_chain:
            try:
                return self.call_model(
                    config["model"], prompt,
                    timeout=config["timeout"]
                )
            except (TimeoutError, APIError) as e:
                log.warning(f"Model {config['model']} failed: {e}")
                continue
        raise RuntimeError("All fallback models failed")
L’ultimo modello nella catena dovrebbe essere locale. È più lento, ma non fallirà a causa di un problema di rete o di una chiave API.
Quando il routing è utile
Il routing ha senso quando il carico di lavoro è misto. Se si stanno facendo classificazione, riassunti e ragionamento nello stesso sistema, un router fa risparmiare denaro e latenza.
Non ha senso quando tutto ciò che si fa ha la stessa complessità. Basta usare il modello che è bravo in quel task. Il router aggiunge complessità di cui non si ha bisogno.
La prototipazione iniziale è un’altra ragione per saltarlo. Fungere il task funzionare con un singolo modello, poi aggiungere il routing quando il costo o la latenza diventano effettivamente un problema.
Compromessi
Ogni strategia di routing ottimizza qualcosa e sacrifica qualcos’altro:
- Singolo modello — più semplice, più costoso, qualità coerente
- Basato sulle capacità — costo migliore, qualità più alta per task, complessità moderata
- Consapevole del costo — meno costoso, qualità variabile, complessità moderata
- Consapevole della latenza — più veloce, può sacrificare la qualità, complessità moderata
- Ibrido — il meglio di tutti, il più complesso da implementare
I sistemi di produzione convergono di solito sull’approccio ibrido. Si inizia con il routing basato sulle capacità, si aggiunge la consapevolezza del costo quando arriva la bolletta, si aggiunge la consapevolezza della latenza quando gli utenti si lamentano della lentezza.
Correlati
- Ottimizzazione dei costi per i sistemi LLM — budgeting dei token, caching, modelli di fallback
- Guardrail LLM nella pratica — validazione input, filtraggio output, sicurezza
- Progettazione di sistemi multi-modello — architettura per più modelli
- LLM Decisionali: Quando un modello dovrebbe decidere — e quando no — la tassonomia dei ruoli decisionali dietro la selezione del livello, con escalation basata sulla confidenza
- Architettura LLM — pilastro di progettazione del sistema: routing, costi, guardrail e orchestrazione
