Ejecuta Qwen3.8-Flash-Next localmente con Strata: guía rápida de 64 GB
125B MoE en una GPU de consumo — y dónde falla la cuantización a 3 bits
Qwen3.8-Flash-Next (QFN) tiene 125B parámetros totales, 6B activos por token y una ventana de contexto nativa de 256K. Tiene el razonamiento activado de forma predeterminada y registra los mejores resultados en las pruebas de codificación agéntica de su clase de modelos locales.
Este artículo describe cómo ejecutar una cuantización de 3 bits de QFN en un escritorio de 64 GB de RAM con una RTX 5090 usando Strata, y documenta por qué las cuantizaciones sub-Q4 no producen llamadas a herramientas fiables para cargas de trabajo agénticas.
A continuación se muestran los comandos de instalación, la RAM que cada cuantización fija y los fallos en las llamadas a herramientas en un escritorio de 64 GB. Las cifras de velocidad y fallos combinan ejecuciones en esa máquina —una RTX 5090, 64 GB de RAM, Ubuntu 26.04— con informes del panel de Strata y las notas de la versión 0.2.11.
Los comandos y los valores predeterminados del motor se verificaron el 06/11/2026 contra Strata 0.2.11, cuando el repositorio mostraba 40,836 estrellas y los paquetes del motor eran 0.1.57. El lugar donde este entorno de ejecución se sitúa frente a Ollama, llama.cpp y vLLM es el trabajo de la guía de alojamiento de LLM.
Qué es Strata
El motor en esta guía rápida es Niko1221/Strata, con licencia MIT. Un proyecto diferente, el papel OSDI 2026 sobre caché jerárquica de KV para SGLang, usa el mismo nombre. Strata se basa en llama.cpp y ggml, y el repositorio incluye una descripción en docs/paper/Strata-Paper.pdf. Ejecuta Qwen3.8-Flash-Next a través de una GPU de consumo, la RAM del sistema y un SSD. El mismo motor también sirve Qwen3.6-35B y DeepSeek V4.1-Flash.
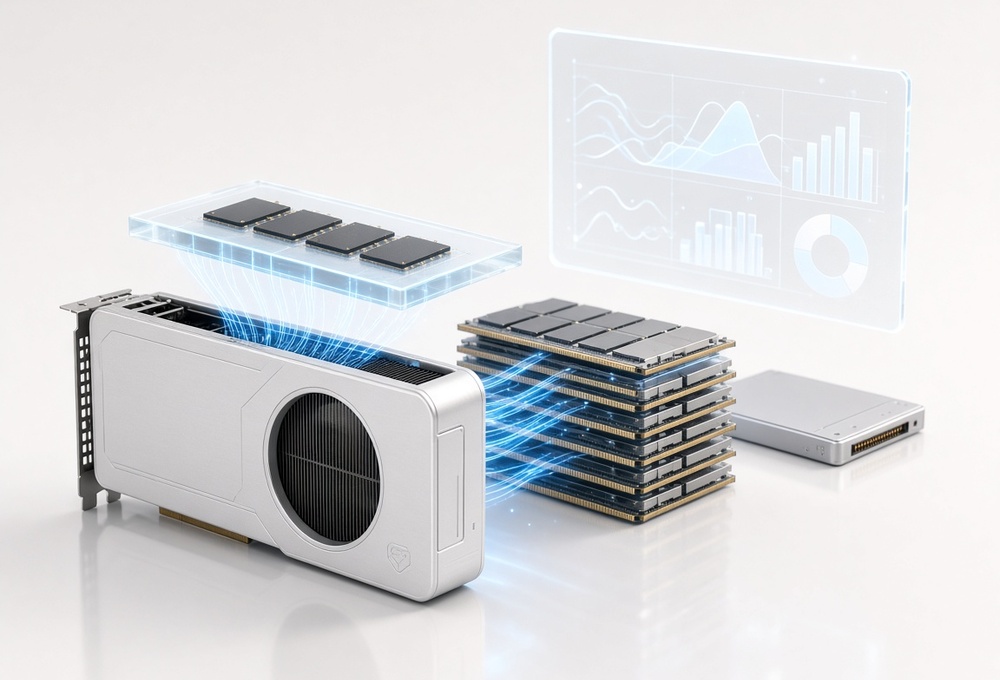
Qwen 3.8 Flash Next tiene 24,576 expertos enrutados a través de 48 capas; cada token activa 10 expertos (6B parámetros activos en total). Strata divide el modelo en tres niveles de memoria en lugar de requerir que quepa en uno solo.
| Nivel | Contiene | Hace |
|---|---|---|
| GPU (VRAM) | Atención, mezcladores DeltaNet, pesos de residual con puerta, routers, expertos compartidos, cabecera de salida, la capa de borrador MTP, la caché KV (desde 64K: la parte más leída; el resto se transmite desde RAM), más una caché de expertos | Todo lo que se ejecuta por token; la caché de expertos llena la VRAM restante con los expertos más utilizados y se adapta a la conversación mientras se ejecuta |
| RAM | Todos los 24,576 expertos, fijados (pinned) | La CPU calcula los expertos que la GPU no tiene, in situ, al mismo tiempo que la GPU trabaja en los que están en caché (kernels AVX-512/AVX2, ggml para las i-cuantizaciones) |
| SSD | La tabla de embeddings n-gram de 28.8 GB | Lee unas pocas filas por token a través de la caché de páginas del sistema operativo |
El bloque de parámetros n-gram de 51B sirve como una tabla de consulta de 20 millones de entradas indexada por bigramas y trigramas. Como esta es una consulta y no una multiplicación de matrices, puede residir en un SSD con un costo de ejecución mínimo.
La capacidad de VRAM determina el eje de escalado. Cada gigabyte adicional de VRAM contiene aproximadamente 700 expertos, y cada experto en caché en la GPU reduce el cálculo de la CPU. Una tarjeta lenta con más VRAM supera a una tarjeta rápida con menos.
La capacidad de RAM es una restricción dura porque todos los expertos deben estar fijados para un cálculo simultáneo de CPU y GPU. Strata no admite el mapeo perezoso de memoria en disco. El tamaño de descarga y el uso de RAM son casi idénticos para QFN.
Cómo se construye la velocidad de decodificación
Tres mecanismos suministran la tasa de decodificación.
-
Predicción de múltiples tokens. El punto de control incluye una capa MTP entrenada para borradores de múltiples pasos. Strata hace borradores de hasta 3 tokens y los verifica en un solo paso por todas las 48 capas —el ciclo de borrador-verificación de la guía de decodificación especulativa. El proyecto mide un promedio de aceptación de 2,4–3,2 tokens por paso, y lo reporta como una velocidad de decodificación de 1,6–1,8× con la misma salida.
-
Consulta del prompt. El servidor recupera hasta 5 tokens de borrador de copias anteriores del contexto cuando el modelo lo está repitiendo, como en una edición de código o una cita. El proyecto reporta ediciones de código un 6–11% más rápidas, y otro texto sin cambios.
-
Prefill por fragmentos. Los prompts llegan en bloques de hasta 8.192 tokens, y los expertos de la siguiente capa se trasladan a través de PCIe mientras la atención de la capa actual se ejecuta. El proyecto sitúa la ingesta de documentos largos y bases de código por encima de 1.000 tokens/s, y una solicitud de seguimiento comienza en segundos porque el estado de la conversación permanece residente.
El servidor incluye una interfaz de chat local, como una aplicación de escritorio o en la terminal, más endpoints compatibles con OpenAI y Anthropic en localhost. Claude Code, Codex CLI, OpenCode, Hermes Agent y OpenClaw se conectan a través de strata connect. El hardware que el proyecto lista: series NVIDIA RTX 20/30/40/50 (los paquetes del motor CUDA 13 necesitan controlador 580 o más nuevo), AMD Radeon en HIP, Intel Arc en Linux, Apple Silicon y AMD Strix Halo. La versión 0.2.11 es Strata-0.2.11-linux-x86_64.AppImage para la aplicación de escritorio; la ruta de la terminal a continuación es la que esta guía rápida recorre.
Puntajes de QFN frente a alternativas locales
La tarjeta del modelo de Alibaba compara Flash-Next con Qwen3.8-27B, DeepSeek-V4-Flash (el punto de control 0731) y Claude Opus 4.6 (Max).
| QFN | Qwen3.8-27B | DeepSeek-V4-Flash | Claude Opus 4.6 (Max) | |
|---|---|---|---|---|
| Parámetros totales / activos | 125B / 6B | 27B / 27B | 284B / 13B | – |
| Parámetros de embeddings n-gram | 51B | – | – | – |
| DeepSWE 1.1 (codificación agéntica) | 58.7 | 42.2 | 54.4 | – |
| SWE-bench Pro | 62.5 | 61.7 | 56.0 | 53.4 |
| SWE-bench Multilingual | 81.0 | 73.8 | – | 77.5 |
| Toolathlon Verified (uso de herramientas) | 73.5 | 67.1 | 70.3 | – |
| JobBench (oficina agéntica) | 55.7 | 33.4 | 41.3 | 36.6 |
| CoWorkBench | 73.9 | 70.7 | 45.1 | 68.2 |
| GPQA Diamond | 91.7 | 89.2 | 90.8 | 91.3 |
| LiveCodeBench v6 | 91.9 | 90.3 | 90.6 | 88.8 |
Las filas de codificación agéntica en esa tarjeta usaron temperatura 1.0, top_p 0.95 y una ventana de 256K. DeepSWE informa el valor más alto de los andamios de Claude Code y mini-SWE-agent, y la tarjeta dice que la puntuación más alta de Flash-Next es con mini-SWE-agent. SWE-bench Pro reejecutó las líneas base en un conjunto de tareas corregido; la celda de Claude Opus 4.6 es la puntuación publicada por el proveedor, y las otras celdas son de Claude Code.
Dos filas en la misma tarjeta van en la dirección opuesta. NL2Repo-Bench es 48.1 para Flash-Next y 54.2 para DeepSeek-V4-Flash. HLE, juzgado por GPT-4o, es 35.9 frente a Claude Opus 4.6 (Max) con 40.0.
Para el trabajo agéntico, los valores predeterminados de la tarjeta son preserve_thinking activado, para que la traza de razonamiento permanezca entre turnos, y reasoning_effort en xhigh. Los otros niveles son medium y low. La página de la familia Qwen 4 sigue lo que Alibaba ha confirmado sobre esta línea, incluida la Licencia Comunitaria de Qwen 1.0 para estos pesos. La tabla anterior es la parte que se puede medir hoy.
Compilaciones y tamaños de cuantización
GSQ-RCO de ISTA-DASLab
Los GGUF de ISTA-DASLab GSQ-RCO usan cuantización no uniforme. GSQ es cuantización escalar de bajo bit por tensor, y RCO asigna un tipo por tensor dentro de un presupuesto de tamaño. El método gasta casi toda la compresión en los expertos enrutados, que son el 95% de los pesos buscables. Cada compilación es de dos fragmentos. El segundo es la tabla n-gram a unos 4.5 bits por peso, y se puede mapear desde el disco.
| Compilación | Promedio bpw | Fragmento residente | Fragmento n-gram | Total | Notas |
|---|---|---|---|---|---|
| Q2_0 | 2.40 | 37.6 GB | 28.8 GB | 66.4 GB | Compilación de velocidad: evita formatos de tabla de búsqueda; 367 prompt t/s, 93.8 decode t/s, 6.7 s latencia promedio (vs 12.7 s para IQ2_XS con casi el mismo tamaño) |
| IQ2_XS | 2.50 | 39.2 GB | 28.8 GB | 68.0 GB | El más pequeño con calidad igual |
| IQ3_XXS | 3.00 | 47.0 GB | 28.8 GB | 75.8 GB | La elección para memoria ajustada; coincide con el modelo base en AIME25, cede ~1.5 puntos en GPQA-Diamond |
| IQ3_S | 3.50 | 54.8 GB | 28.8 GB | 83.6 GB | Recomendación de ISTA: coincide o supera al modelo base en cada tarea de su andamiaje (GPQA-Diamond 92.93 vs 91.92) |
Esas cifras de GPQA son del andamiaje de ISTA, no el 91.7 en la tarjeta de Alibaba. Una variante Coder mantiene 256 de los 512 expertos enrutados por capa, a 58.4 GB y 1.89 bits efectivos por peso. Un proyector de visión BF16 de 0.91 GB es el complemento multimodal. La línea de ISTA se detiene en IQ3_S; no tiene compilación Q4.
Paquetes de Unsloth en Strata 0.2.11
El 04/11/2026 Unsloth re-subió sus GGUF de Qwen3.8-Flash-Next como Dynamic v3.1. Las notas de la versión 0.2.11 dicen que Strata puede descargar, preparar y ejecutar siete de ellos desde la aplicación, desde strata launch --family unsloth, o desde una carpeta que ya tenga. Cada archivo se verifica por tamaño y SHA-256 contra la revisión de Unsloth d9620119. El último archivo de cada conjunto es la tabla por token de 28.8 GB. Los conjuntos que comparten una tabla comparten el archivo: UD-IQ1_M con UD-IQ2_XS, y UD-IQ3_XXS con UD-IQ4_XS-v31.
| Nombre en Strata | Descarga | Archivos |
|---|---|---|
| UD-IQ1_M | 68.0 GB | 3 |
| UD-Q2_0 | 70.6 GB | 3 |
| UD-IQ2_XS | 75.8 GB | 3 |
| UD-Q2_K_XL | 79.6 GB | 4 |
| UD-IQ3_XXS | 83.6 GB | 4 |
| UD-Q3_K_XL | 89.5 GB | 4 |
| UD-IQ4_XS-v31 | 93.7 GB | 4 |
UD-IQ4_XS-v31 es un archivo diferente del UD-IQ4_XS que Strata ya ofrecía: otros tipos de tensor, cuatro archivos en lugar de tres. UD-Q4_K_XL, UD-Q5_K_XL, UD-Q6_K_XL y Q8_0 permanecen en los archivos del 30/09/2026. El UD-Q4_K_XL del 04/11 son los mismos pesos en una división de cuatro archivos, y Strata acepta esa división si ya la tiene. UD-IQ1_S no se carga —una capa mezcla dos formatos de experto—, por lo que UD-IQ1_M es la elección de 1 bit.
UD-IQ4_XS-v31 usa el formato de experto Q5_0 en 33 capas. Las mismas notas dicen que la matemática de Q5_0 de Strata se sitúa a un 1.2–1.3% del resultado exacto, frente a un 2.6–3.0% para la fórmula de llama.cpp en esos tensores. En una Mac, la aplicación reescribe los expertos en un archivo de GPU antes del primer inicio, por lo que el presupuesto de disco es la descarga más ese archivo más unos pocos gigabytes (aproximadamente 115 GB para UD-IQ1_M).
Si la tabla de 28.8 GB permanece mapeada, el resto de UD-IQ4_XS-v31 es aproximadamente 64.9 GB antes de la caché KV, lo cual ya supera una máquina de 64 GB bajo la regla de fijación de Strata. El remanente de UD-IQ1_M es aproximadamente 39.2 GB. Ese archivo puede caber donde IQ3_S no puede, y es un paquete de 1 bit, más lejos del comportamiento de llamadas a herramientas medido a continuación a 3 bits.
Guía rápida: Instalación, lanzamiento y configuración de primera ejecución
Un escritorio Linux necesita una tarjeta de la serie RTX 20/30/40/50 u otra GPU que el proyecto liste, suficiente RAM para el paquete elegido más margen de caché KV, y espacio en SSD para la descarga. Los paquetes del motor CUDA 13 necesitan controlador 580 o más nuevo.
Instalación en terminal:
curl -fsSL https://github.com/Niko1221/Strata/releases/latest/download/install.sh -o install.sh && sh install.sh
strata launch
strata launch pide el modelo, la cuantización, el contexto, la carpeta de almacenamiento y la configuración de acceso, descarga el motor para la tarjeta, inicia el servidor y muestra un monitor con velocidad, memoria y datos de solicitud. El endpoint predeterminado es http://127.0.0.1:8080.
Para ver qué cabe antes de una descarga de 76 GB, o para iniciar sin los prompts:
strata launch --family qwen --model q2_0 --plan      # ejecución en seco: qué falta, qué cabe
strata launch --family qwen --model q2_0 --yes --no-tui   # iniciar en segundo plano
strata launch --status
strata connect    # imprime la configuración para Claude Code / OpenCode / Hermes / OpenClaw / ...
strata launch --stop
Esos banderas --family qwen --model q2_0 son la ejecución en seco usada para la compilación ISTA Q2_0 en Ubuntu 26.04. Los paquetes de Unsloth usan --family unsloth y el nombre de la tabla anterior. strata connect imprime un bloque de proveedor por herramienta. Ambas formas de API usan una URL base compatible con OpenAI (http://127.0.0.1:8080/v1) y el nombre del modelo que imprime el lanzamiento. Cualquier cliente que acepte un endpoint personalizado compatible con OpenAI, incluido Cursor, usa ese par.
Dos configuraciones para verificar en la primera ejecución
-
Muestreo. En 0.2.11 una configuración de paquete sin un bloque
samplingsigue la tarjeta del modelo. Las solicitudes de razonamiento obtienen temperatura 1.0, top_p 0.95 y top_k 20. Las solicitudes sin razonamiento obtienen 0.7, 0.8 y 20, con presence_penalty 1.5. La precedencia es la solicitud, luego la configuración de Chat de la interfaz web, luego el bloque de configuración, luego la tarjeta. La temperatura 0 se aplica solo cuando la solicitud o el bloque la establezca, y esas ejecuciones codiciosas son las que cayeron en bucles de repetición en este punto de control. Si una configuración de paquete más antigua todavía contiene"sampling": {"temperature": 0}, reemplácela con el preset de razonamiento de la tarjeta. -
tool_call_recovery. La clave vive en la configuración de ejecución del modelo (strata-*.json). Ha estado activada por defecto desde 0.2.8, y desactivada en 0.2.7 y anteriores. Las notas del motor de Strata, citando 1,462 turnos de agente, reportan el 98.3% de las llamadas leídas como se pretendió con el interruptor y el 92.9% sin él. Acepta cuatro formas de una llamada cuyo nombre estuvo en la solicitud: una etiqueta<parameter=NAME>, JSON dentro de<tool_call>, un bloque<function=NAME>sin envoltura<tool_call>, y una segunda llamada dentro de un solo<tool_call>. Un nombre no declarado o JSON roto permanece como texto. En 0.2.7 y anteriores, establezca"tool_call_recovery": true. Deje el valor predeterminado de 0.2.11 activado para el trabajo agéntico.
Mantener el servidor en localhost
El servidor se une a localhost por defecto, y la configuración de acceso es parte de strata launch. Los endpoints exponen el modelo y la conversación en esa máquina, y no fueron construidos para una red abierta. Cuando otra máquina los necesite, coloque un proxy inverso autenticado frente al puerto.
ss -ltnp | grep :8080    # confirmar que el oyente es 127.0.0.1, no 0.0.0.0
curl -s http://127.0.0.1:8080/v1/models   # el servidor responde en localhost
Tarjetas con 13 GB de VRAM o menos
STRATA_ROUTE_PRIOR=1.5 le dice al router que prefiera expertos ya en la tarjeta. Las notas de Strata para una RTX 3060 de 12 GB ejecutando IQ3_XXS reportan +15% en decodificación de historia y +37% en decodificación de código contra el prior desactivado, y menos tareas de agente pasadas: 4.5 de 10 en promedio sobre 4 ejecuciones, contra 5.6 sobre 7 ejecuciones con el prior desactivado. La versión 0.2.7 activó 1.5 por sí solo para tarjetas discretas NVIDIA de 13 GiB o menos. La versión 0.2.8 desactivó eso el 29/10/2026, después de repeticiones y sesiones largas de agente más débiles (issue #4402). Con la variable sin establecer, 0.2.11 enruta como lo hacía 0.2.6. El proyecto apunta el prior al chat y respuestas cortas en una tarjeta de 12 GB, y lejos de ejecuciones largas de agente.
Banco de pruebas: Un escritorio de 64 GB ejecutando un agente
La caja medida:
| Componente | Especificación |
|---|---|
| CPU | Intel Core Ultra 7 265 (20 núcleos, DDR5-6400 canal doble ≈ 102 GB/s) |
| GPU | RTX 5090, 32 GB |
| RAM | 64 GB |
| SO | Ubuntu 26.04 |
| También ejecutando | Anfitrión KVM para la VM de Hermes, IDE de Cursor, navegador |
Con ISTA IQ3_XXS el fragmento residente es de 47 GB. Como los expertos están fijados, quedan aproximadamente 9 GB para todo lo demás. La VM de Hermes —el stack de agente en la configuración de producción de Hermes— más Cursor deja aproximadamente 5 GB, lo cual no es suficiente caché de páginas ni caché KV para una sesión larga de agente.
ISTA IQ3_S no cabe en esta máquina como escritorio diario. El fragmento residente de 54.8 GB más la tabla n-gram mapeada de 28.8 GB usan los 64 GB. Con Cursor ejecutándose, quedan 3 GB libres, y la VM de Hermes no tiene a dónde ir.
| Configuración | Residente | RAM libre (solo modelo) | RAM libre (modelo + VM + Cursor) | Decodificación (medida) | Veredicto agéntico |
|---|---|---|---|---|---|
| IQ3_XXS (3.00 bpw) | 47 GB | ~9 GB | ~5 GB | – | Las llamadas a herramientas fallan regularmente; no es un conductor diario |
| IQ3_S (3.50 bpw) | 54.8 GB + 28.8 GB mmap | ~3 GB (solo Cursor) | – | 100–130 tok/s | Sin margen en absoluto; no utilizable |
IQ3_S decodificó a 100–130 tokens/s, la misma clase de velocidad que una compilación de 27B en llama.cpp con MTP 3 en la comparación de MTP de Qwen 3.6. El paquete que cabe en el presupuesto de RAM (IQ3_XXS) es el que falla en el formato de llamada a herramienta. El paquete que ISTA recomienda (IQ3_S) no deja espacio para el resto del escritorio.
En IQ3_XXS el modelo emitió argumentos de llamada a herramienta mal formados, inventó nombres de herramienta que no estaban en el esquema, y reemitió el mismo comando tres a cinco veces después de un bloque de razonamiento corto. El andamiaje trata cada fallo como un reintento, por lo que la sesión se llena con el mismo error. En este hardware IQ3_XXS no es un modelo de agente.
Lo que reporta la comunidad
Informes de velocidad para Qwen3.8-Flash-Next en Strata, de hilos de issues y notas de 0.2.11:
| Configuración | Resultado |
|---|---|
| 2× RTX 4090 | 6,553 prompt t/s, 271 decode t/s en flujo único |
| RTX 5080 + 4060 Ti, 32 GB RAM | Picos de decodificación de 200+ tok/s |
| 12 GB VRAM + 32 GB RAM, expertos descargados a CPU | ~65 tok/s; un comentario en contexto 199K con KV q8: 1,740 prompt t/s, ~21.5 decode t/s |
| RTX 5070 12 GB + 64 GB RAM, IQ3_S | 85–100 tok/s decodificación |
| Pro 6000 + 2× 3090, 256 GB RAM, Unsloth 6-bit, contexto 160K | Decodificación 70–80 → 150 tok/s después de cambiar de llama-server a Strata |
| Portátil RTX 2060, 32 GB RAM + 6 GB VRAM | Q2_0 ejecutándose en absoluto |
| RTX 3060 12 GB, UD-IQ1_M, prompts cortos (notas 0.2.11) | 31–37 tok/s decodificación, 18% de expertos en la tarjeta |
Tres modos de fallo están documentados para Qwen3.8-Flash-Next de bajo bit en cargas de trabajo agénticas.
-
Emisión de llamada a herramienta dañada que sigue el tamaño del esquema. El Issue #1431 reporta que con 39 esquemas de función (aproximadamente 12K tokens) y un prompt de sistema de 6K, IQ3_XXS en Strata 0.1.40 produjo un turno utilizable en aproximadamente el 30–50% de más de 20 reproducciones controladas. El modelo o emitió una forma de llamada a herramienta que el parser no podía mapear —el texto aterrizó en
contentconfinish_reason: stop— o cerró el bloque de razonamiento y emitió fin de secuencia sin llamada ni respuesta. Los mismos pesos en llama.cpp parsearon llamadas a herramienta en todos los 8+ ejecuciones consecutivos. llama.cpp restringe la emisión con una gramática PEG y levanta el contenido dañado de vuelta atool_calls. Un envoltorio que reparó el texto después no empujó la tasa de turnos útiles por encima de esa banda del 30–50%, porque la reparación ocurre después de que los tokens ya están elegidos. -
Errores de configuración y una ruta de experto no determinista. El Issue #2685 reporta una RTX 5070, IQ3_S y 60 GB de RAM, con llamadas a herramientas fallando a través de Strata: argumentos mal formados, herramientas alucinadas y bucles de reintento, incluso después de que un bloque de muestreo y
tool_call_recoveryse activaron. La misma cuantización a través dellama servetuvo éxito en 5 de 5 ejecuciones del mismo andamiaje. El informante encontró que semillas idénticas divergían en la ruta de experto MMQ durante el prefill, y que deshabilitar esa ruta hacía que las ejecuciones fueran idénticas a nivel de bit. Strata 0.1.44 lanzó correcciones de determinismo. Los informes posteriores todavía no muestran a Strata igualando a llama.cpp en la misma cuantización. -
Llamadas a herramienta dejadas dentro del bloque de razonamiento. El Issue #804 reporta que una llamada a herramienta completa dentro de un bloque
thinkno cerrado regresa comoreasoning_content, concontentvacío y sintool_calls, y el bucle de agente se detiene. Un usuario contó aproximadamente 1 en 100 respuestas sobre aproximadamente 1,300 respuestas reales de agente, usando Hermes con IQ3_XXS, IQ2_XS y las compilaciones Coder.
Por qué el sub-Q4 rompe las llamadas a herramientas agénticas
Una llamada a herramienta debe coincidir con un formato de cable. A 3 bits este modelo de 125B falla ese formato en algunos turnos, y los fallos crecen con el contexto del esquema de herramientas. Un esquema más grande pide más de la memoria de trabajo que formatea la llamada, y el ruido de cuantización aterriza en ese formateo. Los turnos de chat lo ocultan. Los turnos de agente, que son mayormente llamadas a herramientas, no.
La misma compresión hace más daño cuando pocos parámetros están activos. La comparación de LLM local para OpenCode midió un modelo denso de 27B en IQ3_XXS con una tasa de error de aproximadamente 5% en una tarea agéntica estructurada. Los puntos de control MoE de baja actividad en anchos de bit similares fallaron más fuerte: el 35B-A3B tuvo 64.2% de errores en IQ3_S y 98.8% en IQ4_XS, y el 122B-A10B tuvo 80% de errores en IQ3_S y 90% en IQ3_XXS. Qwen3.8-Flash-Next activa 6B parámetros por token, por lo que un paquete de 3 bits se comporta como un modelo pequeño en una cuantización pesada. Esas ejecuciones de OpenCode muestran IQ3 e IQ4 fallando la tarea estructurada para el 35B-A3B y el 122B-A10B; no incluyen una ejecución Q5 de Flash-Next. El UD-IQ4_XS-v31 de Strata ha estado descargable desde 0.2.11, no tiene una comparación de tareas agénticas en las fuentes revisadas aquí, y no cabe en la caja de 64 GB.
Los mismos pesos GSQ-RCO fallan cuando se cargan en llama.cpp y en Ollama. llama.cpp todavía restringe la emisión con una gramática y puede levantar un fragmento dañado de vuelta a tool_calls, por lo que el cliente ve una llamada en lugar de una cadena rota. El modo JSON de Strata, en las notas del motor, es un prompt de esquema más una verificación después de la generación, no una decodificación restringida por gramática: un objeto malo devuelve HTTP 502 con structured_output_failed. tool_call_recovery y las versiones posteriores reparan las cuatro formas listadas arriba. No cambian la distribución desde la cual el modelo muestrea, que es por qué el envoltorio del issue #1431 no pudo subir por encima de la tasa de emisión.
Strata gasta RAM para mantener la CPU y la GPU en paso. En 64 GB, el paquete ISTA más grande que todavía deja espacio para un escritorio y una VM de agente es IQ3_XXS, y ese paquete está por debajo del umbral de emisión medido aquí. IQ3_S ya decodifica en la misma banda que un modelo de 27B con MTP 3, por lo que la limitación en ese paquete es la RAM. Una ejecución de llama.cpp con un mapa perezoso comprometería menos RAM y cedería la tasa de decodificación que hace de Strata el más rápido de los dos en este modelo.
Veredicto
Qwen 2.8 Flash Next supera a Qwen3.8-27B en puntos de referencia agénticos: DeepSWE 58.7 vs 42.2, JobBench 55.7 vs 33.4 y Toolathlon 73.5 vs 67.1. El trabajo de múltiples pasos es notablemente más competente. El cálculo por token es más cercano a un modelo pequeño que a un modelo de 125B.
Las cuantizaciones por debajo de Q4 no proporcionan una emisión fiable de llamadas a herramientas para el trabajo agéntico, fallando en tasas que producen bucles de reintento tanto en Strata como en llama.cpp. El rendimiento de Q4 no se ha demostrado aún mediante comparación controlada en puntos de referencia agénticos. Las cuantizaciones de clase Q5 son el piso demostrado para un trabajo agéntico fiable; el Unsloth UD-Q5_K_XL existe pero carece de puntos de referencia publicados.
Una Mac Studio con M5 Max y 128 GB de memoria unificada puede contener la compilación MLX de 105 GB o un paquete Q4 con margen suficiente para el stack de agente. La arquitectura de QFN fue diseñada para este modelo de descarga.
Continuaré usando en mi configuración actual un modelo NVFP4 de 27B —17 GB en la RTX 5090— con MTP 3. Está logrando 100+ tokens/s con llamadas a herramientas fiables y sin competencia de RAM. Volveré a QFN cuando una cuantización de clase Q4 sea puntuada en tareas de agente, cuando la recuperación de emisión de Strata madure, o cuando el hardware se actualice.
Referencias
- Niko1221/Strata — el motor de inferencia en este artículo. El papel OSDI 2026 de caché KV jerárquica para SGLang es un proyecto diferente con el mismo nombre.
- Notas de la versión 0.2.11 de Strata — paquetes Unsloth Dynamic v3.1, matemática Q5_0 y las velocidades de prompt corto citadas arriba.
- Notas del motor (
docs/DETAILS.md) — precedencia de muestreo,tool_call_recoveryy las mediciones del prior de ruta. - Qwen/Qwen3.8-Flash-Next — arquitectura, presets de muestreo y la tabla de puntos de referencia.
- ISTA-DASLab Qwen3.8-Flash-Next GSQ-RCO GGUFs — las compilaciones Q2 e IQ3 en el banco de pruebas.
- Issue #1431, issue #2685, issue #804 y issue #4402 — los informes de fallo en las secciones de comunidad y tarjetas pequeñas.
Enlaces útiles
- Elegir el mejor LLM para Ollama en una GPU de 16 GB de VRAM — alternativas de modelos densos cuando la tarjeta es la limitación.
- Hoja de referencia de Ollama — el otro servidor local donde los mismos GGUF pueden ser importados.
